
AI-basisprincipes
Wat is dimensionaliteitsreductie?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Dimensionaliteitsreductie stelt data voor met minder variabelen, terwijl nuttige informatie voor een taak behouden blijft. Het kan opslag en ruis verminderen, visualisatie verbeteren, redundante kenmerken beperken en downstream‑modellen gemakkelijker trainen.
Geen enkele methode behoudt elke relatie. Een nuttige reductie begint met het aangeven wat moet overleven: variantie, klassen scheiding, lokale buurten, globale geometrie, reconstructiekwaliteit of interpreteerbaarheid.
Belangrijkste conclusies
- Kenmerkenselectie behoudt de oorspronkelijke variabelen; kenmerksextractie creëert nieuwe lagere-dimensionale coördinaten.
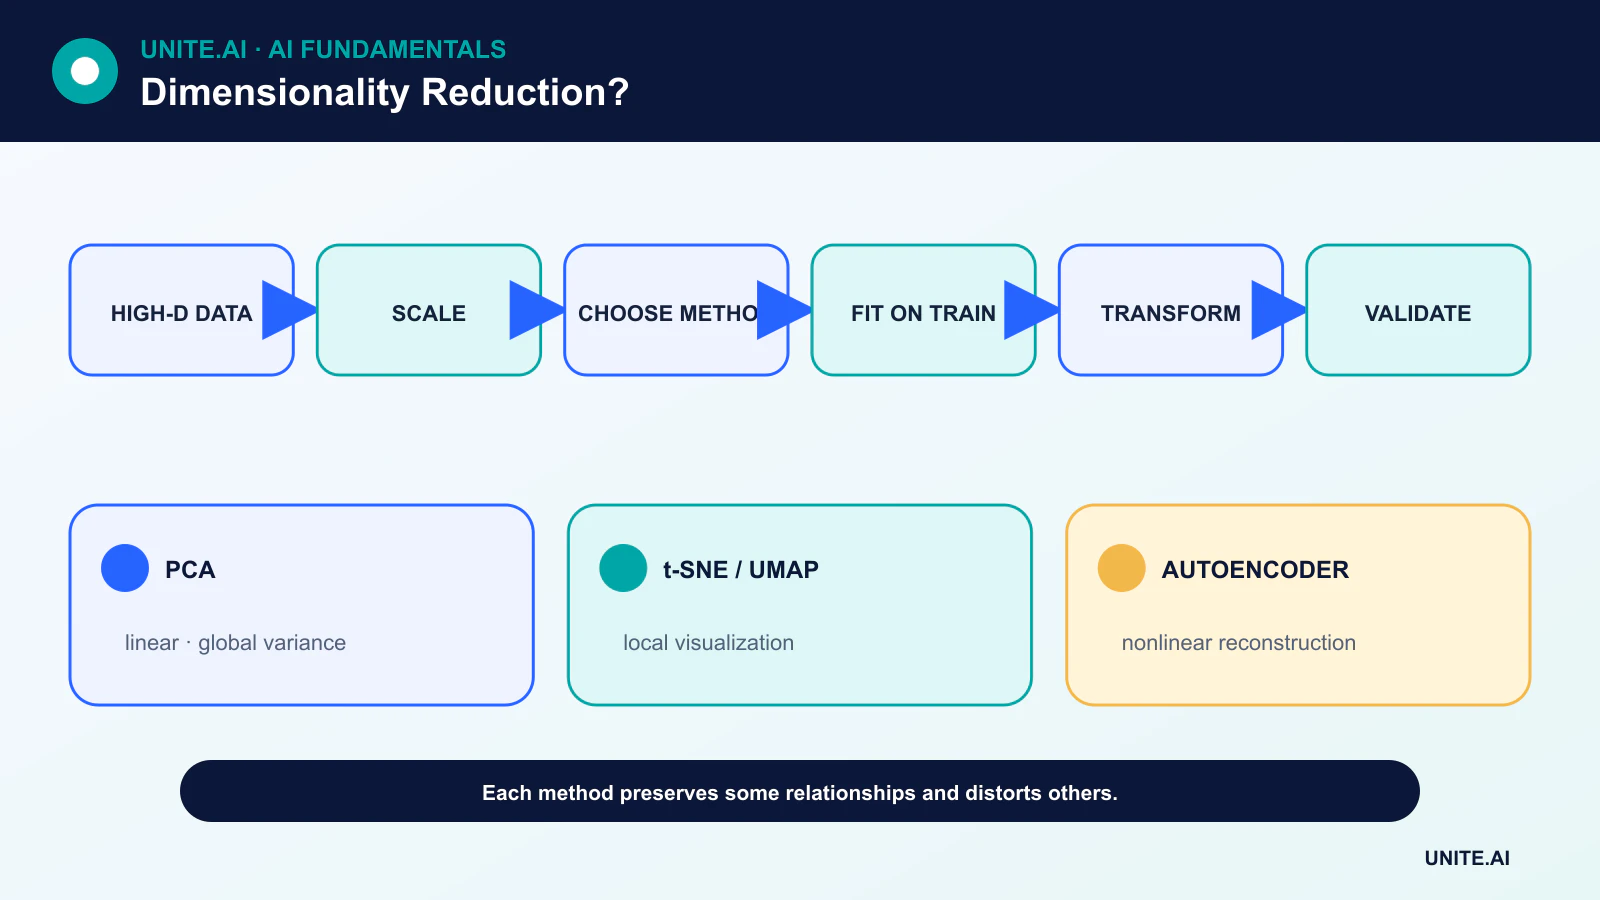
- PCA is lineair en gericht op variantie; t‑SNE en UMAP leggen de nadruk op buurstructuur voor visualisatie.
- Visualisatie‑embeddings kunnen afstanden, clustergroottes en globale scheiding vervormen.
- Pas reductie alleen toe op trainingsdata, en gebruik vervolgens de geleerde transformatie op validatie‑ en testdata.
Kenmerkenselectie versus projectie
Kenmerkenselectie verwijdert variabelen met behulp van domeinregels, ontbrekende waarden, redundantie, voorspellende tests of regularisatie. Het behoudt de oorspronkelijke betekenis, wat governance en uitleg kan ondersteunen.
Projectiemethoden combineren variabelen tot nieuwe coördinaten. Ze kunnen een gedistribueerde structuur vastleggen, maar kunnen elke coördinaat moeilijker interpreteerbaar maken. Een auto‑encoder leert een niet‑lineaire projectie via reconstructie.
PCA en SVD
Principale componentenanalyse identificeert orthogonale richtingen met afnemende variantie na het centreren van de data. Singular value decomposition biedt een gangbare numerieke benadering. Schalen is belangrijk: een meeteenheid met hoge variantie kan de componenten domineren.
PCA is deterministisch tot op teken en herhaalde eigenwaarden, ondersteunt out‑of‑sample transformatie en levert verklarende‑variantiesamenvattingen. Hoge variantie is niet altijd taak‑relevant, en lineaire componenten kunnen niet elke gekromde manifold ontvouwen.
t‑SNE en UMAP
t‑SNE bouwt kansverdelingen over buren en optimaliseert een laag-dimensionale kaart die lokale gelijkenis benadrukt. UMAP bouwt een gewogen buurgraph en optimaliseert een lagere-dimensionale representatie met gerelateerde lokale‑structuurlagen.
Beide zijn krachtige verkennende tools, maar zijn gevoelig voor preprocessing, afstandsmetriek en hyperparameters. Lege ruimte, cluster‑oppervlakte en afstand tussen clusters in een 2D‑plot mogen niet automatisch een real‑world interpretatie krijgen.
Gesuperviseerde methoden en taak‑bewuste representaties
Lineaire discriminantanalyse gebruikt klassenlabels om scheiding te zoeken, waardoor het verschilt van ongesuperviseerde PCA. Neurale representatie‑leren kan voorspellings‑ of contrastieve doelstellingen optimaliseren in plaats van reconstructie.
Als labels de reductie sturen, moeten alle fitting en afstemming binnen het trainingsproces blijven. Anders kan informatie uit de testset lekken in modelselectie en een te optimistisch resultaat opleveren.
Kiezen en valideren van een methode
Begin met preprocessing en een eenvoudige baseline. Voor compressie meet je reconstructie of downstream‑prestaties over verschillende dimensies. Voor visualisatie test je stabiliteit over random seeds en hyperparameters en vergelijk je behoud van buurstructuur met domeinkennis.
Voor productie vraag je of de methode nieuwe records kan transformeren, hoe het omgaat met ontbrekende waarden, of het verandert bij hertraining en of gebruikers originele‑kenmerk‑uitleg nodig hebben. Overfitting kan optreden in de reductiestap, net als in het uiteindelijke model.
Lineaire en niet‑lineaire reductiemethoden
Dimensionaliteitsreductie brengt hoog-dimensionale data over naar minder coördinaten, terwijl geselecteerde structuur behouden blijft. Principale componentenanalyse vindt orthogonale richtingen van maximale variantie na centreren; schalen is nodig wanneer eenheden vergelijkbaar moeten bijdragen. Singular value decomposition berekent gerelateerde low‑rank structuur en ondersteunt sparse matrices. Lineaire discriminantanalyse gebruikt labels om klassen‑scheidende richtingen te vinden. Deze methoden leveren expliciete transformaties, maar variantie of klassen‑scheiding behouden mogelijk niet de informatie die nodig is voor een downstream‑taak.
Manifold‑methoden zoals t‑SNE en UMAP construeren buurten en optimaliseren een laag-dimensionale lay-out. Ze zijn krachtig voor exploratie, maar vervormen globale afstand, dichtheid, clustergrootte en soms scheiding. Resultaten hangen af van preprocessing, metriek, buren of perplexiteit, initialisatie en seed. Een aantrekkelijke cluster in twee dimensies kan ontstaan zelfs zonder discrete groepen. Gebruik meerdere instellingen, kleur alleen op metadata die niet in de fitting is gebruikt, en valideer de schijnbare structuur in de originele ruimte of met onafhankelijke labels.
Kenmerkenselectie, embeddings en evaluatie
Kenmerkenselectie behoudt de oorspronkelijke variabelen via filters, wrappers of modelgebaseerde belangrijkheid; representatie‑leren creëert nieuwe latente kenmerken met auto‑encoders of gesuperviseerde modellen. Willekeurige projecties behouden afstanden benaderend onder bepaalde voorwaarden en bieden efficiënte baselines. Kies een methode op basis van compressie, visualisatie, ruisreductie, snelheid, opslag of modelprestaties. Pas de reducer alleen toe op trainingsdata, en transformeer vervolgens validatie‑ en testsets. Gesuperviseerde reductie moet genest zijn binnen cross‑validation om label‑lekkage te voorkomen.
Evalueer verklaarde variantie of reconstructie voor lineaire compressie, betrouwbaarheid en behoud van buurstructuur voor visualisatie, en downstream‑accuratesse, calibratie, latency en robuustheid voor voorspelling. Meet stabiliteit over monsters en seeds. Controleer of zeldzame klassen of gevoelige groepen samengevoegd worden en of inverse mapping mogelijk is. Gereduceerde coördinaten kunnen nog steeds privé‑informatie bevatten; een tweedimensionale plot is geen anonimiseringsmaatregel. Documenteer de transformatie, scaler, volgorde van kenmerken en beperkingen.
Productiegebruik
Bediening vereist de exact aangepaste transformatie en het invoerschema. Monitor ontbrekende kenmerken, verschuivingen in bereik, distributie van component‑scores, reconstructiefout en downstream‑uitkomsten. Als er nieuwe categorieën of sensoren verschijnen, hertrain en versieer de volledige pipeline in plaats van stilzwijgend kolommen toe te voegen. Reductie kan de rekencapaciteit verbeteren en een model ontdoen van ruis, maar kan ook zwakke signalen die belangrijk zijn voor zeldzame gebeurtenissen weggooien. Beschouw het als een geleerde meetstap waarvan de behouden en verloren informatie tegen de beslissing moet worden getoetst.
Voorbeeld: reductie van klant‑gedragskenmerken
Een analist standaardiseert 200 gedragsmetingen en past PCA alleen toe op trainingsklanten. Cross‑validation kiest het aantal componenten op basis van downstream‑churn‑prestaties en stabiliteit, niet op een tweedimensionale scatterplot. Loadings worden geïnspecteerd op dominante bronnen en ontbrekende waarden. PCA, kenmerkenselectie, willekeurige projectie en een ongereduceerd geregulariseerd model worden vergeleken op calibratie, latency en resultaten voor zeldzame klantsegmenten. Herhaalde monsters testen ook of de leidende componenten en downstream‑conclusies stabiel blijven.
De uitgerolde pipeline fixeert de volgorde van kenmerken, scaler en componenten en wijst ontbrekende schema‑versies af. Monitoring volgt component‑distributies, reconstructiefout en downstream‑uitkomsten. Een visualisatie met schijnbare clusters wordt gebruikt om vragen te genereren, niet om klantpersona’s toe te wijzen. Omdat latente componenten nog steeds gedrag coderen, blijven toegang en retentie gecontroleerd. Als bron‑definities wijzigen, worden de volledige transformatie en het model opnieuw opgebouwd en gevalideerd in plaats van incompatibele data in oude componenten te projecteren.
Implementatie‑bewijs en operationele gereedheid
Een productie‑beslissing vereist meer dan een succesvolle demonstratie. Definieer de beoogde gebruikers, operationele omgeving, inputs, outputs, afhankelijkheden, eigenaar en de consequentie van elke belangrijke fout. Stel een reproduceerbare baseline en een versie‑gecontroleerde evaluatieset op vóór afstemming. Test gewone gevallen, randvoorwaarden, misvormde of ontbrekende invoer, distributieverandering, afhankelijkheidsuitval, misbruik, en de groepen of omgevingen die waarschijnlijk onderbediend worden. Meet taak‑kwaliteit samen met calibratie of onzekerheid, latency, doorvoer, resource‑kosten, toegankelijkheid, privacy en beveiliging. Leg elke transformatie en drempel vast zodat een onafhankelijke reviewer het resultaat kan reproduceren en bewijs kan onderscheiden van een aantrekkelijk prototype.
Voor de lancering wijs je autoriteit toe voor release, uitzonderingen, wijzigingen, rollback en pensionering. Gebruik een gefaseerde uitrol, behoud een veilige fallback, en verifieer monitoring met opzettelijk geïnjecteerde fouten. Operationele telemetrie moet de kwaliteit van invoer, gedrag van uitvoer, model‑ of regelversie, gezondheid van afhankelijkheden, menselijke overrides en bevestigde uitkomsten onthullen zonder onnodige gevoelige gegevens te verzamelen. Definieer alarm‑drempels en een verantwoordelijke voor de respons, en beoordeel vervolgens real‑world bewijs na implementatie in plaats van aan te nemen dat offline prestaties blijven bestaan. Evalueer opnieuw wanneer gegevensbronnen, gebruikers, modellen, leveranciers, beleid, hardware of doelstellingen veranderen. Een onderhouden systeem heeft ook gedocumenteerd herstel, incident‑leren, verwijder‑ en retentieprocedures, en een duidelijk punt waarop het moet worden uitgeschakeld of vervangen nodig.
Veelgestelde vragen
Verbetert dimensionaliteitsreductie altijd een model?
Nee. Het kan voorspellende informatie weggooien of interpretatie bemoeilijken. Vergelijk met een geen‑reductie baseline op gereserveerde data.
Bewijzen gescheiden t‑SNE‑clusters dat er echte klassen bestaan?
Nee. De kaart is een geoptimaliseerde visualisatie van buurrelaties en kan schijnbare scheiding creëren. Valideer clusters met onafhankelijk bewijs.
Primaire referenties












