
AI-basisprincipes
Wat zijn Support Vector Machines?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
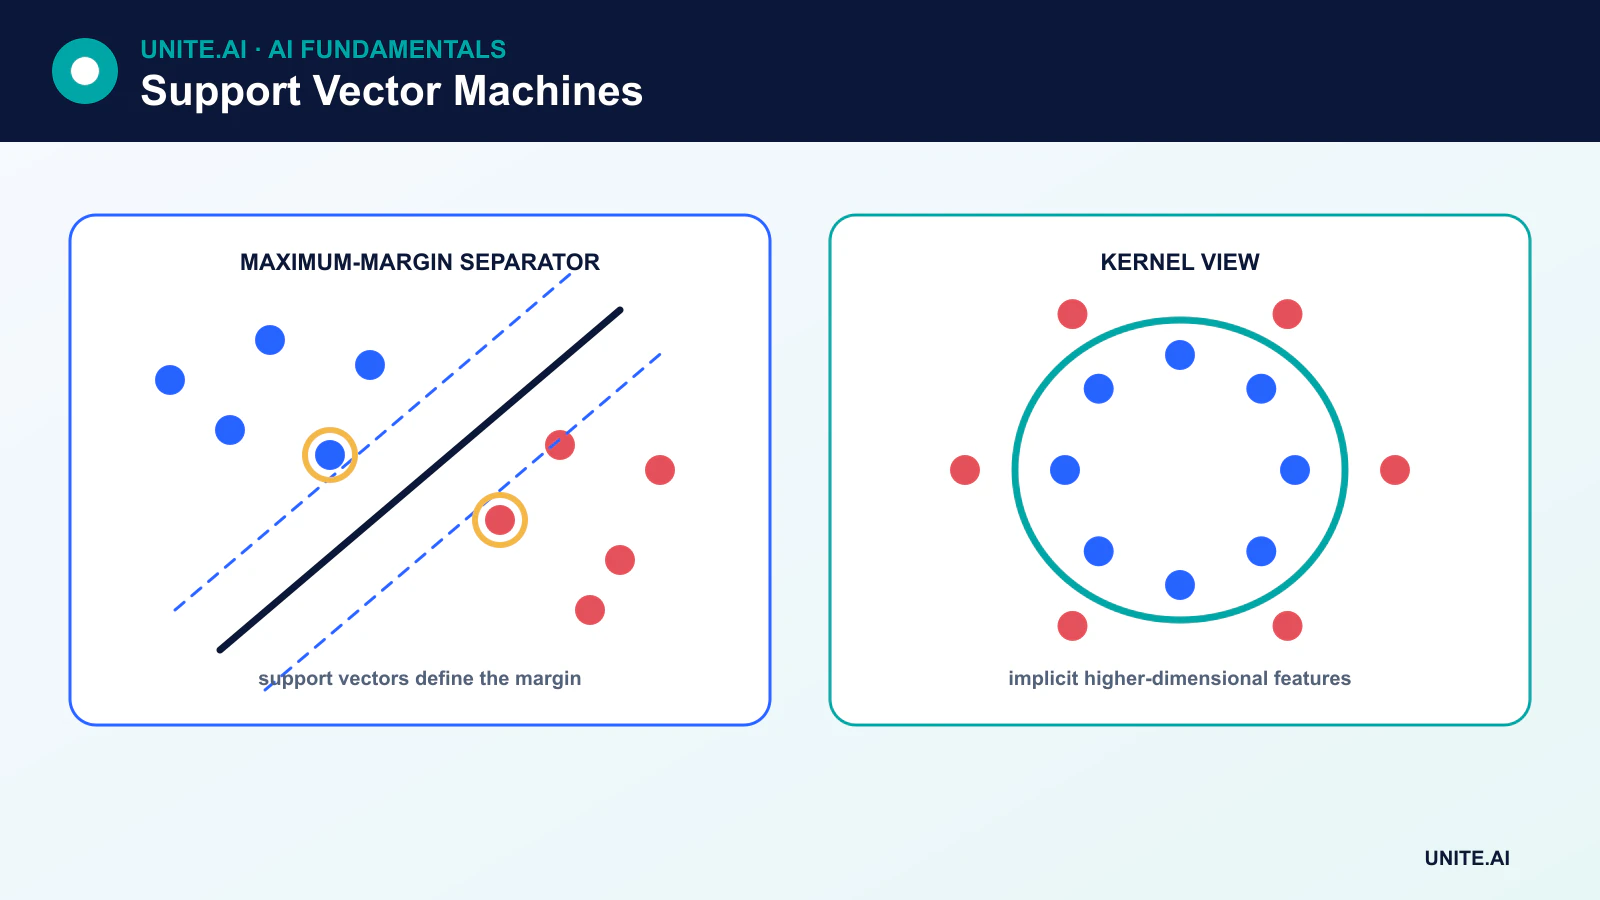
Een support vector machine (SVM) is een methode voor supervised learning die een beslissingsgrens vindt met de breedst mogelijke marge tussen klassen. De trainingsvoorbeelden die die grens bepalen zijn de support vectors.
SVM’s kunnen lineaire of niet‑lineaire classificatie, regressie en nieuwigheidsdetectie uitvoeren. Ze zijn vooral nuttig voor kleine tot middelgrote datasets met informatieve kenmerken, waaronder hoog‑dimensionale sparse data, maar hun trainingskosten kunnen onpraktisch worden bij zeer grote datasets.
Belangrijkste punten
- Een SVM maximaliseert de minimale marge tussen de grens en de dichtstbijzijnde trainingspunten.
- Support vectors zijn datapuntjes, geen extra hypervlakken.
- De parameter C balanceert de breedte van de marge tegen straffen voor overtredingen.
- Kernels berekenen de gelijkenis in een impliciete feature‑ruimte zonder expliciet elke getransformeerde feature te materialiseren.
Het maximale‑marge idee
Voor een lineaire binaire classifier is de beslissingsgrens een hypervlak:
w · x + b = 0
De vector w bepaalt de oriëntatie en b de offset. Veel hypervlakken kunnen de trainingsklassen scheiden. De SVM kiest degene die de afstand tot de dichtstbijzijnde voorbeelden aan beide zijden maximaliseert. Die dichtstbijzijnde voorbeelden zijn de support vectors en hebben de grootste invloed op de aangepaste grens.
Het doel is niet om de afstand van de grens tot elk punt afzonderlijk te maximaliseren. Het maximaliseert de minimale marge terwijl het voldoet aan of straf oplegt voor klassebeperkingen.
Harde en zachte marges
Een hard‑margin SVM vereist een perfecte lineaire scheiding en is gevoelig voor uitschieters. Werkelijke datasets hebben meestal een soft margin nodig, die slack‑variabelen introduceert voor observaties binnen de marge of aan de verkeerde kant van de grens.
De hyperparameter C regelt de straf voor deze overtredingen:
- Een grotere C straft overtredingen sterker en levert vaak een smallere marge op die de trainingsvoorbeelden nauwkeuriger volgt.
- Een kleinere C staat meer overtredingen toe in ruil voor een bredere, meer geregulariseerde marge.
Het aantal support vectors is een gevolg van de data en de oplossing; het verhogen van C garandeert geen specifiek aantal support vectors.
De kernel‑truc
Sommige klassen kunnen niet worden gescheiden met een recht hypervlak in de oorspronkelijke feature‑ruimte. Een kernel evalueert een inwendig product dat overeenkomt met een andere feature‑ruimte. Hierdoor kan de SVM een niet‑lineaire grens passen zonder expliciet elke getransformeerde coördinaat te berekenen.
Veelvoorkomende kernels omvatten:
- Linear: efficiënt voor hoog‑dimensionale sparse features zoals tekst.
- Polynomial: modelleert interacties tot een gekozen graad.
- Radial basis function (RBF): creëert flexibele lokale grenzen op basis van afstand.
- Sigmoid: lijkt op een neuronale activatie maar wordt minder vaak als standaardkeuze gebruikt.
Voor een RBF SVM regelt gamma hoe lokaal elk trainingsvoorbeeld de grens beïnvloedt. Een grote gamma kan zeer gedetailleerde regio’s creëren en overfitten; een kleine gamma levert een soepelere invloed.
Multiclass‑classificatie
Het klassieke SVM‑doel is binair. Bibliotheken breiden dit uit met strategieën zoals one-vs-rest, die één classifier per klasse traint, of one-vs-one, die classifiers voor klasseparen traint en hun beslissingen combineert. Multiclass SVM’s tekenen niet simpelweg één lijn minder dan het aantal klassen.
Support vector regressie en one‑class SVM
Support vector regressie (SVR) past een functie aan terwijl fouten binnen een epsilon‑brede buis worden genegeerd en grotere afwijkingen worden bestraft. Een one‑class SVM schat een grens rond typische data en kan nieuwigheidsdetectie ondersteunen. Een ongewoon punt is niet automatisch fraude of falen; het is ongewoon binnen de aangepaste representatie.
Praktische vereisten
SVM’s zijn afhankelijk van afstanden en inwendige producten, dus numerieke features moeten over het algemeen geschaald worden. C, kernel, gamma en klassegewichten moeten via validatie worden geselecteerd. Kansschattingen zijn niet inherent aan de marge en vereisen vaak kalibratie, wat extra kosten met zich meebrengt en apart geëvalueerd moet worden.
Kernel SVM‑training kan variëren tussen kwadratische en kubieke tijd in het aantal monsters, afhankelijk van de data en implementatie. Lineaire SVM‑varianten of stochastische lineaire modellen zijn beter geschikt voor zeer grote datasets. Voor ruwe afbeeldingen, audio of tekst kunnen geleerde representaties uit deep learning effectiever zijn, terwijl een SVM nog steeds een vaste embedding kan classificeren.
Sterktes en beperkingen van SVM
SVM’s kunnen goed presteren met veel features, bieden een duidelijk geregulariseerd doel, en hangen bij voorspelling voornamelijk af van support vectors. Beperkingen omvatten gevoeligheid voor schaling en hyperparameters, mogelijk dure training, verminderde interpreteerbaarheid bij niet‑lineaire kernels, en vereisten voor kanskalibratie.
Marges, kernels en het optimalisatie‑doel
Een support vector machine zoekt een scheidingshypervlak met een grote marge tussen klassen. Alleen support vectors op of binnen de marge bepalen de grens. Soft‑margin SVM’s introduceren slack voor overlap en verkeerd gelabelde punten; de parameter C ruilt een bredere marge in tegen trainingsovertredingen. Invoergegevens moeten meestal worden geschaald omdat afstand en dot‑product de oplossing sturen. Klassegewichten of hersampling helpen wanneer foutkosten en prevalentie ongelijk zijn, maar drempels en kansen vereisen nog steeds onafhankelijke validatie.
De kernel‑truc evalueert gelijkenis alsof invoer wordt gemapt naar een hoger‑dimensionale feature‑ruimte. Lineaire, polynomial, radial‑basis en gespecialiseerde kernels coderen verschillende aannames. Voor een RBF‑kernel regelt gamma hoe lokaal elk punt de grens beïnvloedt: een hoge gamma kan ingewikkelde regio’s creëren en overfitten, terwijl een lage gamma kan onderfitten. Kernel‑matrices groeien kwadratisch met het aantal monsters, waardoor niet‑lineaire SVM’s duur worden bij grote datasets. Lineaire oplosmethoden of benaderende feature‑maps zijn vaak beter op schaal.
Multiclass gebruik, kalibratie en operationele limieten
Binaire SVM’s worden uitgebreid naar multiclass via one‑vs‑rest, one‑vs‑one of gestructureerde formuleringen. Hyperparameters moeten binnen cross‑validatie worden afgestemd, met gegroepeerde of temporele splits waar nodig. Evalueer klassen‑specifieke precisie en recall, marge‑distributies, kalibratie en prestaties onder verschuiving. Ruwe beslisscores zijn geen kansen; Platt‑scaling of isotone kalibratie gebruikt afzonderlijke data en kan verslechteren als de prevalentie verandert. Vergelijk met logistieke regressie, bomen en moderne representatie‑gebaseerde methoden met gelijkwaardige preprocessing en afstemming.
Productie vereist de exacte scaler, feature‑volgorde, kernel‑parameters, support vectors en klasse‑mapping. De voorspellingskosten voor een kernel SVM nemen toe met het aantal support vectors, dus meet latentie en geheugen op realistische batches. Invoergegevens die ver van de trainingssupport liggen kunnen nog steeds zelfverzekerde labels krijgen; voeg out‑of‑distribution‑controles of een afwijzingsbeleid toe waar passend. Inspecteer fouten op gevoelige proxy’s en dataset‑artefacten. SVM’s blijven sterk voor middelgrote, hoog‑dimensionale problemen, maar een maximale geometrische marge bewijst geen causale structuur of veiligheid.
Voorbeeld: een SVM voor zeldzame documentroutering
Een juridisch operationeel team classificeert korte dossiers in routeringscategorieën met TF–IDF‑features en een lineaire SVM. Het splitst op zaak en tijd om te voorkomen dat sjablonen lekken, schaalt klassegewichten op basis van beoordeelde foutkosten, en stemt C af binnen geneste validatie. Het lineaire model wordt vergeleken met logistieke regressie en een transformer. Precisie, recall, kalibratie en werklast van reviewers per klasse wegen zwaarder dan de algemene nauwkeurigheid.
Beslisscores worden gekalibreerd op afzonderlijke data, en documenten met een lage marge of een niet‑ondersteunde taal gaan naar handmatige intake. Het productie‑artefact omvat tokenizer, vocabulaire, weging, model, kalibratie en label‑map. Monitoring houdt nieuwe termen, categorie‑prevalentie, marges en gecorrigeerde routes bij. Documenten en support vectors worden beschermd omdat tekstfeatures vertrouwelijke informatie kunnen blootleggen. Een niet‑lineaire kernel wordt afgewezen wanneer de kleine kwaliteitswinst de latentie, het geheugen en de interpretatie‑kosten niet rechtvaardigt.
Implementatie‑bewijs en operationele gereedheid
Een productie‑beslissing vereist meer dan een succesvolle demonstratie. Definieer de beoogde gebruikers, operationele omgeving, invoer, uitvoer, afhankelijkheden, eigenaar en de consequentie van elke belangrijke fout. Stel een reproduceerbare basislijn en een versie‑gecontroleerde evaluatieset op vóór afstemming. Test gewone gevallen, randvoorwaarden, misvormde of ontbrekende invoer, distributieverandering, afhankelijkheidsuitval, misbruik, en de groepen of omgevingen die waarschijnlijk onderbediend zijn. Meet taakkwaliteit samen met kalibratie of onzekerheid, latentie, doorvoersnelheid, resource‑kosten, toegankelijkheid, privacy en beveiliging. Leg elke transformatie en drempel vast zodat een onafhankelijke reviewer het resultaat kan reproduceren en bewijs kan onderscheiden van een aantrekkelijk prototype.
Voor de lancering moet autoriteit worden toegewezen voor releases, uitzonderingen, wijzigingen, rollback en pensionering. Gebruik een gefaseerde uitrol, behoud een veilige fallback, en verifieer monitoring met opzettelijk geïnjecteerde fouten. Operationele telemetrie moet de kwaliteit van invoer, gedrag van uitvoer, model‑ of regelversie, gezondheid van afhankelijkheden, menselijke overrides en bevestigde uitkomsten onthullen zonder onnodige gevoelige gegevens te verzamelen. Definieer alarm‑drempels en een verantwoordelijke voor de respons, en beoordeel vervolgens bewijs uit de praktijk na implementatie in plaats van aan te nemen dat offline prestaties blijven bestaan. Her‑evalueer telkens wanneer gegevensbronnen, gebruikers, modellen, leveranciers, beleidsregels, hardware of doelstellingen veranderen. Een onderhouden systeem heeft ook gedocumenteerd herstel, incident‑leren, verwijder‑ en retentieprocedures, en een duidelijk punt waarop het moet worden uitgeschakeld of vervangen nodig.
Veelgestelde vragen
Voeren SVM’s alleen classificatie uit?
Nee. Support vector regressie voorspelt continue doelvariabelen, terwijl een one‑class SVM een nieuwigheidsgrens kan schatten. Elke variant heeft een ander doel en een andere set hyperparameters.
Wanneer is een lineaire SVM een sterke keuze?
Lineaire SVM’s zijn vaak effectief voor hoog‑dimensionale sparse features, inclusief traditionele tekstrepresentaties, waar een flexibele kernel kosten zou toevoegen zonder duidelijk voordeel.
Primaire referenties












