
AI-basisprincipes
Wat is lineaire regressie?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Lineaire regressie modelleert een continue doelvariabele als een lineaire combinatie van één of meer invoerkenmerken. Het wordt gebruikt voor voorspelling, schatting en als een transparante basislijn om te begrijpen of een complexer model toegevoegde waarde biedt.
De termen onafhankelijke variabele en afhankelijke variabele beschrijven rollen in het model, niet bewezen oorzaak‑en‑gevolg. Een regressie kan een associatie identificeren, terwijl verstorende factoren, selectiebias, omgekeerde causaliteit of meetfouten de relatie verklaren.
Belangrijkste punten
- De doelvariabele y wordt gemodelleerd op basis van invoerkenmerken X; de oudere versie van het artikel verwisselde deze labels in één formule‑uitleg.
- Gewone kleinste kwadraten minimaliseert de som van de gekwadrateerde residuen.
- Diagnostiek van residuen en aannames zijn van belang voor inferentie en onzekerheid.
- Ridge‑ en lasso‑regularisatie helpen wanneer voorspellers talrijk of gecorreleerd zijn.
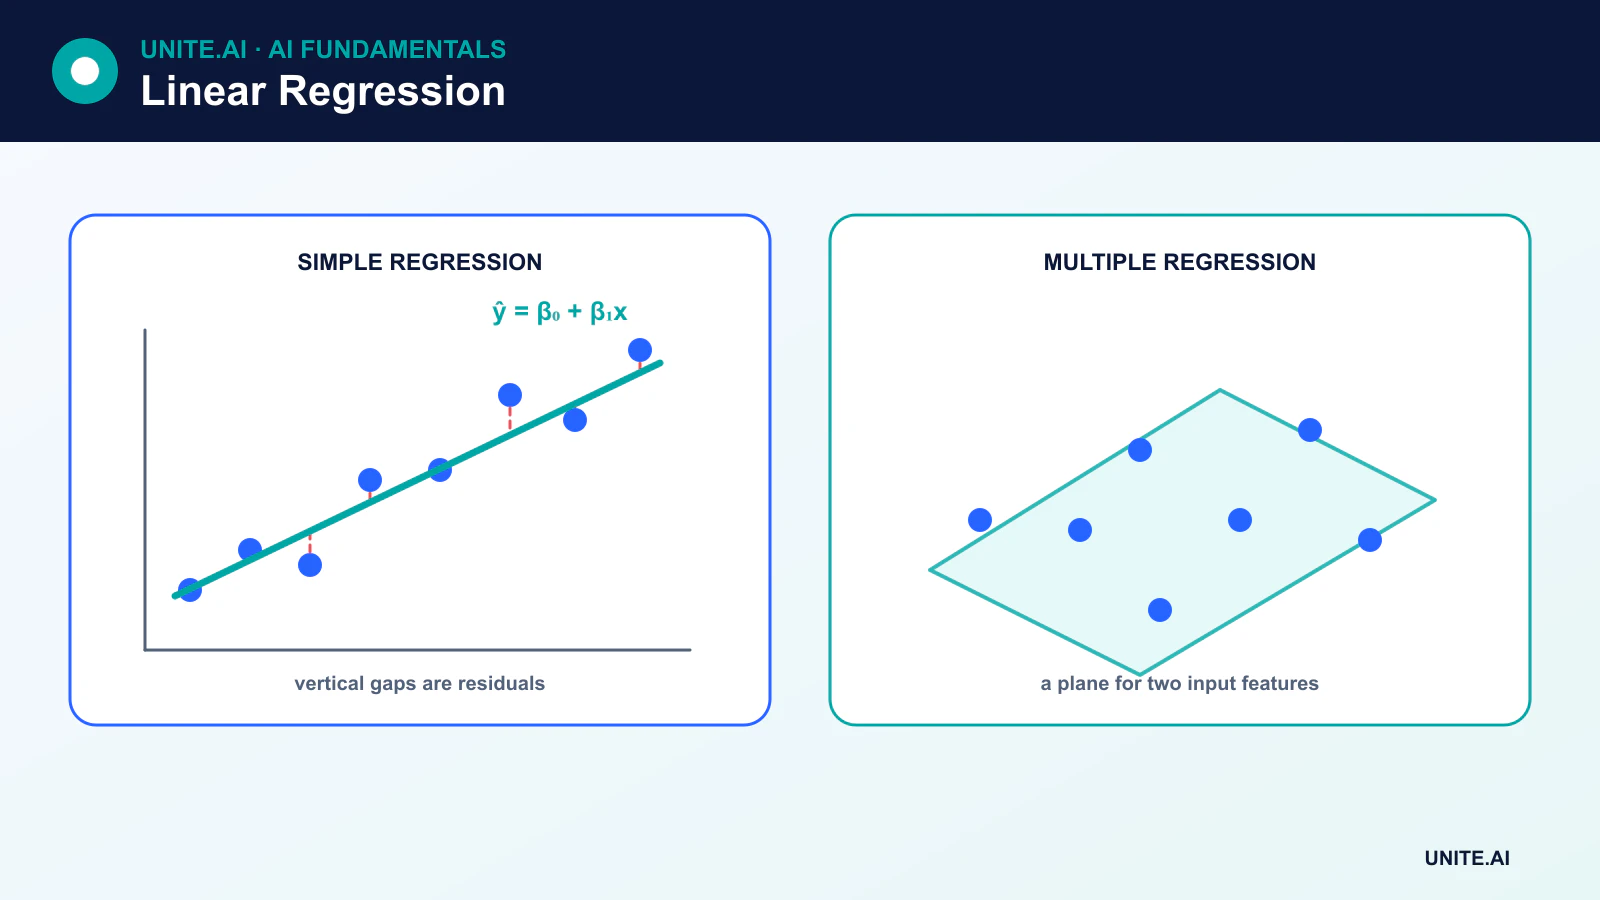
Eenvoudige lineaire regressie
Met één kenmerk is het model:
ŷ = β₀ + β₁x
β₀ is het intercept en β₁ is de helling. Het residu voor observatie i is yᵢ - ŷᵢ. Gewone kleinste kwadraten (OLS) kiest coëfficiënten die de som van de gekwadrateerde residuen minimaliseren.
De helling schat de verwachte verandering in de doelvariabele die geassocieerd is met een eenheidverandering in het kenmerk volgens het aangepaste model. Het mag niet worden beschreven als een causaal effect tenzij het onderzoeksontwerp en de aannames causale identificatie ondersteunen.
Meervoudige lineaire regressie
Met p kenmerken:
ŷ = β₀ + β₁x₁ + β₂x₂ + … + βₚxₚ
Elke coëfficiënt wordt geïnterpreteerd onder voorwaarde van de andere opgenomen kenmerken. Meervoudige regressie kan categorische variabelen opnemen via codering, polynomiale termen en interacties. Het blijft “lineair” omdat het lineair is in de coëfficiënten, zelfs als getransformeerde kenmerken zoals x² worden opgenomen.
Aannames en diagnostiek
Voor voorspelling is de kernvraag hoe goed het model generaliseert. Voor klassieke coëfficiënttests en -intervallen worden extra aannames belangrijk:
- Lineariteit: de conditionele verwachting wordt weergegeven door de gekozen lineaire vorm.
- Onafhankelijke of correct gemodelleerde fouten: herhaalde, gegroepeerde, ruimtelijke of tijdreeksobservaties kunnen een andere foutstructuur vereisen.
- Constante foutvariantie: heteroscedasticiteit beïnvloedt standaardfouten en onzekerheidsinschattingen.
- Beperkte multicollineariteit: sterk gecorreleerde voorspellers maken individuele coëfficiënten onstabiel.
- Residuele verdeling: normaliteit is relevant voor sommige inferenties met kleine steekproeven, geen vereiste dat elk kenmerk normaal verdeeld is.
Residuele plotten, leverage‑ en invloedmetingen, en domeinreview kunnen uitschieters, niet‑lineariteit, variatieverandering of observaties die de fit domineren identificeren.
Evaluatie van voorspellingen
- Mean absolute error (MAE) geeft het gemiddelde van de absolute residugrootte.
- Mean squared error (MSE) weegt grotere fouten zwaarder.
- Root mean squared error (RMSE) brengt de gekwadrateerde fout terug naar de eenheden van de doelvariabele.
- R² vergelijkt de residuele variatie met een constante basislijn op de geëvalueerde data.
R² is geen nauwkeurigheid, stelt geen causaliteit vast en kan negatief zijn op een testset. Validatie moet overeenkomen met de werkelijke voorspellingssituatie, inclusief tijd‑ of groepsbewuste splits wanneer nodig.
Ridge-, lasso- en elastic net
Ridge‑regressie voegt een L2‑straffen toe die coëfficiënten verkleint en gecorreleerde voorspellers stabiliseert. Lasso voegt een L1‑straffen toe en kan coëfficiënten op nul zetten. Elastic net combineert beide. Kenmerken moeten meestal compatibel geschaald worden voordat deze straffen worden vergeleken.
Regularisatie introduceert bias in ruil voor lagere variantie en kan overfitting verminderen. De sterkte van de straf wordt gekozen met validatie, niet met de uiteindelijke testset.
Wanneer lineaire regressie niet geschikt is
Een lineair model kan falen wanneer relaties sterk niet‑lineair zijn, fouten afhangen van eerdere waarden, doelverdelingen gespecialiseerde modellering vereisen, of enkele uitschieters de kwadratische verliesfunctie domineren. Decision trees, gegeneraliseerde lineaire modellen, tijdreeksmodellen, robuuste regressie of niet‑lineaire methoden kunnen beter passen.
Zelfs wanneer een complex model wint, blijft lineaire regressie een waardevolle basislijn. Als een groot systeem het niet consistent kan overtreffen, is de extra complexiteit mogelijk niet gerechtvaardigd.
Modelaannames, schatting en diagnostiek
Lineaire regressie modelleert de conditionele verwachting van een numerieke uitkomst als een intercept plus gewogen voorspellers. Gewone kleinste kwadraten kiest coëfficiënten die de gekwadrateerde residuen minimaliseren. Coëfficiënten beschrijven de verwachte verandering in de uitkomst bij een eenheidverandering van een voorspeller, terwijl andere opgenomen variabelen constant worden gehouden, volgens het gespecificeerde model. Dit is een associatie tenzij aannames voor causale identificatie en het onderzoeksontwerp meer rechtvaardigen. Eenheden, codering, transformaties, interacties en referentiecategorieën bepalen de interpretatie, dus coëfficiënten zonder een datadictionary zijn onvolledig.
Klassieke inferentie berust op aannames over de functionele vorm, onafhankelijke fouten, constante variantie en foutverdeling voor specifieke tests en intervallen. Residueel‑tegen‑voorspelde plotten onthullen niet‑lineariteit of heteroscedasticiteit; Q–Q‑plotten beoordelen het staartgedrag; leverage‑ en invloeddiagnostiek identificeren observaties die de schattingen sterk beïnvloeden. Gecorreleerde voorspellers vergroten de onzekerheid en maken individuele coëfficiënten onstabiel, zelfs wanneer voorspellingen adequaat blijven. Robuuste standaardfouten, transformaties, splines, hiërarchische structuren of een ander model kunnen nodig zijn in plaats van ongemakkelijke datapunten te verwijderen.
Regularisatie, evaluatie en verantwoord gebruik
Ridge‑regressie verkleint coëfficiënten met een L2‑straffen, terwijl lasso sommige op nul kan zetten met een L1‑straffen; elastic net combineert beide. Standaardiseer voorspellers wanneer de schaal van de straf vergelijkbaar moet zijn en kies de sterkte met validatie of cross‑validatie. Evalueer mean absolute error, root mean squared error, residuele verdeling, calibratie over bereiken en onzekerheid, met tijd‑ of groepsplits die het gebruik weerspiegelen. Vergelijk met een gemiddelde basislijn en niet‑lineaire alternatieven, maar behoud lineaire modellen wanneer transparantie en stabiliteit waardevol zijn.
Extrapolatie buiten het waargenomen bereik van voorspellers volgt de aangepaste lijn zonder bewijs en kan riskant zijn. Houd kenmerkbereiken, missende waarden, residuen en subgroep‑fouten in productie in de gaten. Predictie‑intervallen beschrijven de onzekerheid van individuele uitkomsten en zijn breder dan betrouwbaarheidsintervallen voor het gemiddelde; beide vereisen aannames. Vermijd het controleren voor variabelen die causale bias introduceren wanneer het doel effectschatting is. Lineaire regressie is een nauwkeurig instrument voor een gedefinieerde relatie, geen universele garantie dat de wereld lineair is of dat een coëfficiënt een interventie vertegenwoordigt.
Voorbeeld: schatten van levertijd
Een logistiek team modelleert de levertijd op basis van afstand, serviceniveau, regio, weekdag en bekende weersomstandigheden. Het inspecteert niet‑lineaire residuele patronen en voegt gerechtvaardigde splines en interacties toe in plaats van een lineaire vergelijking letterlijk als natuurkunde te behandelen. Carrier‑ en route‑groepen definiëren validatiefolds. Mean absolute error, tail error, interval coverage en systematische bias worden gerapporteerd. Geannuleerde leveringen en gegevens die na aankomst zijn vastgelegd, worden uitgesloten of expliciet gemodelleerd.
Coëfficiënten worden gedocumenteerd in eenheden en gecontroleerd op instabiliteit bij gecorreleerde voorspellers. Het model weigert extrapolatie buiten gevalideerde afstands‑ en regiobereiken. Predictie‑intervallen vergezellen de schattingen, en downstream planning maakt gebruik van hun onzekerheid. Monitoring volgt kenmerkbereiken, residuen, intervaldekking en bias na netwerkveranderingen. Een causale claim over carrier of weer wordt niet gemaakt op basis van voorspellende coëfficiënten; operationele experimenten of sterkere identificatie zouden nodig zijn om interventie te ondersteunen.
Bewijs van implementatie en operationele gereedheid
Een productie‑beslissing vereist meer dan een succesvolle demonstratie. Definieer de beoogde gebruikers, operationele omgeving, invoer, uitvoer, afhankelijkheden, eigenaar en de consequentie van elke belangrijke fout. Stel een reproduceerbare basislijn en een versie‑gecontroleerde evaluatieset vast vóór afstemming. Test gewone gevallen, randvoorwaarden, slecht gevormde of ontbrekende invoer, distributieverschuiving, uitval van afhankelijkheden, misbruik, en de groepen of omgevingen die het meest onderbediend zijn. Meet taakkwaliteit samen met calibratie of onzekerheid, latentie, doorvoer, resource‑kosten, toegankelijkheid, privacy en beveiliging. Leg elke transformatie en drempel vast zodat een onafhankelijke reviewer het resultaat kan reproduceren en bewijs kan onderscheiden van een aantrekkelijk prototype.
Voor de lancering moet autoriteit voor release, uitzonderingen, wijzigingen, rollback en pensionering worden toegewezen. Gebruik een gefaseerde uitrol, behoud een veilige fallback, en verifieer monitoring met opzettelijk geïnjecteerde storingen. Operationele telemetrie moet de kwaliteit van invoer, gedrag van uitvoer, model‑ of regelversie, gezondheid van afhankelijkheden, menselijke overrides en bevestigde uitkomsten onthullen zonder onnodige gevoelige gegevens te verzamelen. Definieer alarmdrempels en een verantwoordelijke voor de respons, en beoordeel vervolgens bewijs uit de praktijk na implementatie in plaats van aan te nemen dat offline prestaties blijven bestaan. Her‑evalueer wanneer gegevensbronnen, gebruikers, modellen, leveranciers, beleidsregels, hardware of doelstellingen veranderen. Een onderhouden systeem heeft ook gedocumenteerd herstel, incident‑leren, verwijder‑ en retentieverfahren, en een duidelijk punt waarop het moet worden uitgeschakeld of vervangen nodig.
Veelgestelde vragen
Vereist lineaire regressie slechts één invoervariabele?
Nee. Eenvoudige regressie heeft één voorspeller, terwijl meervoudige lineaire regressie veel numerieke, gecodeerde categorische, getransformeerde en interactie‑kenmerken kan gebruiken.
Kan lineaire regressie causaliteit aantonen?
Nee. Causale interpretatie vereist een verdedigbaar onderzoeksontwerp en aannames over verstorende factoren, selectie, meting en interventie. Een voorspellende coëfficiënt alleen beschrijft een associatie in het aangepaste model.
Primaire referenties












