AI-basisprincipes
Wat is Data Science?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Data science is de praktijk van het omzetten van data in verdedigbare kennis, voorspellingen of beslissingen. Het combineert domeinspecialisatie, statistiek, informatica, data‑engineering, visualisatie en communicatie. Een model kan onderdeel van het werk zijn, maar de discipline begint vóór het modelleren en gaat door na de implementatie.
De belangrijkste vraag is niet “Welk algoritme moeten we gebruiken?” maar “Welke beslissing ondersteunen we, welk bewijs beantwoordt die beslissing, en hoe weten we dat het resultaat bruikbaar blijft?”
Belangrijkste inzichten
- Data science is een end‑to‑end evidentiële workflow, geen synoniem voor machine learning.
- Probleemdefinitie, meting en data‑governance bepalen vaak het succes meer dan modelcomplexiteit.
- Predictieve en causale vragen vereisen verschillende aannames en evaluatie‑ontwerpen.
- Een geïmplementeerde analyse heeft monitoring, documentatie en communicatie nodig die passen bij de gebruikers.
Begin met een beslissing en een estimand
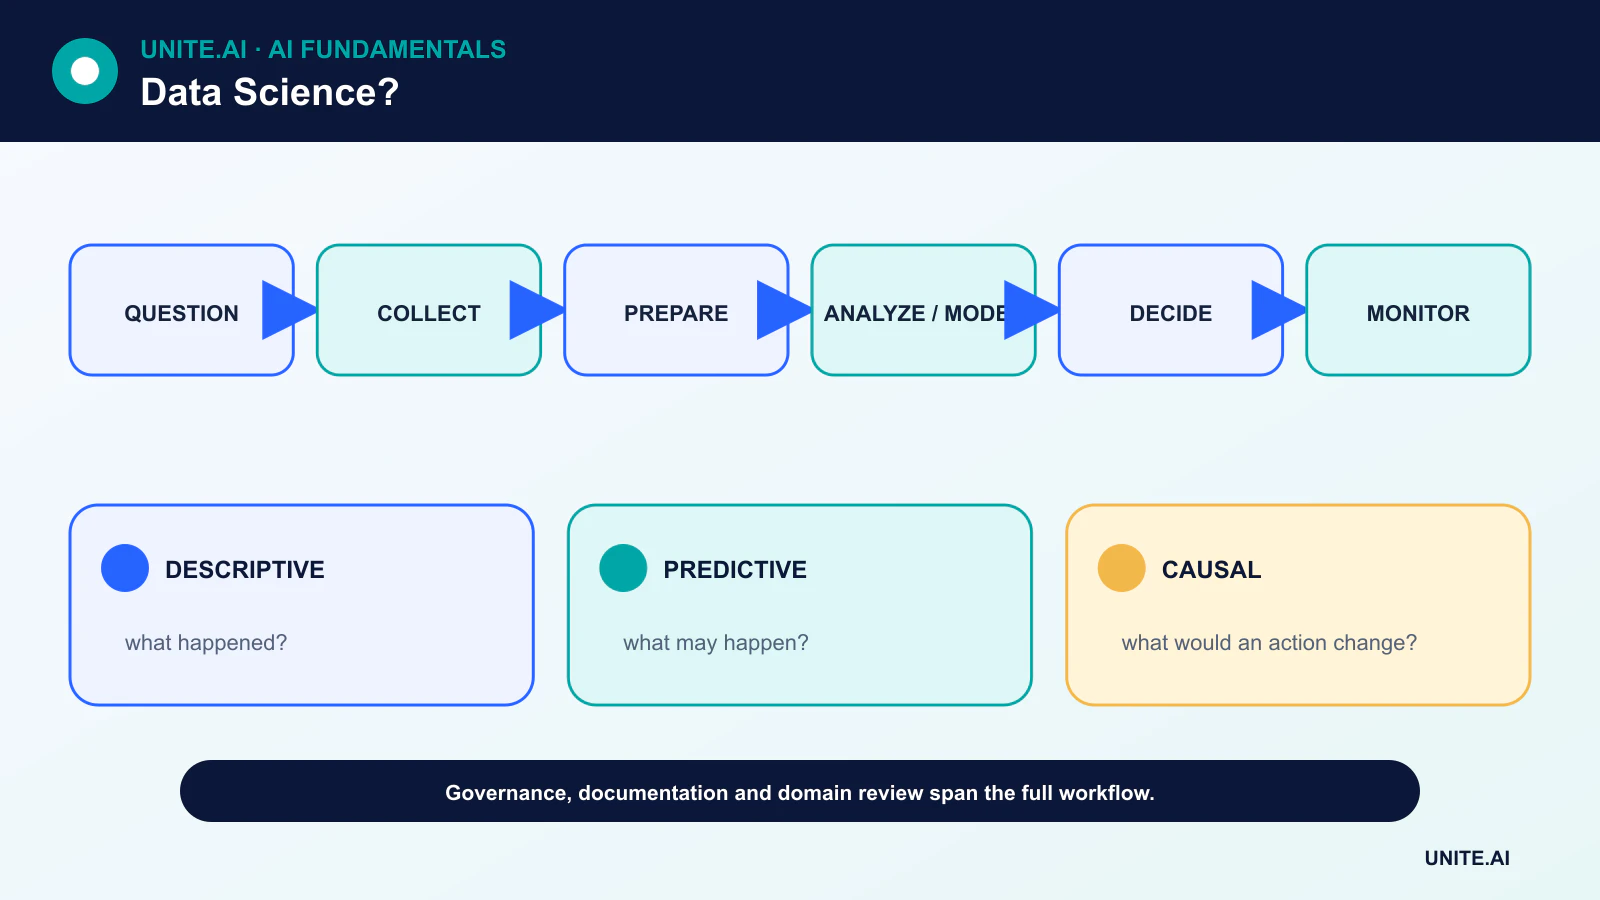
Een project moet de gebruiker, beslissing, interventie en foutkosten identificeren. Voor een beschrijvende vraag kan het doel een percentage of trend zijn. Voor een voorspelling kan toekomstige vraag of risico zijn. Voor een causale vraag beschrijft de estimand het effect van een gedefinieerde interventie onder gespecificeerde aannames.
Vage doelen zoals “inzichten vinden” maken evaluatie onmogelijk. Een meetbaar doel schept een grens voor dataverzameling en voorkomt dat de analyse zich uitbreidt naar elk beschikbaar veld.
Verzamel, beheer en begrijp data
Teams inventariseren bronnen, eigendom, toestemming, retentie, herkomst en toegang. Ze onderscheiden gestructureerde en ongestructureerde data, definiëren eenheden en tijdstempels, en onderzoeken of records de populatie en de tijdsperiode van belang vertegenwoordigen.
Opschonen is niet alleen het verwijderen van ontbrekende rijen. Het omvat het oplossen van duplicaten, onmogelijke waarden, label‑ambiguïteit, schema‑drift, censurering en joins die de analyseeenheid wijzigen. Elke transformatie moet reproduceerbaar en gedocumenteerd zijn.
Verken vóór modellering
Exploratieve analyse bestudeert verdelingen, ontbrekende waarden, relaties en mogelijke meetartefacten. Visualisatie kan uitschieters en subgroepverschillen blootleggen die een samenvattend gemiddelde verbergt. Verkenning moet hypotheses informeren zonder verward te worden met bevestigend bewijs.
Feature‑engineering, dimensionaliteitsreductie en representatieleren kunnen modellering verbeteren, maar transformaties moeten alleen op trainingsdata worden getraind om lekken te voorkomen.
Kies methoden voor de vraag
Statistische schatting kwantificeert onzekerheid rond de interesserende grootheden. Machine learning is nuttig wanneer het primaire doel voorspellende prestaties op nieuwe data is. Experimenten en methoden voor causale inferentie zijn vereist wanneer het doel een interventie‑effect is.
Een baseline moet eenvoudig genoeg zijn om te begrijpen. Complexere modellen moeten hun extra kosten rechtvaardigen door betere prestaties op een hold‑out set, gekalibreerde onzekerheid, operationele waarde of een noodzakelijke capaciteit zoals beeld‑ of taalverwerking.
Evalueer, communiceer en monitor
Evaluatie moet aansluiten bij de beslissing. Een classifier kan precisie, recall, calibratie en subgroepanalyse vereisen in plaats van alleen nauwkeurigheid; een voorspellingssysteem heeft tijd‑bewuste backtesting nodig. Overfitting en lekken zijn procesfouten, niet alleen model‑eigenschappen.
Communicatie omvat aannames, onzekerheid, beperkingen en aanbevolen acties. Zodra een model of dashboard wordt gebruikt, monitoren teams de kwaliteit van input, drift van uitkomsten, gebruikersgedrag en downstream‑impact. Een beëindigd besluitvormingsproces heeft een archief en duidelijke eigendom nodig, net zoals een geïmplementeerde proces een operator vereist.
De data‑science levenscyclus en analytische vragen
Data science combineert domeinkennis, statistiek, informatica en communicatie om data om te zetten in bewijs voor beslissingen. Begin met het onderscheiden van beschrijving, diagnose, voorspelling en causale inferentie. Een dashboard dat rapporteert wat er gebeurd is, een model dat voorspelt wie zal churnen, en een experiment dat schat of een interventie churn beïnvloedt, beantwoorden verschillende vragen. Definieer de eenheid, populatie, tijdsvenster, uitkomst, actie en foutkosten voordat data worden geëxtraheerd. Veel mislukte projecten lossen een meetbare proxy op die de beoogde beslissing niet kan ondersteunen.
Acquisitie vereist herkomst, permissies, steekproefontwerp en een datacontract. Verkenning controleert verdelingen, ontbrekende waarden, duplicaten, uitschieters, relaties, meetveranderingen en mogelijke lekken. Opschoningskeuzes zijn analytische aannames: het verwijderen van ontbrekende rijen, imputeren van waarden, of het begrenzen van uitschieters kan de populatie en conclusie wijzigen. Versioneer ruwe data onveranderlijk en transformaties als code, en maak een data‑dictionary met eenheden en betekenis. Splits evaluatiedata vóór het leren van transformaties of het herhaaldelijk testen van hypotheses.
Modellering, inferentie en reproduceerbaarheid
Statistische inferentie kwantificeert onzekerheid onder aannames; voorspellende modellering schat out‑of‑sample prestaties; causale analyse vereist identificatie via ontwerp of verdedigbare aannames. Kies methoden die passen bij de vraag en het data‑genererende proces. Vergelijk met eenvoudige baselines, gebruik gegroepeerde of tijd‑bewuste validatie, en rapporteer onzekerheid en sensitiviteit. Een hoge correlatie of feature‑importance bewijst geen causaliteit. Meervoudige testing, onderzoeksvrijheid en selectieve rapportage kunnen overtuigende patronen fabriceren, dus preregistratie of een duidelijk gescheiden bevestigende fase kan helpen.
Reproduceerbaarheid omvat code, omgeving, datasnapshot, random seeds, query‑definities en een overzicht van handmatige beslissingen. Geautomatiseerde tests moeten schema’s, bedrijfsinvarianten, transformaties en metriek dekken. Notebooks zijn waardevol voor verkenning, maar productie‑werk vereist modulaire, controleerbare pipelines. Peer review moet aannames, lekken, doelvaliditeit en de generaliseerbaarheid van resultaten uitdagen. Communiceer effectgroottes, onzekerheid, beperkingen en tegenbewijs in plaats van alleen statistische significantie of een modelscore.
Implementatie en impact op beslissingen
Als analyse een terugkerend proces aandrijft, wijs eigenaars toe, monitor de versheid van data en de kwaliteit van uitkomsten, en definieer rollback of pensionering. Bescherm persoonlijke en vertrouwelijke informatie via minimalisatie, toegangscontrole, retentie en veilige outputs. Evalueer subgroep‑effecten en hoe gebruikers reageren op het model; feedback‑loops kunnen toekomstige data veranderen. Meet of de beslissing het echte doel heeft verbeterd, niet alleen of een model is geïmplementeerd. Data science is succesvol wanneer bewijs actie betrouwbaar en transparant verandert – niet wanneer een organisatie dashboards, functies of experimenten ophoopt zonder eigenaarschap.
Voorbeeld: meten van een retentie‑interventie
Een productteam observeert lagere retentie en definieert een actieve gebruiker, cohort, venster, uitsluitingen en beslissing. Analisten controleren instrumentatie, ontbrekende events en acquisitiemix vóór modellering. Beschrijvende cohorten identificeren waar de daling plaatsvindt, een voorspellend model prioriteert onderzoeksparticipanten, en een gerandomiseerd onboarding‑experiment schat of de voorgestelde wijziging de retentie verbetert. Dit zijn drie afzonderlijke analyses met verschillende aannames en outputs.
Het notebook, de queries, de datasnapshot, de metriekdefinitie en het experimentplan zijn geversioneerd en peer‑reviewed. Resultaten rapporteren effectgrootte en onzekerheid met waarborgen voor ondersteuningsvraag en toegankelijkheid. Een dashboard monitort het experiment maar vervangt de vooraf gedeclareerde analyse niet. Als de interventie slaagt, blijft de uitrol gefaseerd en controleert men het gedrag op lange termijn. Het werk wordt alleen als waardevol beschouwd als het een reproduceerbare beslissing ondersteunt, niet omdat er een complex model of visueel aansprekende grafiek is geproduceerd.
Implementatie‑bewijs en operationele gereedheid
Een productie‑beslissing vereist meer dan een succesvolle demonstratie. Definieer de beoogde gebruikers, operationele omgeving, inputs, outputs, afhankelijkheden, eigenaar en de consequentie van elke belangrijke fout. Stel een reproduceerbare baseline en een geversioneerde evaluatieset vast vóór afstemming. Test gewone gevallen, randvoorwaarden, slecht gevormde of ontbrekende input, distributieverandering, afhankelijkheidsuitval, misbruik, en de groepen of omgevingen die waarschijnlijk onderbediend worden. Meet de taakkwaliteit samen met calibratie of onzekerheid, latentie, doorvoersnelheid, resource‑kosten, toegankelijkheid, privacy en beveiliging. Leg elke transformatie en drempel vast zodat een onafhankelijke reviewer het resultaat kan reproduceren en bewijs kan onderscheiden van een aantrekkelijk prototype.
Voor de lancering wijs autoriteit toe voor release, uitzonderingen, wijzigingen, rollback en pensionering. Gebruik een gefaseerde uitrol, behoud een veilige fallback, en verifieer monitoring met opzettelijk ingevoerde fouten. Operationele telemetrie moet inputkwaliteit, outputgedrag, model‑ of regelversie, afhankelijkheidsstatus, menselijke overrides en bevestigde uitkomsten onthullen zonder onnodige gevoelige data te verzamelen. Definieer alarmdrempels en een verantwoordelijke, en beoordeel vervolgens bewijsmateriaal uit de praktijk na implementatie in plaats van aan te nemen dat offline prestaties aanhouden. Her‑evalueer telkens wanneer datasources, gebruikers, modellen, leveranciers, beleid, hardware of doelstellingen veranderen. Een onderhouden systeem heeft ook gedocumenteerd herstel, incident‑leren, verwijder‑ en retentieprocedures nodig, en een duidelijk punt waarop het moet worden uitgeschakeld of vervangen.
Veelgestelde vragen
Is data science hetzelfde als data‑analytics?
De termen overlappen. Data science omvat vaak het bouwen van dataproducten en voorspellende systemen, terwijl analytics zich meer kan richten op beschrijvende en diagnostische besluitondersteuning. Het gebruik varieert per organisatie.
Heeft elk data‑science project AI nodig?
Nee. Een goed ontworpen query, grafiek, experiment of statistische schatting kan nuttiger en betrouwbaarder zijn dan een complex model.
Primaire referenties