
AI-basisprincipes
Wat is een Data Warehouse? Architectuur, ETL en Toepassingsgevallen

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Een datawarehouse is een analytisch datasysteem dat informatie van operationele bronnen integreert en organiseert voor rapportage, business intelligence en herhaalbare analyses. Het scheidt veel analytische workloads van de applicaties die transacties registreren.
Moderne warehouses kunnen kolomgebaseerd, gedistribueerd, serverless of gekoppeld aan objectopslag zijn. Het bepalende werk blijft consistent: beheerde ingestie, gemodelleerde betekenis, historie, query‑prestaties, beveiliging, kwaliteit en betrouwbare levering aan gebruikers.
Belangrijkste punten
- Operationele systemen optimaliseren huidige transacties; warehouses optimaliseren historische analyses over verschillende bronnen.
- ETL transformeert vóór het laden, terwijl ELT eerst laadt en transformeert binnen het analytische platform.
- Dimensionale, genormaliseerde en brede‑tabelmodellen dienen verschillende workloads en governance‑behoeften.
- Vertrouwen hangt af van lineage, tests, versheid, toegangscontrole, semantische definities en kostenmonitoring.
Bronnen, ingestie en opslag
Data kan binnenkomen via batches, change‑data capture, streams, bestanden en API's. Een landingslaag behoudt de broncontext; transformaties standaardiseren types, verwijderen duplicaten, behandelen late gebeurtenissen en creëren herbruikbare analytische entiteiten.
Dit breidt de ETL-workflow uit. ELT gebruikt de rekencapaciteit van het warehouse voor transformatie, terwijl ETL data kan reduceren of valideren vóór het laden. De juiste keuze hangt af van latency, privacy, schaal en toolchain.
Modelleer data voor vragen
Dimensionale modellen organiseren meetbare feiten rond beschrijvende dimensies zoals klant, product en tijd. Genormaliseerde kernmodellen kunnen bedrijfsrelaties behouden, terwijl gedenormaliseerde marts veelvoorkomende queries vereenvoudigen.
Een semantische laag biedt metrische definities die consistent zijn. Zonder deze kunnen teams verschillende, ogenschijnlijk valide omzet‑ of retentiecijfers produceren uit dezelfde rijen. Structured data vereist nog steeds een overeengekomen betekenis.
Warehouse, lake en lakehouse
Een data lake slaat doorgaans bestanden en diverse ruwe of verwerkte data op in objectopslag. Een warehouse levert beheerde analytische tabellen en query‑services. Lakehouse‑ontwerpen voegen tabelmetadata, transacties en governance toe aan lake‑opslag.
Dit zijn architecturale patronen, geen garanties. Organisaties combineren ze vaak via een data fabric of gedeelde governance‑laag. Werkbelasting, vaardigheden, interoperabiliteit en levenscycluskosten zijn belangrijker dan het label.
Kwaliteit, beveiliging en operaties
Definieer eigenaren, contracten, versheidsdoelen, lineage, tests, retentie en rij‑ of kolom‑toegang. Scheid persoonlijk identificeerbare gegevens, gebruik het principe van minste privilege en audit gevoelige queries. Backfills en schema‑wijzigingen vereisen gecontroleerde, observeerbare procedures.
Meet succesvolle refreshes, datavertraging, test‑fouten, query‑prestaties, adoptie, incidentimpact en kosten per workload. Een warehouse is nuttig wanneer mensen een metriek kunnen terugvoeren naar beheerde data en het resultaat kunnen reproduceren.
Dimensioneel modelleren en semantiek
Een feitentabel registreert gebeurtenissen of periodieke metingen op een aangegeven granulariteit, zoals één orderregel of één apparaat per uur. Dimensies bieden beschrijvende context. Het definiëren van de granulariteit vóór het selecteren van kolommen voorkomt het mengen van niveaus die tot dubbel tellen leiden. Additieve maten kunnen over alle dimensies worden opgeteld; semi‑additieve maten vereisen zorgvuldigheid over tijd.
Surrogate‑sleutels ontkoppelen de warehouse‑historie van veranderende bron‑identifiers. Slowly changing dimensions bepalen hoe attribuutwijzigingen worden afgehandeld: overschrijven, een nieuwe historische rij behouden, of beperkte eerdere waarden behouden. De juiste methode volgt de analytische vraag en retentie‑verplichtingen.
Een semantische metriek moet formule, filters, tijdsgedrag, valuta, uitsluitingen, eigenaar en tests definiëren. Centrale definities verminderen inconsistentie, maar governance moet voorgestelde wijzigingen en versiebeheer toestaan. Een enkele semantische laag wordt een knelpunt als gebruikers deze niet verantwoord kunnen inspecteren of uitbreiden.
Moderne opslag- en query‑architectuur
Kolomgebaseerde opslag houdt de waarden van een kolom samen, wat compressie verbetert en alleen benodigde velden scant. Partitionering snoeit grote secties op datum of een andere sleutel; clustering plaatst gerelateerde waarden naast elkaar; materialized views en caches hergebruiken resultaten. Slechte partitie‑keuzes leiden tot kleine bestanden, scheefheid of dure volledige scans.
Massively parallel query‑engines verdelen scans, joins en aggregaties over workers. Dataverplaatsing tijdens joins kan de uitvoeringstijd domineren, dus distributie, statistieken en join‑volgorde zijn belangrijk. Autoscaling en serverless services vereenvoudigen capaciteit, maar vereisen kostenbeheersing, workload‑prioriteiten en limieten voor uit de hand lopende queries.
Lakehouse‑tabelformaten voegen metadata, snapshots, schema‑evolutie en transactiesemantiek toe bovenop objectbestanden. Ze verbeteren interoperabiliteit maar introduceren catalogus‑ en onderhoudsverantwoordelijkheden. Open formaten verminderen lock‑in alleen wanneer compute‑engines, governance en operationele procedures ze daadwerkelijk kunnen gebruiken.
Betrouwbare pipelines en dataprodukten
Pipelines moeten idempotent zijn of duplicaten kunnen reconciliëren. Watermarks en event‑time behandelen late aankomsten; backfills reproduceren historische transformaties; schema‑contracten definiëren compatibele wijzigingen. Datatests dekken uniciteit, volledigheid, geaccepteerde waarden, relaties en bedrijfs‑invarianten — niet alleen of een taak heeft gedraaid.
Beschouw belangrijke datasets als producten met eigenaren, documentatie, service‑verwachtingen, vindbaarheid, ondersteuning en gebruikers. Lineage verbindt bronvelden via transformaties met rapporten, waardoor de impact van wijzigingen en incidentonderzoek sneller verloopt. Toegangsbeleid moet zich voortplanten of opnieuw worden geëvalueerd wanneer data wordt gekopieerd.
Een warehouse‑programma slaagt wanneer beslissingen betrouwbaarder en sneller worden, niet wanneer de opslagcapaciteit groeit. Verwijder ongebruikte tabellen, maak query‑ en opslagkosten inzichtelijk, evalueer gevoelige toegang, en meet of teams beheerde metriek vertrouwen en hergebruiken in plaats van private spreadsheets te onderhouden.
Voorbeeld: een sales‑analytics warehouse ontwerpen
Definieer de feitgranulariteit als één voltooide orderregel, en koppel vervolgens product-, klant-, kanaal-, promotie-, geografische en datumdimensies via surrogate‑sleutels. Houd orderstatus‑events in een aparte feitentabel in plaats van snapshots en transacties te mengen. Omzet, hoeveelheid, korting, belasting en kosten vereisen expliciete valuta, retour, annulering en herkenningsregels. De metriekdefinitie moet hetzelfde antwoord opleveren in dashboards, notebooks en financiële reconciliatie.
Ingestie legt bronwijzigingen vast, landt onveranderlijke ruwe data, valideert het schema en transformeert het naar geteste staging‑ en dimensionale modellen. Late‑arriving updates moeten de juiste historische periode corrigeren zonder feiten te dupliceren. Vergelijk rij‑aantallen en monetaire totalen met bronsystemen, test uniciteit en relaties, en registreer lineage van rapport‑veld naar bron. Backfills gebruiken versie‑code en geïsoleerde validatie vóór het vervangen van vertrouwde tabellen.
Toegang scheidt klant‑identifiers van breed beschikbare aggregaten en past het principe van minste privilege toe per rol en doel. Workload‑management houdt executive dashboards responsief terwijl analisten exploratieve queries uitvoeren. Monitor versheid, mislukte tests, query‑kosten, ongebruikte tabellen en semantische wijzigingen. Een warehouse is succesvol wanneer beheerde metriek herhaalbare beslissingen ondersteunt; louter data centraliseren kan verwarring centraliseren als eigendom, kwaliteit en definities onopgelost blijven.
Disaster recovery moet backup‑dekking, cross‑region kopieën, catalogus‑ en permissie‑herstel, acceptabel dataverlies en hersteltijd specificeren. Test herstel in een geïsoleerde omgeving en verifieer metriek, niet alleen bestanden. Encryptiesleutels, identiteitsconfiguratie, orchestratiecode en semantische definities maken deel uit van het herstelbare systeem. Een warehouse dat petabytes kan herstellen maar geen toegangsbeleid of vertrouwde berekeningen kan reproduceren, heeft zijn analytische service niet hersteld.
Praktische implementatie‑checklist
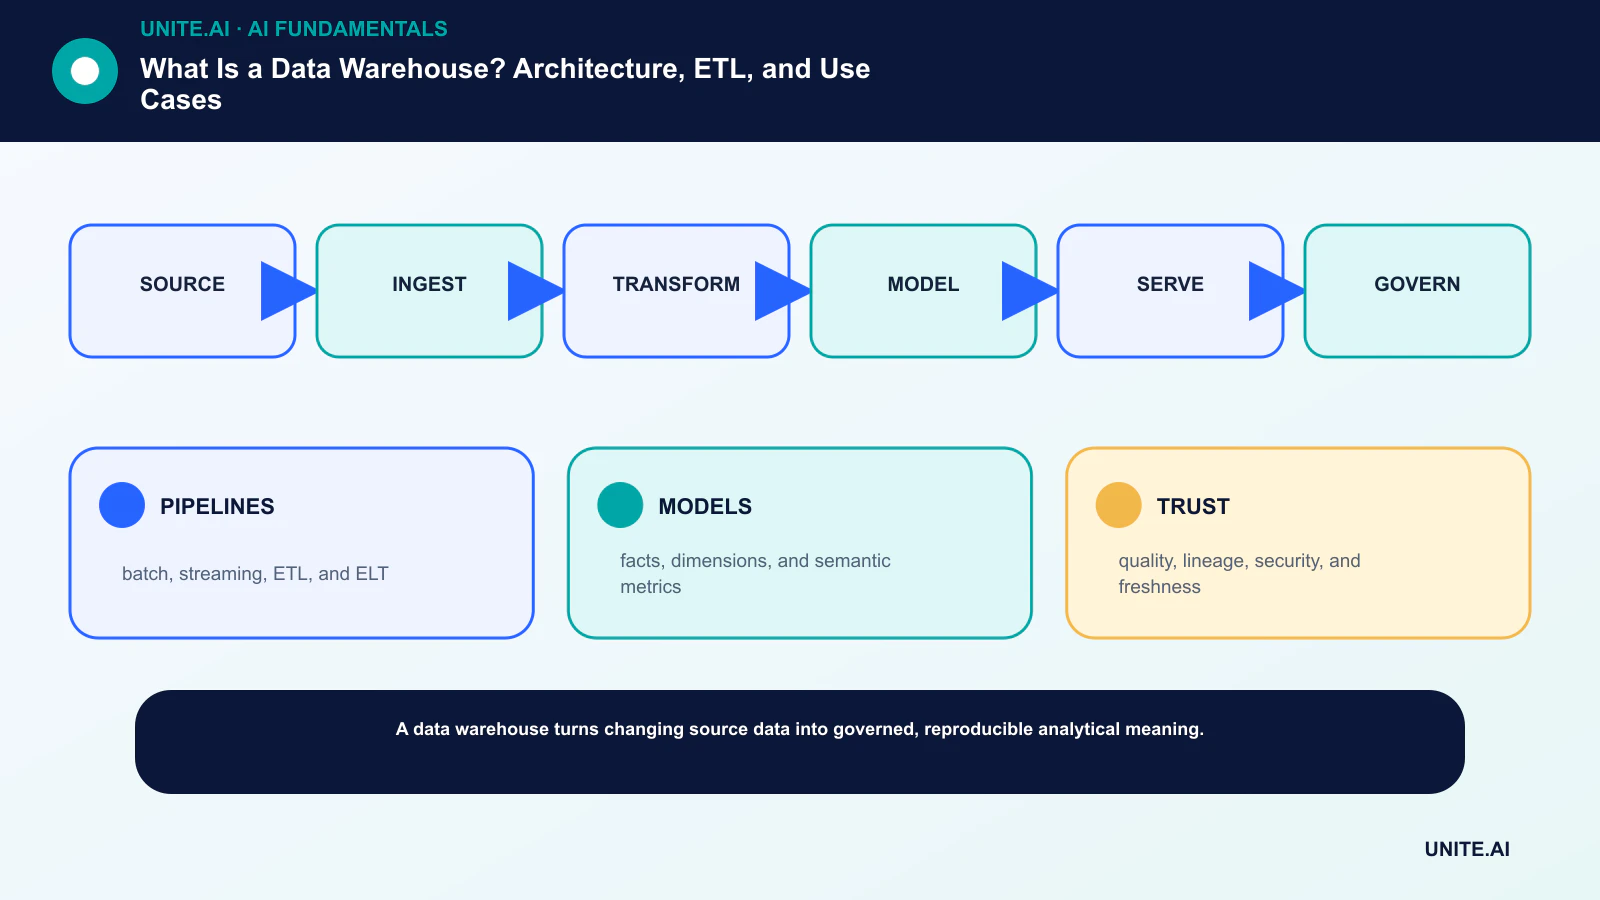
Zet het concept om in een begrensde, testbare workflow: source → ingest → transform → model → serve → govern. Benoem een verantwoordelijke eigenaar, documenteer de data en afhankelijkheden, stel een eenvoudige baseline vast, definieer acceptatie‑ en stopcriteria, test representatieve fouten, en definieer monitoring, rollback en review vóór het uitbreiden van de scope. Leg versies en aannames vast zodat een ander team het resultaat kan reproduceren en begrijpt wat er is veranderd.
Voor de lancering voer een gedocumenteerde readiness‑review uit met de mensen die het systeem bouwen, exploiteren, beveiligen en erdoor worden beïnvloed. Test normale gevallen, grensvoorwaarden, afhankelijkheidsfouten en misbruik; bewaar het bewijs en onopgeloste risico's. Definieer wie een release kan goedkeuren, een drempel kan wijzigen, een output kan overriden of de operatie kan stoppen. Herzie de beslissing nadat real‑world data binnenkomt, want een technisch succesvolle pilot garandeert geen betrouwbare prestaties op grotere schaal.
- PIPELINES: batch, streaming, ETL, en ELT.
- MODELS: feiten, dimensies en semantische metriek.
- TRUST: kwaliteit, lineage, beveiliging en versheid.
Veelgestelde vragen
Is een datawarehouse gewoon een grote database?
Het is een database of analytisch platform dat is ontworpen rond geïntegreerde, historische analyse. Zijn modellering, ingestie, governance en workload‑patronen verschillen van die van een transactionele applicatiedatabase.
Moet een bedrijf ETL of ELT gebruiken?
Veel organisaties gebruiken beide. Transformeer vroeg wanneer privacy, validatie of bandbreedte dit vereist; transformeer na het laden wanneer de rekencapaciteit van het warehouse en snelle iteratie voordelig zijn.
Primaire referenties











