
AI-basisprincipes
Wat is een verwarringsmatrix?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Een confusion matrix is een tabel die telt hoe vaak de voorspellingen van een classifier overeenkomen of verschillen met bekende labels. Ze toont welke klassen met elkaar worden verward en levert de tellingen die worden gebruikt om metriek zoals precisie, recall, specificiteit en F1 te berekenen. Het is een van de kern‑diagnostische hulpmiddelen voor begeleid leren classificatieproblemen.
De matrix zelf is geen enkele prestatiewaarde. Het is een gestructureerd overzicht van uitkomsten bij een bepaalde beslissingsdrempel, dataset en klasse‑definitie.
Belangrijkste punten
- Voor binaire classificatie zijn de vier uitkomsten true positive, false positive, false negative en true negative.
- Label de assen altijd: bibliotheken en publicaties plaatsen de werkelijke en voorspelde klassen niet altijd in dezelfde oriëntatie.
- Nauwkeurigheid kan ernstige fouten verbergen wanneer klassen scheef verdeeld zijn.
- Het wijzigen van de classificatiedrempel verandert de verwarringsmatrix en de afweging tussen precisie en recall.
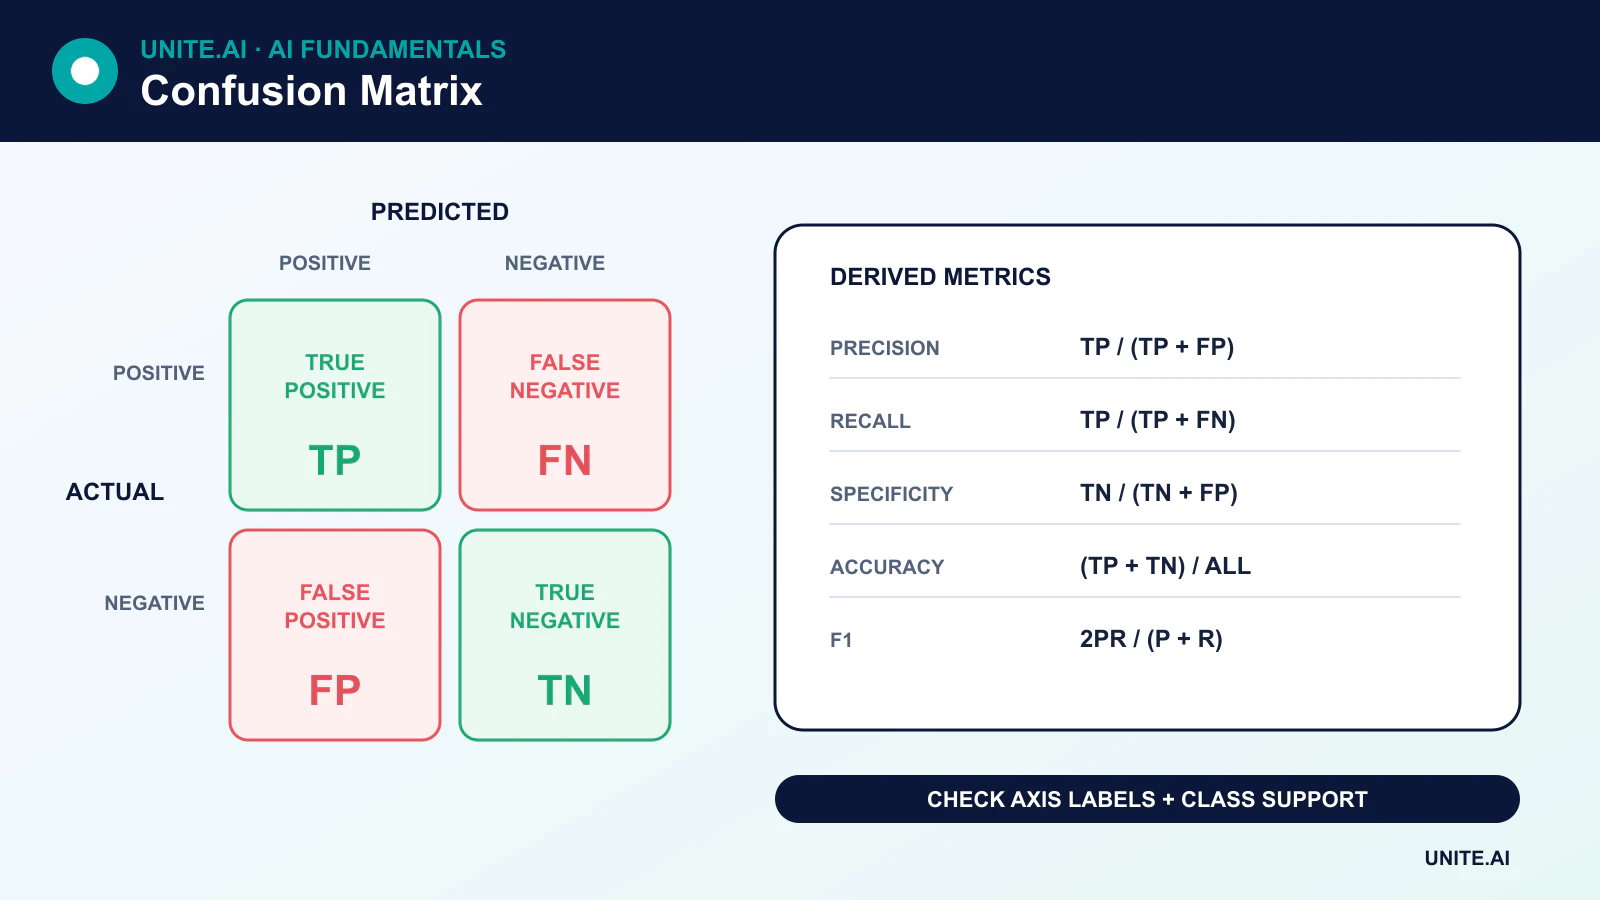
De vier uitkomsten van binaire classificatie
- True positive (TP): het voorbeeld is positief en het model voorspelt positief.
- False positive (FP): het voorbeeld is negatief maar het model voorspelt positief.
- False negative (FN): het voorbeeld is positief maar het model voorspelt negatief.
- True negative (TN): het voorbeeld is negatief en het model voorspelt negatief.
In de conventie van scikit-learn staan rijen voor de werkelijke klassen en kolommen voor de voorspelde klassen. Andere visualisaties kunnen deze indeling transponeren, dus de labels – niet de hoekposities – moeten de interpretatie sturen.
Metrieken afgeleid van een verwarringsmatrix
Precisie
Precision = TP / (TP + FP)
Precisie beantwoordt: van de voorbeelden die als positief zijn voorspeld, welk deel was daadwerkelijk positief?
Recall of sensitiviteit
Recall = TP / (TP + FN)
Recall beantwoordt: van alle werkelijke positieve voorbeelden, welk deel heeft het model geïdentificeerd? Bij binaire classificatie wordt recall van de positieve klasse ook wel sensitiviteit of de true‑positive‑rate genoemd.
Specificiteit
Specificity = TN / (TN + FP)
Specificiteit is recall voor de negatieve klasse: van de werkelijke negatieven, welk deel heeft het model correct afgewezen?
Nauwkeurigheid
Accuracy = (TP + TN) / (TP + TN + FP + FN)
Nauwkeurigheid is nuttig wanneer klassen en foutkosten redelijk in balans zijn. Het kan misleidend zijn wanneer één klasse domineert.
F1‑score
F1 = 2 × (Precision × Recall) / (Precision + Recall)
De F1‑score vat precisie en recall samen met een harmonisch gemiddelde. Ze negeert true negatives, dus is ze niet voor elke taak de juiste samenvatting.
Een uitgewerkt voorbeeld
Stel dat een testset 1.000 transacties bevat. Vijftig zijn frauduleus. Een model vindt 40 van die fraudegevallen maar markeert 30 legitieme transacties als fraude:
- TP = 40
- FN = 10
- FP = 30
- TN = 920
Het model heeft 96 % nauwkeurigheid, maar de precisie is ongeveer 57 % en de recall 80 %. De hoge nauwkeurigheid wordt grotendeels gedreven door het grote aantal legitieme transacties. Of dit model acceptabel is, hangt af van de kosten van gemiste fraude, de capaciteit voor onderzoek en hoe goed de risicoscores gekalibreerd zijn.
Drempels veranderen de matrix
Veel classifiers geven een score in plaats van een onvermijdelijk ja/nee‑antwoord. Het verlagen van de positieve drempel verhoogt doorgaans recall en false positives; het verhogen ervan verhoogt doorgaans precisie of specificiteit terwijl meer positieven worden gemist. De drempel moet worden gekozen met behulp van validatiedata en echte foutkosten, niet automatisch op 0,5 vastgezet.
Precisie‑recall‑ en ROC‑curves vatten de prestaties over drempels samen. Precisie‑recall‑curves zijn vaak informatiever wanneer de positieve klasse zeldzaam is.
Multiclass verwarringsmatrices
Voor K klassen is de matrix K × K. Correcte voorspellingen liggen op de diagonaal; niet‑diagonaal‑cellen tonen welke klasse‑paren met elkaar worden verward. Per‑klasse‑metriek kan op verschillende manieren worden gemiddeld:
- Macro‑gemiddelde: geeft elke klasse gelijke gewicht.
- Gewogen gemiddelde: weegt elke klasse naar het aantal voorbeelden.
- Micro‑gemiddelde: aggregeert uitkomsttelling vóór het berekenen van de metriek.
Het rapporteren van slechts één gemiddelde kan slechte prestaties op kleinere klassen verbergen. Neem ondersteuningsaantallen en per‑klasse‑resultaten op waar de verschillen ertoe doen.
Veelvoorkomende fouten
- Een getransponeerde matrix lezen zonder de as‑labels te controleren.
- Metrieken berekenen op trainingsdata in plaats van op een geschikte hold‑out set.
- De prevalentie van klassen, de bemonsteringsstrategie of dubbele entiteiten over splitsingen negeren.
- Matrixes die bij verschillende drempels zijn geproduceerd vergelijken zonder de wijziging te noteren.
- Alle false positives en false negatives als even kostbaar behandelen.
Een verwarringsmatrix is dus een diagnostisch hulpmiddel, geen volledige evaluatie. Kalibratie, subgroepanalyse, robuustheid en downstream‑gevolgen behoren eveneens tot een classificatiereview.
Elke cel lezen en bruikbare metriek afleiden
Voor binaire classificatie telt de verwarringsmatrix true positives, false positives, false negatives en true negatives voor een gekozen positieve klasse en drempel. Nauwkeurigheid deelt correcte voorspellingen door alle gevallen; precisie vraagt welk deel van de voorspelde positieven correct was; recall vraagt welk deel van de werkelijke positieven werd gevonden; specificiteit meet hoeveel werkelijke negatieven correct werden afgewezen. De F1‑score is het harmonisch gemiddelde van precisie en recall. Geen van deze maten is per definitie het beste: fraudedetectie, medische triage en spamfiltering kennen verschillende consequenties voor dezelfde cellen.
Voor multiclass‑problemen vertegenwoordigen rijen doorgaans werkelijke klassen en kolommen voorspelde klassen, hoewel conventies variëren, dus labels moeten expliciet zijn. One‑vs‑rest‑telling levert per‑klasse precisie en recall op. Macro‑averaging weegt klassen gelijk; micro‑averaging aggregeert beslissingen en bevoordeelt veelvoorkomende klassen; gewogen averaging volgt de klassenondersteuning. Multilabel‑taken staan meerdere labels per item toe en vereisen label‑wise of sample‑wise definities. Normaliseer per rij om recall‑patronen te inspecteren of per kolom om de samenstelling van voorspellingen te bekijken, maar behoud ruwe tellingen zodat zeldzame groepen niet visueel worden overdreven.
Drempels, onzekerheid en operationele beslissingen
Een verwarringsmatrix vat harde beslissingen bij één drempel samen. Gebruik precisie‑recall‑ of ROC‑curves om drempels te vergelijken, en kies vervolgens een operationeel punt op basis van capaciteit, prevalentie en foutkosten. Kalibratie vraagt of voorspelde waarschijnlijkheden overeenkomen met de waargenomen frequentie en staat los van rangschikking. Wanneer de prevalentie verandert, kan precisie variëren zelfs als sensitiviteit en specificiteit stabiel blijven. Rapporteer betrouwbaarheidsintervallen of bootstrap‑variatie, en vermijd conclusies te trekken uit een handvol fouten in een kleine subgroep.
Audit matrixes per tijd, locatie, apparaat, taal en relevante getroffen groepen om geconcentreerde fouten te vinden. Vergelijk het model met het bestaande besluitvormingsproces, inclusief menselijke beoordeling. Voor cascades, registreer fouten op elke fase: ophalen, classificeren, drempelen en actie. Monitor live uitkomst‑labels met hun vertraging en correctieproces. Een ogenschijnlijk verbeterde F1 kan nog steeds schadelijke false negatives verhogen of de beoordelingscapaciteit overschrijden. De verwarringsmatrix is een besluit‑logboek; koppel elke cel aan wie de fout ondervindt en welke respons volgt.
Uitgewerkt voorbeeld: een medische screeningsdrempel kiezen
Een machine‑learning screeningsmodel geeft een risicoscore voor een aandoening met lage prevalentie. Het team maakt verwarringsmatrixes over verschillende drempels en rapporteert sensitiviteit, specificiteit, precisie, false referrals en gemiste gevallen met betrouwbaarheidsintervallen. Omdat de positieve voorspellende waarde afhankelijk is van prevalentie, modelleert het de beoogde populatie in plaats van één dataset’s precisie te citeren. Resultaten worden gesegmenteerd per apparaat, locatie, leeftijd, geslacht en andere klinisch gemotiveerde groepen.
Clinici kiezen een operationeel punt dat de vereiste sensitiviteit behoudt zonder de bevestigende tests te overweldigen. De matrix wordt omgezet in verwachte tellingen per 10.000 gescreende personen zodat de consequenties begrijpelijk zijn. Scores buiten gevalideerde condities leveren geen geautomatiseerde conclusie op. Monitoring vergelijkt voorspellingen met vertraagde bevestigde diagnoses, volgt capaciteit en kalibratie, en triggert een review wanneer prevalentie of acquisitie verandert. De verwarringsmatrix blijft gekoppeld aan het exacte model, de drempel en de populatie.
Implementatie‑bewijs en operationele gereedheid
Een productiebeslissing vereist meer dan een succesvolle demonstratie. Definieer de beoogde gebruikers, operationele omgeving, inputs, outputs, afhankelijkheden, eigenaar en de consequentie van elke belangrijke fout. Stel een reproduceerbare baseline en een versioned evaluatieset op vóór afstemming. Test gewone gevallen, grenscondities, misvormde of ontbrekende input, distributieverandering, afhankelijkheidsuitval, misbruik en de groepen of omgevingen die het meest kans hebben onderbediend te worden. Meet taakkwaliteit samen met kalibratie of onzekerheid, latentie, doorvoersnelheid, resource‑kosten, toegankelijkheid, privacy en beveiliging. Leg elke transformatie en drempel vast zodat een onafhankelijke reviewer het resultaat kan reproduceren en bewijs kan scheiden van een aantrekkelijk prototype.
Voor de lancering wijs autoriteit toe voor release, uitzonderingen, wijzigingen, rollback en pensionering. Gebruik een gefaseerde uitrol, behoud een veilige fallback, en verifieer monitoring met opzettelijk geïnjecteerde fouten. Operationele telemetrie moet inputkwaliteit, outputgedrag, model‑ of regelversie, afhankelijkheidsgezondheid, menselijke overrides en bevestigde uitkomsten onthullen zonder onnodige gevoelige data te verzamelen. Definieer alarm‑drempels en een verantwoordelijke voor de respons, en evalueer vervolgens real‑world‑bewijs na uitrol in plaats van aan te nemen dat offline‑prestaties blijven bestaan. Her‑evalueer telkens wanneer databronnen, gebruikers, modellen, leveranciers, beleid, hardware of doelstellingen veranderen. Een onderhouden systeem vereist ook gedocumenteerd herstel, incident‑leren, verwijder‑ en retentieprocedures, en een duidelijk punt waarop het moet worden uitgeschakeld of vervangen.
Veelgestelde vragen
Wat is een genormaliseerde verwarringsmatrix?
Normalisatie deelt tellingen door het totaal van de ware klasse, het totaal van de voorspelde klasse, of alle observaties. Het maakt ratios makkelijker vergelijkbaar tussen klassen, maar het rapport moet ook ruwe ondersteuningsaantallen behouden zodat kleine groepen niet worden aangezien voor even grote.
Kan een verwarringsmatrix regressie evalueren?
Niet rechtstreeks. Een verwarringsmatrix vereist discrete klassen. Het indelen van een continue target in bins gooit informatie weg; regressie moet normaal gesproken gebruik maken van residu‑analyse en metriek die is ontworpen voor continue waarden, zoals MAE of RMSE.
Primaire referenties












