AI-basisprincipes
Wat is Ensemble Learning?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
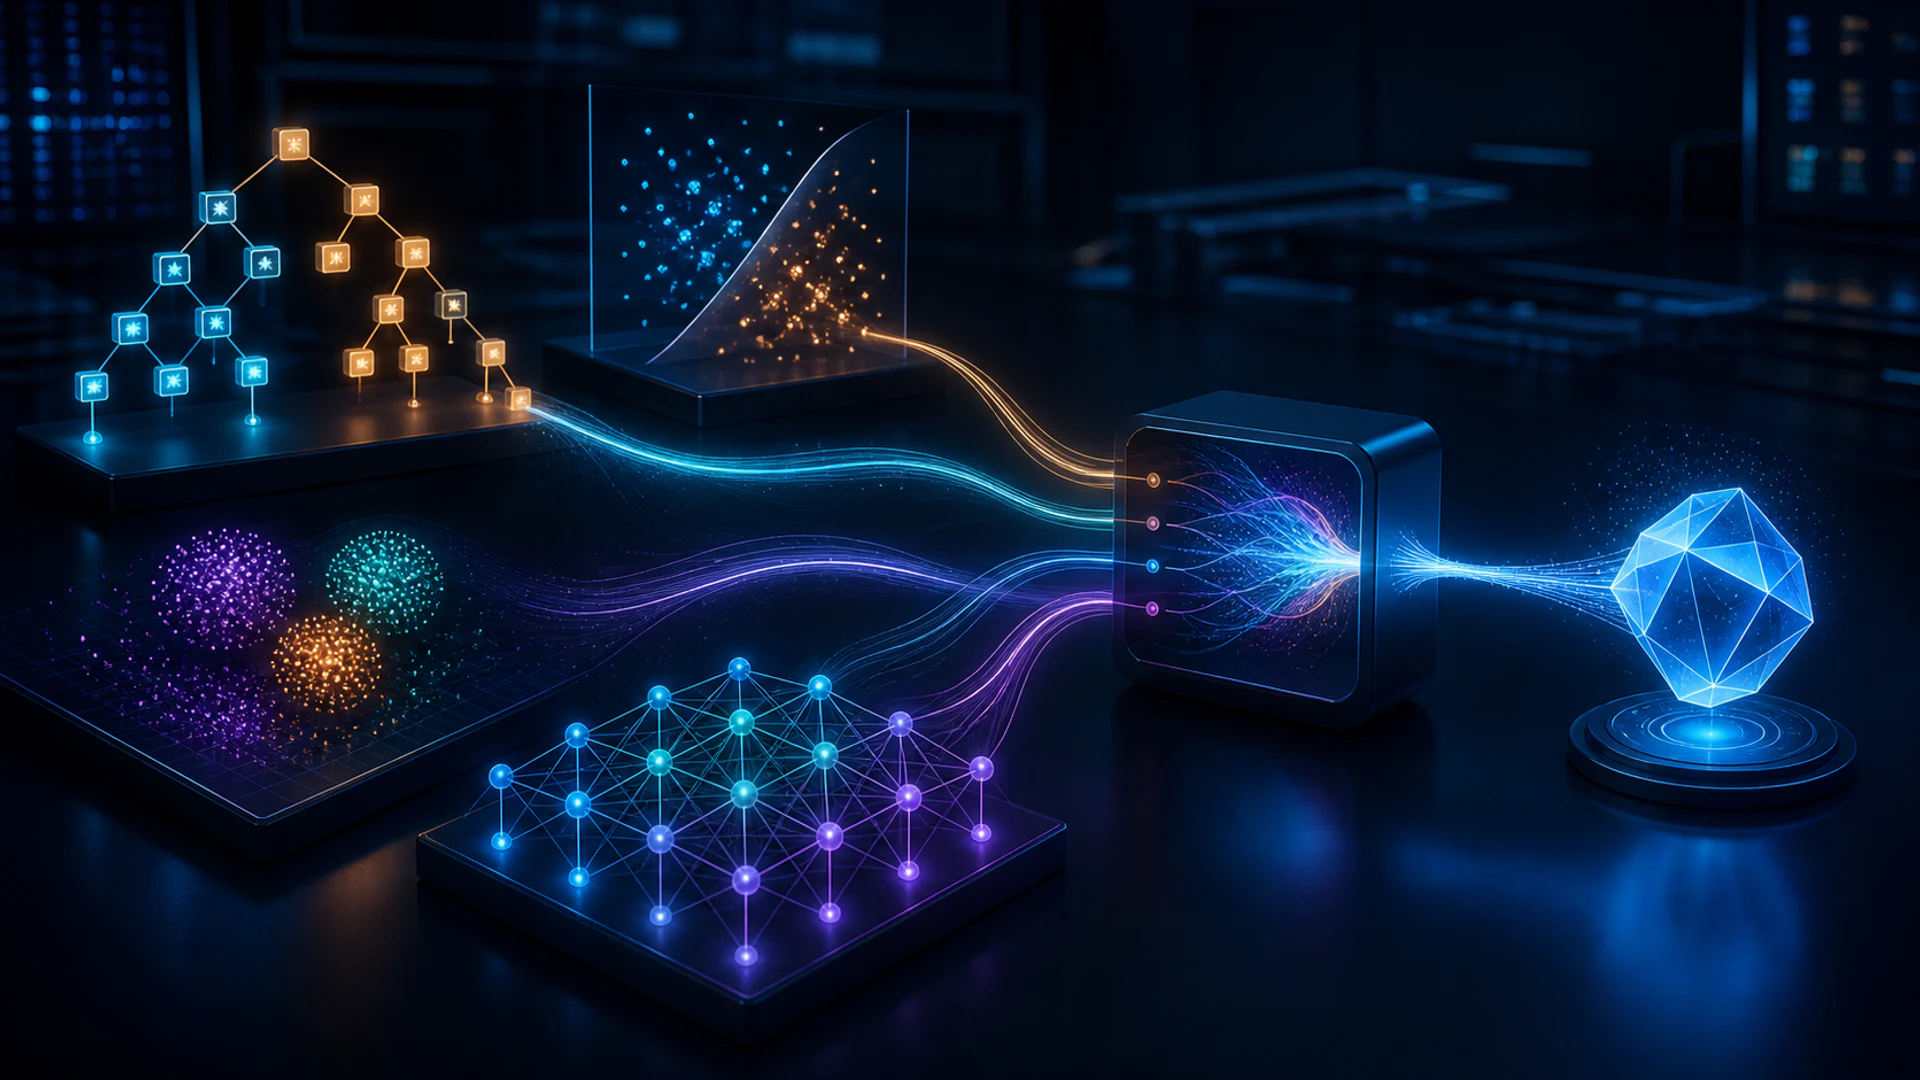
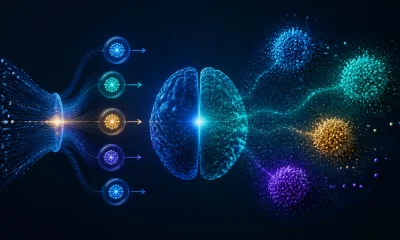
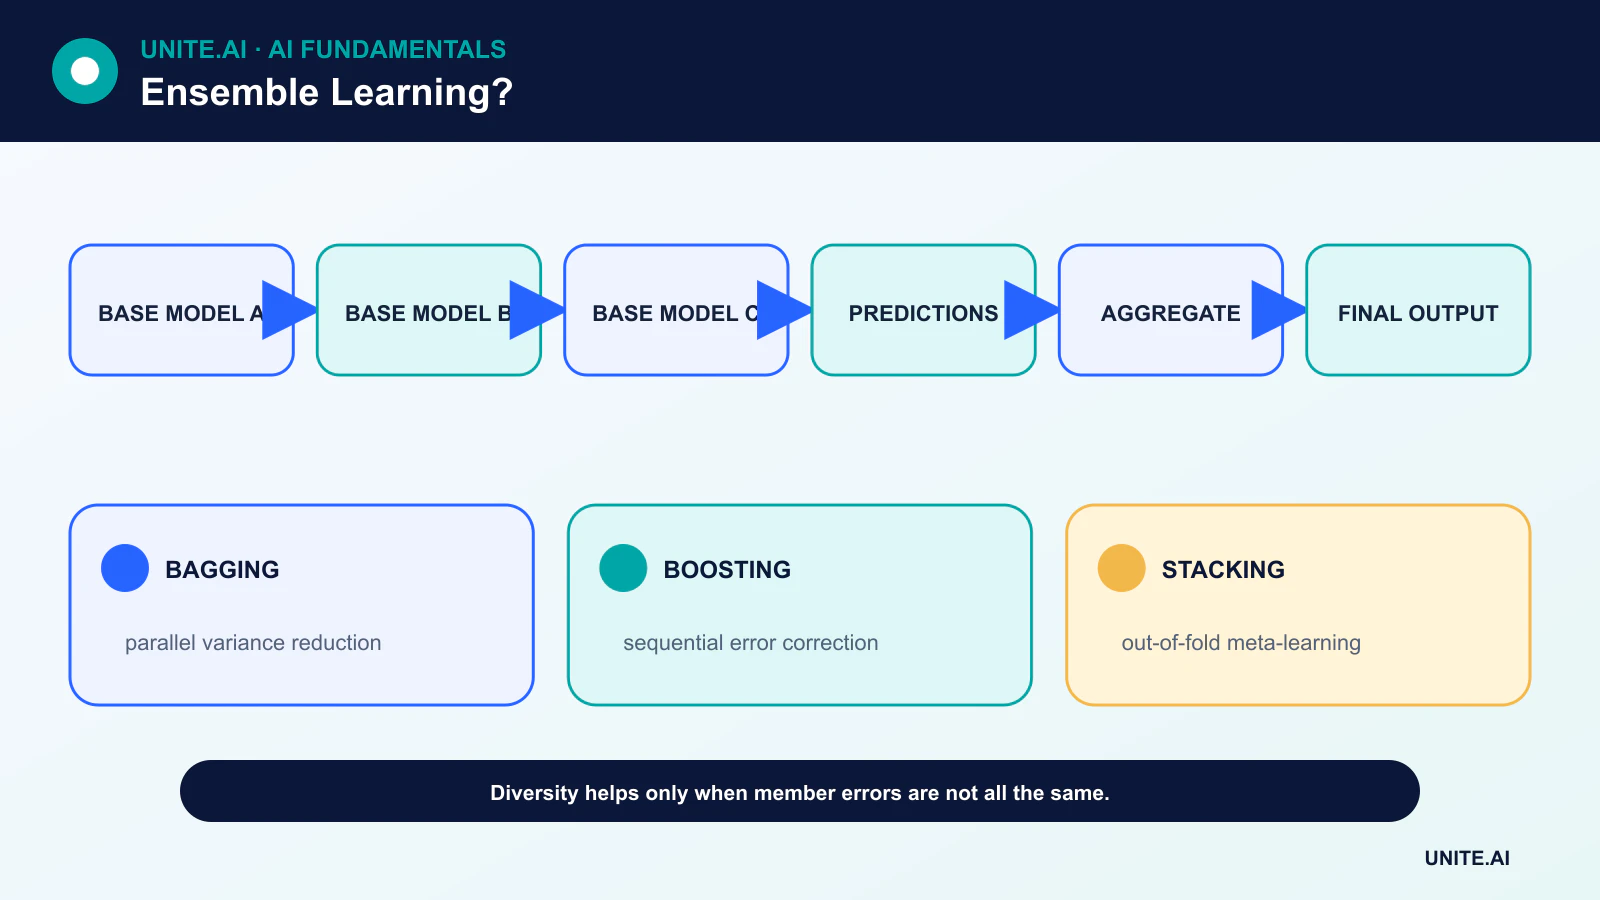
Ensemble learning combineert voorspellingen van meerdere modellen. Het centrale idee is dat modellen met verschillende fouten een nauwkeuriger of stabieler resultaat kunnen opleveren wanneer hun uitkomsten worden gemiddeld, gestemd of doorgegeven aan een meta‑learner.
Meer modellen toevoegen is niet genoeg. Als elk lid dezelfde shortcut leert, zullen hun fouten gecorreleerd zijn en kan het ensemble simpelweg zelfverzekerder worden in dezelfde fout.
Belangrijkste conclusies
- Ensembles werken het best wanneer de individuele modellen nuttig zijn en betekenisvol verschillende fouten maken.
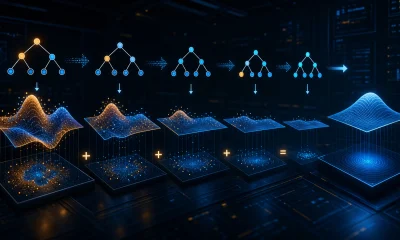
- Bagging traint leden parallel op opnieuw gesamplede data; boosting traint leerders sequentieel om fouten te corrigeren.
- Stacking traint een meta‑model op out‑of‑fold voorspellingen, niet op in‑sample voorspellingen.
- Nauwkeurigheidswinst moet worden afgewogen tegen latentie, calibratie, interpretatie en onderhoudskosten.
Stemmen en middelen
Hard voting kiest de klasse met de meeste stemmen. Soft voting gemiddeld de klasse‑kansen, meestal na calibratie. Regressie‑ensembles middelen vaak numerieke voorspellingen. Gewogen versies geven meer invloed aan sterkere leden.
Een gemiddelde kan de variantie verminderen wanneer fouten niet perfect gecorreleerd zijn. Het kan geen gedeeld datadefect, label‑fout of ontbrekende subgroep herstellen. Diversiteit moet worden gemeten via onenigheid en fout‑overlap, niet worden verondersteld op basis van verschillende modelnamen.
Bagging en random forests
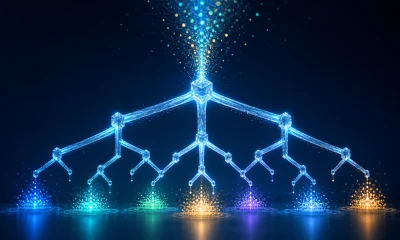
Bootstrap aggregating traint modellen op opnieuw gesamplede datasets en middelen ze. Een decision tree heeft een hoge variantie, waardoor het een natuurlijke kandidaat voor bagging is.
Random forests voegen willekeurige kenmerkenselectie toe bij splits, waardoor de correlatie tussen bomen wordt verminderd. Out‑of‑bag voorbeelden kunnen de prestaties schatten, maar een uiteindelijke onaangeraakte testset blijft waardevol voor modelselectie en claims bij implementatie.
Boosting
Boosting bouwt een additief model in fasen. Latere leerders richten zich op voorbeelden of residuele patronen die het huidige ensemble slecht afhandelt. AdaBoost wijzigt voorbeeldgewichten; gradient boosting past leerders aan op negatieve gradients van een gekozen verlies.
Boosted trees kunnen complexe tabel‑relaties modelleren, maar diepe bomen, te veel iteraties en lekken kunnen nog steeds overfitten. Leer‑snelheid, boomdiepte, subsampling en early stopping zijn belangrijke regel‑parameters.
Stacking en blending
Stacking creëert een model op tweede niveau dat leert hoe basisvoorspellingen te combineren. Om lekken te voorkomen, moet elke trainingsrij voor het meta‑model afkomstig zijn van een basismodel dat niet op die rij getraind is. Cross‑validation genereert deze out‑of‑fold voorspellingen.
Blending gebruikt een aparte holdout‑set voor het meta‑model, wat eenvoudiger is maar de beschikbare trainingsdata vermindert. Beide benaderingen vereisen dezelfde preprocessing en versiebeheer bij inferentie.
Operationele afwegingen
Een ensemble kan het geheugen‑, reken‑ en faal‑gedrag vermenigvuldigen. Het kan moeilijker zijn om uit te leggen, te calibreren en consistent bij te werken. Distillatie kan een ensemble comprimeren tot een kleiner model, maar de student moet onafhankelijk worden geëvalueerd.
Een praktische selectie vergelijkt prestaties, tail‑latentie, calibratie, resource‑gebruik en fout‑kosten. Soms is één goed‑geregulariseerd model te verkiezen boven een kleine nauwkeurigheidswinst van een fragiele stack.
Waarom ensembles werken
Ensemble learning combineert meerdere modellen zodat hun fouten gedeeltelijk elkaar opheffen of hun sterktes verschillende regio’s dekken. Bagging traint modellen op opnieuw gesamplede data en middelen voorspellingen, waardoor de variantie afneemt; random forests voegen willekeurige kenmerkenselectie toe om bomen te decorrelateren. Boosting traint leerders sequentieel om zich te richten op residuele fouten, wat vaak de bias vermindert maar de gevoeligheid voor ruis en afstemming vergroot. Stacking traint een meta‑model op basis‑modelvoorspellingen. Diversiteit moet nuttig zijn: het middelen van identieke modellen voegt kosten toe zonder veel foutreductie.
Correlatie tussen fouten bepaalt het voordeel. Diversiteit kan voortkomen uit datasamples, kenmerken, algoritmen, hyperparameters, willekeurige initialisatie of tijdsvensters. Hard voting negeert vertrouwen; soft voting middelen kansen maar vereist compatibele calibratie. Regressie kan middelen of robuuste aggregatie gebruiken. Bij stacking zijn out‑of‑fold voorspellingen essentieel — het trainen van het meta‑model op basisvoorspellingen van dezelfde getrainde data veroorzaakt lekken. Houd een eenvoudige gemiddelde basislijn voordat je een complexe combiner adopteert.
Evaluatie, calibratie en onzekerheid
Vergelijk elk lid en het ensemble op een hold‑out set met identieke preprocessing. Rapporteer taak‑metrics, calibratie, subgroep‑fouten, variantie over folds of seeds, en resource‑kosten. Een ensemble kan de gemiddelde kwaliteit verbeteren terwijl het een gedeelde blinde vlek veroorzaakt door gemeenschappelijke data of labels maskeert. Inspecteer onenigheid: die kan onzekerheid identificeren, maar gecorreleerde, vol vertrouwen verkeerde modellen kunnen het eens zijn. Calibreer het uiteindelijke ensemble, niet alleen de leden, en valideer afwezigheidsdrempels tegen review‑capaciteit en consequenties.
Out‑of‑bag schattingen zijn nuttig voor bagged modellen maar vervangen geen uiteindelijke, representatieve test voor implementatie. Voor temporele data, vermijd resampling die de volgorde doorbreekt. Voor veiligheid‑gerelateerde toepassingen, test lid‑falen, verouderde modellen en adversarial input. Gewogen ensembles kunnen overfitten op validatiedata wanneer veel kandidaten worden geprobeerd. Leg de selectie van kandidaten vast en gebruik geneste validatie wanneer afstemming uitgebreid is.
Bediening en onderhoud
Ensembles vermenigvuldigen geheugen, latentie, energie en operationele afhankelijkheden. Distillatie kan gecombineerd gedrag comprimeren tot één model, met een nieuwe validatie‑vereiste. Versieer leden, preprocessing, gewichten en routing als één artefact; definieer gedrag wanneer een lid time‑out of een ongeldige uitkomst produceert. Monitor lid‑voorspellingen en onenigheid zodat stille fouten zichtbaar zijn. Schaf overbodige leden af en train bewust opnieuw. Ensembles verbeteren voorspellingen wanneer fout‑diversiteit reëel is, maar ze maken geen bevooroordeelde trainingsdata of een ongeldige target tot betrouwbaar bewijs.
Voorbeeld: een ensemble voor waarschuwingen bij ernstig weer
Een voorspellings‑team combineert een fysieke‑model feature‑set, een gradient‑boosted tree, een neurale sequentiemodel en een gekalibreerde statistische basislijn. Out‑of‑fold voorspellingen trainen een eenvoudig meta‑model, en de evaluatie gebruikt toekomstige stormen die volledig buiten de training van de leden vallen. Metrics include event recall, false alarms, lead time, calibration, geographic performance, and reliability during rare extreme conditions. De correlatie van lid‑fouten wordt onderzocht omdat gedeelde invoergegevens gedeelde blinde vlekken kunnen veroorzaken.
Bediening bewaart elke voorspelling en het gecombineerde resultaat. Als een lid niet beschikbaar is, gebruikt het systeem een vooraf gevalideerde degradatie‑configuratie in plaats van stilletjes te renormaliseren. Onenigheid leidt tot extra beoordeling, maar wordt niet in alle gevallen als onzekerheid behandeld. Monitoring volgt lid‑drift, latentie en stormuitkomsten, met gewichten die alleen via gecontroleerde validatie worden bijgewerkt. Publieke waarschuwingen blijven onder geautoriseerde meteorologische besluitvormingsprocessen; het ensemble verbetert het bewijs, maar herschrijft het alarmbeleid niet autonoom.
Implementatie‑bewijs en operationele gereedheid
Een productie‑beslissing vereist meer dan een succesvolle demonstratie. Definieer de beoogde gebruikers, operationele omgeving, inputs, outputs, afhankelijkheden, eigenaar en de consequentie van elke belangrijke fout. Stel een reproduceerbare basislijn en een geversioneerde evaluatieset vast vóór afstemming. Test gewone gevallen, randvoorwaarden, misvormde of ontbrekende invoer, distributieverschuiving, afhankelijkheidsuitval, misbruik, en de groepen of omgevingen die het meest onderbediend kunnen worden. Meet taakkwaliteit samen met calibratie of onzekerheid, latentie, doorvoersnelheid, resource‑kosten, toegankelijkheid, privacy en beveiliging. Leg elke transformatie en drempel vast zodat een onafhankelijke reviewer het resultaat kan reproduceren en bewijs kan onderscheiden van een aantrekkelijk prototype.
Voor de lancering, wijs autoriteit toe voor release, uitzonderingen, wijzigingen, rollback en pensionering. Gebruik een gefaseerde uitrol, behoud een veilige fallback, en verifieer monitoring met opzettelijk geïnjecteerde fouten. Operationele telemetrie moet de invoer‑kwaliteit, output‑gedrag, model‑ of regelversie, afhankelijkheidsstatus, menselijke overrides en bevestigde uitkomsten onthullen zonder onnodige gevoelige gegevens te verzamelen. Definieer alarm‑drempels en een verantwoordelijke voor de respons, en beoordeel vervolgens real‑world bewijs na implementatie in plaats van aan te nemen dat offline prestaties behouden blijven. Her‑evalueer wanneer gegevensbronnen, gebruikers, modellen, leveranciers, beleid, hardware of doelstellingen veranderen. Een onderhouden systeem heeft ook gedocumenteerde herstel‑, incident‑leer‑, verwijder‑ en retentie‑procedures nodig, en een duidelijk punt waarop het moet worden uitgeschakeld of vervangen.
Veelgestelde vragen
Is een random forest een ensemble?
Ja. Het combineert veel willekeurige decision trees, meestal door stemmen of middelen.
Kunnen identieke modellen een nuttig ensemble vormen?
Dat kan, als trainingsdata, initialisatie of sampling voldoende verschillende fouten oplevert, maar louter duplicatie levert geen voordeel op.
Primaire referenties