
AI-basisprincipes
Wat is een generatief adversarieel netwerk (GAN)?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
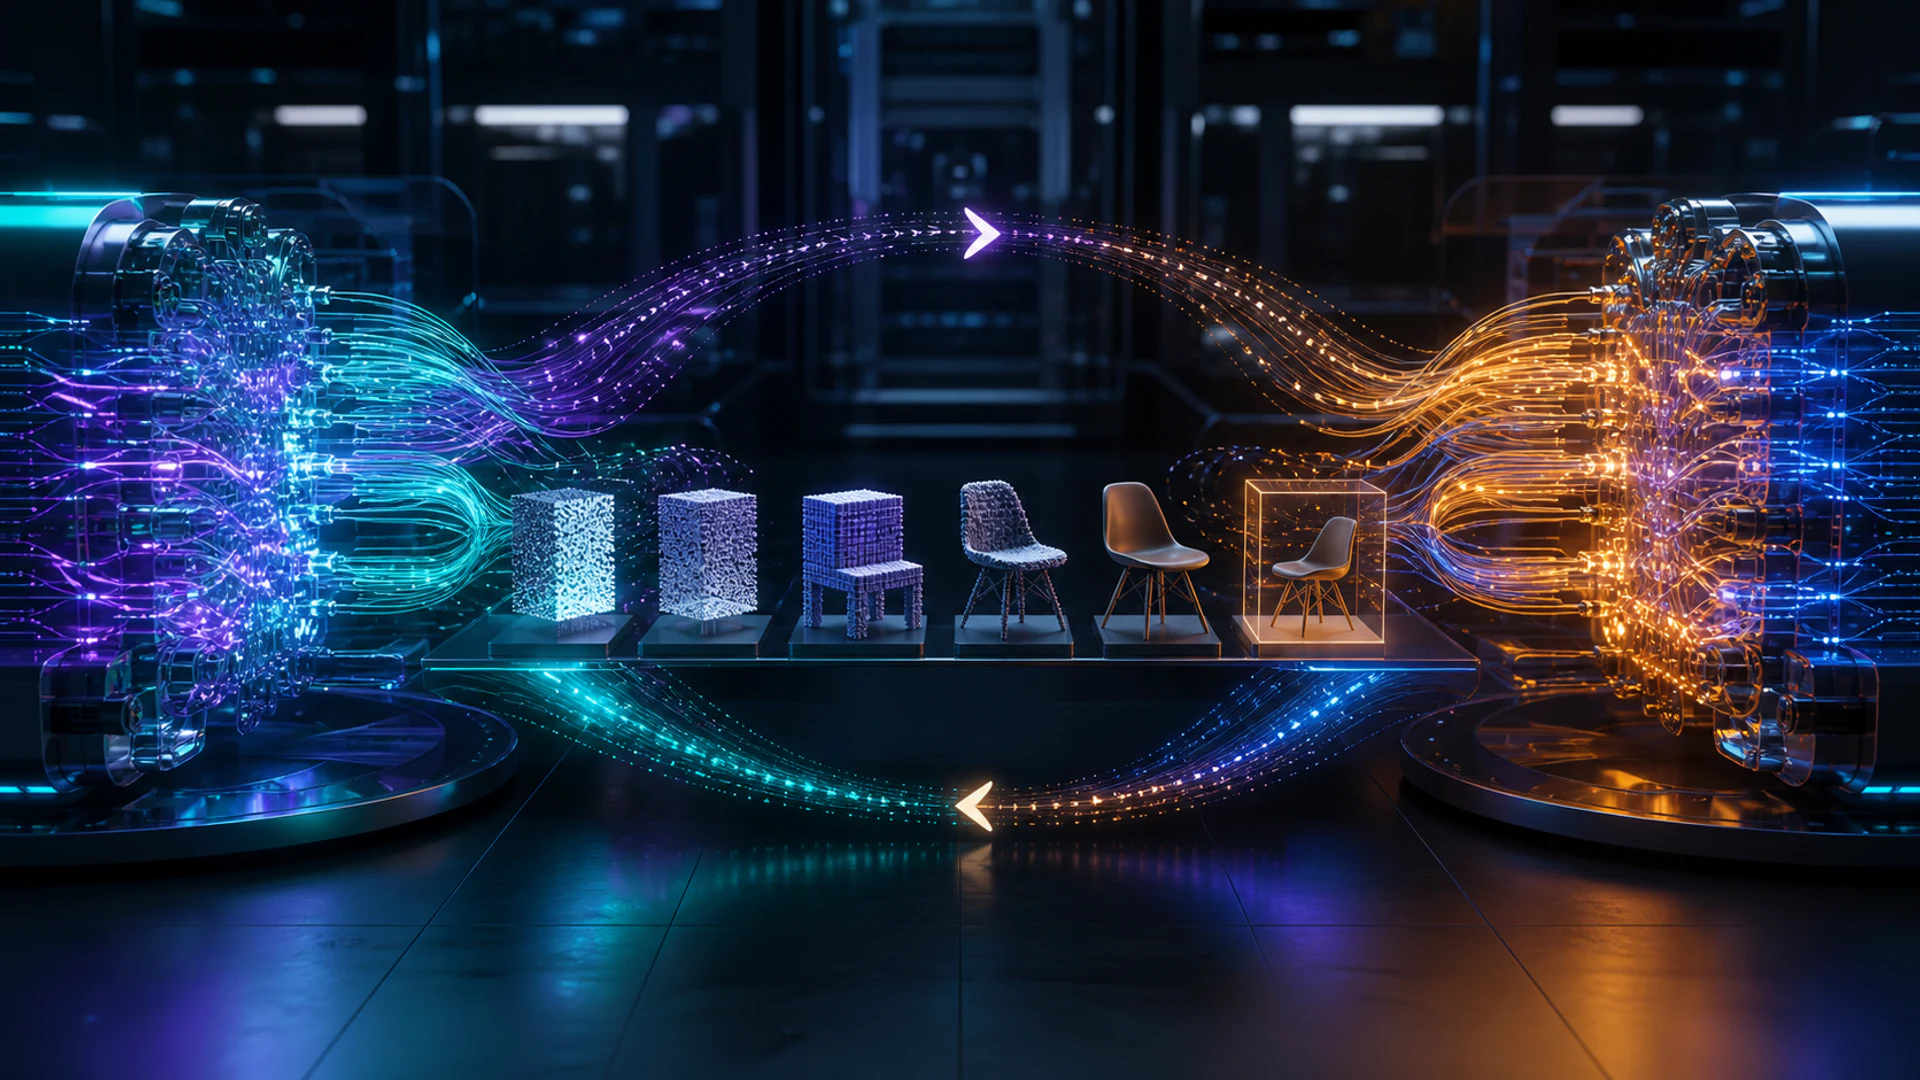
Een generatief adversarieel netwerk (GAN) traint twee neurale netwerken in competitie. Een generator zet willekeurige of voorwaardelijke invoer om in synthetische monsters. Een discriminator probeert gegenereerde monsters te onderscheiden van echte trainingsvoorbeelden. De feedback van elk netwerk verandert het leerprobleem van het andere.
GAN’s kunnen scherpe beelden en controleerbare synthetische data genereren, maar adversaire training is moeilijk te stabiliseren. Visueel realisme bewijst geen diversiteit, feitelijke juistheid of toestemming om de trainingsdata te gebruiken.
Belangrijkste conclusies
- De generator produceert monsters; de discriminator leert een beslissignaal real versus gegenereerd.
- Training streeft naar een evenwicht, maar wisselende tegenstanders kunnen instabiliteit, oscillatie of mode‑collaps veroorzaken.
- Conditionele GAN’s beheersen de generatie met labels, tekst of andere context.
- Evaluatie moet de getrouwheid, dekking, memorisatie en downstream‑risico testen — niet alleen de beeldkwaliteit.
Het adversaire spel
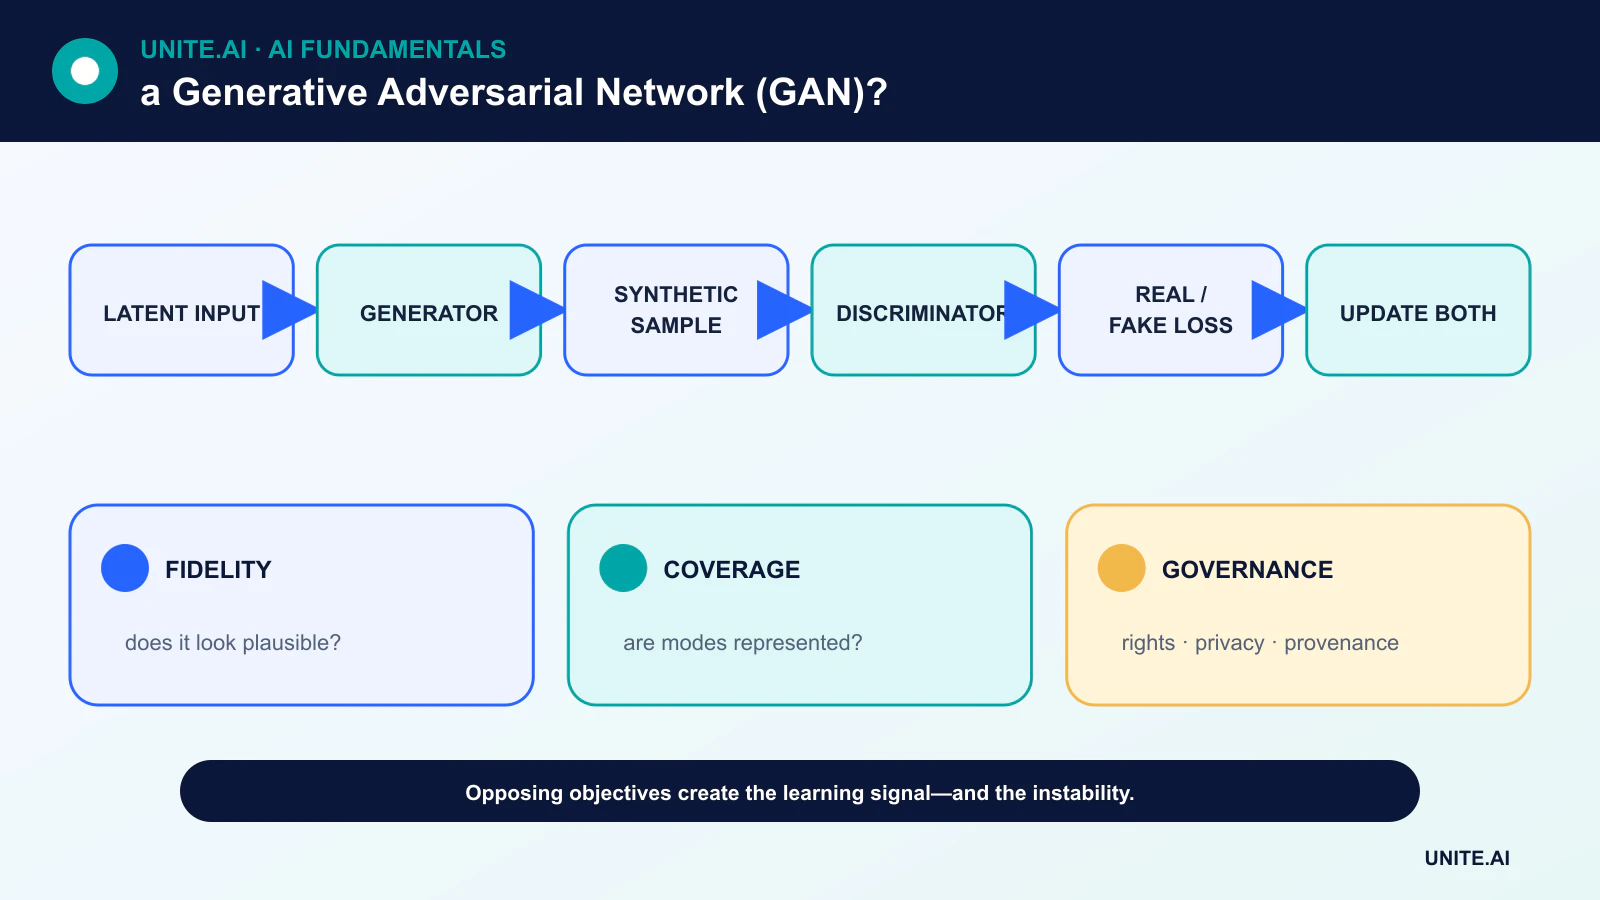
De oorspronkelijke formulering is een twee‑speler minimax‑spel. De discriminator wordt beter in het scheiden van echte data van gegenereerde data, terwijl de generator beter wordt in het maken van monsters die de discriminator als echt classificeert. Beide worden getraind met backpropagation.
Als de discriminator te nauwkeurig wordt, kan de feedback aan de generator onbruikbaar zijn. Als hij te zwak is, kan de generator eenvoudige shortcuts exploiteren. Training wisselt daarom updates af en balanceert zorgvuldig capaciteit, verliesfuncties en optimalisatie‑instellingen.
Mode‑collaps en trainingsstabiliteit
Mode‑collaps treedt op wanneer veel latente invoer vergelijkbare output oplevert, waardoor monsters plausibel lijken maar slechts een deel van de dataverdeling dekken. Andere fouten omvatten oscillatie, exploderende gradients en gevoeligheid voor willekeurige initialisatie.
Wasserstein‑doelstellingen, gradient‑straffen, spectrale normalisatie, architectuurwijzigingen en afgestemde update‑ratio’s kunnen de stabiliteit verbeteren. Ze wegnemen niet de noodzaak om diversiteit te inspecteren en experimenten met meerdere zaden te herhalen.
Conditionele generatie en latente controle
Een conditionele GAN geeft de generator en discriminator een label of andere context, waardoor gerichte klassen of attributen mogelijk zijn. Stijl‑gebaseerde architecturen scheiden aspecten van latente controle op verschillende resoluties en hebben zeer realistische beelden opgeleverd.
Latente richtingen kunnen correleren met menselijke concepten, maar het bewerken van één attribuut kan andere wijzigen omdat de trainingsdata gecorreleerde kenmerken bevatten. Claims over controleerbaarheid moeten worden getest over diverse identiteiten en contexten.
Evaluatie, privacy en herkomst
Metrieken zoals Fréchet Inception Distance vergelijken feature‑distributies, maar ze erven aannames van het feature‑model en kunnen memorisatie of subgroep‑fouten missen. Naaste‑buur analyse, precisie/recall‑achtige dekkings‑tests en menselijke beoordeling leveren aanvullend bewijs.
Een GAN kan zeldzame voorbeelden memoriseren, bias reproduceren of misleidende media genereren. Teams moeten datasets, rechten, filtering, watermerk‑ of herkomst‑mechanismen en misbruik‑controles documenteren. Synthetische data zijn niet automatisch anoniem.
GAN’s, VAE’s en diffusiemodellen
Variationale auto‑encoders optimaliseren een waarschijnlijkheids‑gebaseerd latent doel en ruilen vaak scherpte van monsters in voor een gestructureerde latente ruimte. Diffusiemodellen leren een ruisproces om te keren en zijn een veelgebruikte basis geworden voor beeldgeneratie.
GAN’s blijven nuttig wanneer snelle één‑pass sampling, specifieke afbeelding‑naar‑afbeelding mappings of compacte implementatie belangrijk zijn. De juiste methode hangt af van kwaliteit, diversiteit, latentie, trainingsstabiliteit en governance — niet van welke architectuur het nieuwste is.
Adversaire doelstellingen en trainingsdynamiek
Een generatief adversarieel netwerk traint een generator om monsters te produceren en een discriminator om gegenereerde van echte data te onderscheiden. In het oorspronkelijke minimax‑spel schat de discriminator een signaal gerelateerd aan de dichtheidsratio en probeert de generator deze te misleiden. Training wisselt updates af, zodat elk netwerk leert tegen een bewegende tegenstander in plaats van een vaste verliesfunctie. Als de discriminator te sterk wordt, kunnen generator‑gradients onbruikbaar worden; als hij te zwak is, stagneert de kwaliteit van de gegenereerde data. De verlieswaarde alleen komt niet direct overeen met de kwaliteit van de monsters.
Mode‑collaps treedt op wanneer de generator beperkte variëteiten produceert die de discriminator misleiden. Oscillatie, gevoeligheid voor hyperparameters en onstabiele normalisatie komen ook vaak voor. Wasserstein‑doelstellingen, gradient‑straffen, spectrale normalisatie, feature‑matching, minibatch‑statistieken en zorgvuldig gebalanceerde update‑schema’s pakken verschillende foutmechanismen aan. Conditionele GAN’s gebruiken labels, tekst of afbeeldingen om de output te sturen; stijl‑gebaseerde architecturen scheiden latente invloeden. De kwaliteit en dekking van de dataset blijven fundamenteel omdat de generator de verdeling die hij ziet reproduceert en herschikt.
Evaluatie en verantwoord gebruik
Evalueer getrouwheid en diversiteit afzonderlijk. Fréchet Inception Distance vergelijkt feature‑distributies maar hangt af van steekproefgrootte, feature‑model, preprocessing en domein; Inception Score laat vergelijking met echte data weg. Precisie en recall voor generatieve modellen, naaste‑buur analyse, memorisatie‑controles en menselijke taak‑evaluatie leveren extra bewijs. Voor wetenschappelijke of medische synthese gebruik domeinspecifieke metriek en downstream‑validatie. Houd een gereserveerde echte set bij en vergelijk met diffusie‑ of autoregressieve baselines bij gelijkwaardige rekencapaciteit en resolutie.
GAN’s kunnen data aanvullen, domeinen vertalen, beelden super‑resolven, media synthetiseren en simulatie ondersteunen, maar synthetische data kunnen bias versterken of trainingsvoorbeelden lekken. Verifieer licenties, toestemming, identiteit en herkomst. Bescherm tegen niet‑consensuele imitatie en misleidend gebruik, label of onderteken outputs waar passend, en bewaar generatie‑metadata. Een fotorealistisch beeld is geen documentair bewijs; onzekerheid en synthetische oorsprong moeten zichtbaar blijven wanneer outputs beslissingen beïnvloeden.
Implementatie en reproduceerbaarheid
Leg generator, discriminator, optimizer, dataset, willekeurige seed, truncatie en sampling‑instellingen vast. Kwantisering of export kan normalisatie en output wijzigen, dus valideer het serveer‑artefact. Monitor prompt‑ of condition‑distributie, veiligheidsfilters, output‑diversiteit, latentie en rapporten. Gebruik snelheidslimieten en identiteitsbeschermingen in publieke systemen. GAN‑training is een gekoppeld optimalisatie‑experiment: geselecteerde voorbeeld‑beelden kunnen geen robuustheid, dekking of afwezigheid van memorisatie aantonen, en een model moet worden geëvalueerd op de volledige distributie van beoogde generatie‑taken.
Voorbeeld: synthetische defectbeelden met een GAN
Een fabrikant traint een conditionele GAN om zeldzame oppervlakte‑defectbeelden te creëren. Het verifieert dat trainingsbeelden rechten hebben en scheidt productieloten vóór training en evaluatie. Gegenereerde monsters worden gecontroleerd op naaste‑buur memorisatie, defectgeometrie, achtergrondartefacten, diversiteit en deskundige plausibiliteit. Een classifier die met synthetische augmentatie is getraind, wordt alleen geëvalueerd op onafhankelijke echte defecten, tegenover dezelfde classifier met conventionele augmentatie.
Synthetische data worden alleen geaccepteerd als de real‑world recall verbetert zonder toename van valse afwijzingen of subgroep‑fouten. Generatie‑instellingen en herkomst blijven aan elke afbeelding gekoppeld, en synthetische bestanden komen nooit in de testset of bewijsarchief als echte inspecties. Operators kunnen de generator niet gebruiken om audit‑records te fabriceren. Het team vergelijkt diffusie‑alternatieven en de kosten van het verzamelen van meer echte voorbeelden, en erkent dat een realistische uitstraling geen bewijs is dat de GAN het fysieke faalproces heeft vastgelegd.
Implementatie‑bewijs en operationele gereedheid
Een productiebeslissing vereist meer dan een succesvolle demonstratie. Definieer de beoogde gebruikers, operationele omgeving, invoer, uitvoer, afhankelijkheden, eigenaar en de consequentie van elke belangrijke fout. Stel een reproduceerbare basislijn en een versie‑gebaseerde evaluatieset vast vóór afstemming. Test gewone gevallen, randvoorwaarden, misvormde of ontbrekende invoer, distributieverandering, uitval van afhankelijkheden, misbruik, en de groepen of omgevingen die waarschijnlijk onderbediend worden. Meet taakkwaliteit samen met calibratie of onzekerheid, latentie, doorvoersnelheid, resource‑kosten, toegankelijkheid, privacy en veiligheid. Leg elke transformatie en drempel vast zodat een onafhankelijke reviewer het resultaat kan reproduceren en bewijs kan onderscheiden van een aantrekkelijk prototype.
Voor de lancering moet autoriteit voor release, uitzonderingen, wijzigingen, rollback en pensionering worden toegewezen. Gebruik een gefaseerde uitrol, behoud een veilige fallback, en verifieer monitoring met opzettelijk geïnjecteerde fouten. Operationele telemetrie moet de invoer‑kwaliteit, output‑gedrag, model‑ of regelversie, afhankelijkheids‑gezondheid, menselijke overrides en bevestigde uitkomsten onthullen zonder onnodige gevoelige data te verzamelen. Definieer alarm‑drempels en een verantwoordelijke voor de respons, en beoordeel vervolgens real‑world bewijs na de implementatie in plaats van aan te nemen dat offline prestaties blijven bestaan. Her‑evalueer telkens wanneer gegevensbronnen, gebruikers, modellen, leveranciers, beleid, hardware of doelstellingen veranderen. Een onderhouden systeem heeft ook gedocumenteerde herstel‑, incident‑leer‑, verwijder‑ en retentieprocedures nodig, en een duidelijk punt waarop het moet worden uitgeschakeld of vervangen.
Veelgestelde vragen
Begrijpt een GAN de beelden die het maakt?
Een GAN leert statistische structuren die nuttig zijn voor generatie. Dat bewijst op zichzelf geen mensachtige semantische of causale begrip.
Zijn GAN‑gegenereerde monsters veilig om als trainingsdata te gebruiken?
Alleen na controle van dekking, label‑geldigheid, memorisatie, bias en of de synthetische distributie helpt op een echte gereserveerde testset.
Primaire referenties












