
AI-basisprincipes
Wat is een beslissingsboom?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Een beslissingsboom is een supervised‑learning‑model dat een voorspelling maakt door een reeks als‑dan‑regels toe te passen. Elk intern knooppunt test een kenmerk, elke tak vertegenwoordigt een uitkomst van die test, en elk blad levert een klasse‑voorspelling, een waarschijnlijkheid of een numerieke waarde.
Beslissingsbomen worden gebruikt voor classificatie en regressie. Hun aantrekkingskracht is praktisch: ze kunnen niet‑lineaire interacties weergeven, vereisen relatief weinig voorbewerking en produceren een pad dat een persoon kan inspecteren. Hun zwakte is instabiliteit — kleine veranderingen in de trainingsdata kunnen een andere boom opleveren.
Belangrijkste punten
- Een boom partitioneert de feature‑ruimte recursief; hij hoeft niet elke trainingsobservatie te isoleren.
- Classificatiesplitsingen gebruiken vaak Gini‑impurity of entropie, terwijl regressiesplitsingen de voorspellingsfout of variantie verminderen.
- Diepte, minimale bladgrootte en snoeien beheersen complexiteit en overfitting.
- Random forests en gradient‑boosted trees verbeteren de voorspellende kracht door veel bomen te combineren.
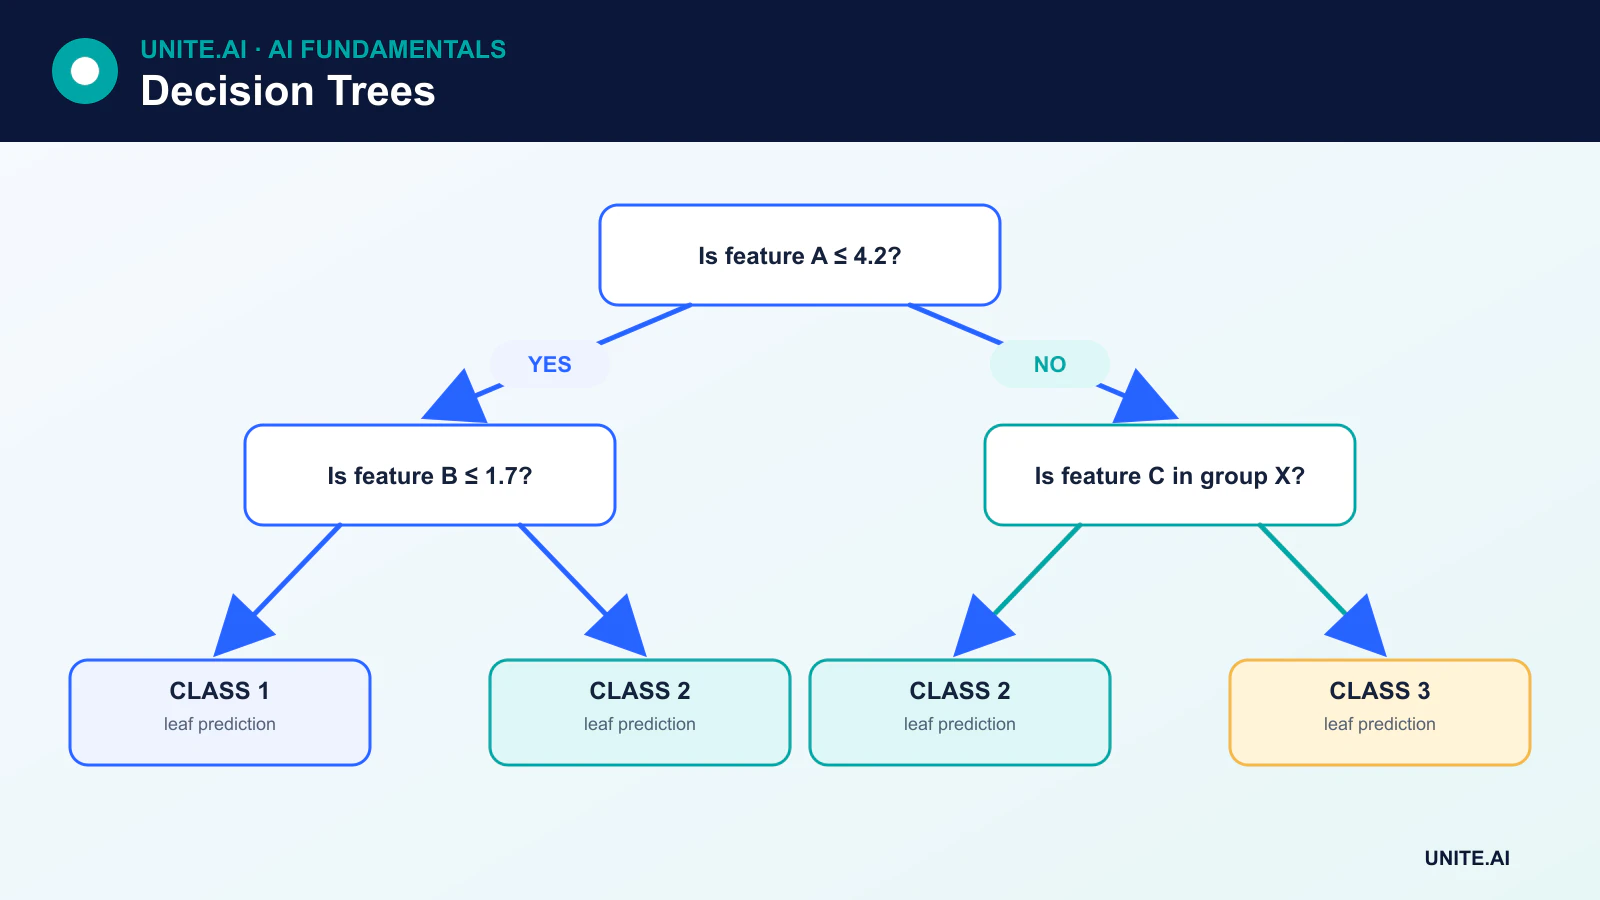
Hoe een beslissingsboom een voorspelling maakt
Stel je voor dat een model voorspelt of een machine waarschijnlijk zal falen. Het wortelknooppunt kan vragen of de trillingen een geleerde drempel overschrijden. Een tak kan vervolgens de bedrijfstemperatuur testen. De observatie bereikt een blad dat de geschatte faalkans bevat van de trainingsvoorbeelden die hetzelfde pad volgden.
Voor regressie kan het blad de gemiddelde doelwaarde van de observaties in dat gebied teruggeven. Voor classificatie kan het de meerderheidsklasse of een verdeling van klassenfrequenties teruggeven. Een blad kan veel observaties bevatten; het volledig scheiden van de trainingsdata is meestal ongewenst omdat het een overfitte boom kan opleveren.
Hoe een boom een splitsing kiest
Tijdens het trainen worden kandidaat‑kenmerken en drempels overwogen, waarna de splitsing wordt gekozen die de gedefinieerde doelstelling het meest verbetert. De verbetering moet worden gewogen op basis van hoeveel observaties naar elk kindknooppunt gaan.
Gini-impurity
Voor classificatie meet Gini‑impurity hoe gemengd de klassen in een knooppunt zijn:
Gini = 1 - Σ p(k)²
Een knooppunt dat slechts één klasse bevat heeft een impurity van nul. Een kandidaat‑splitsing is nuttig wanneer de gewogen impurity van de kinderen lager is dan die van het ouderknooppunt.
Entropie en informatiewinst
Entropie is een andere maat voor klassenonzekerheid:
Entropy = -Σ p(k) log₂ p(k)
Informatiewinst is de entropie van het ouderknooppunt min de gewogen entropie van de kinderen. Gini en entropie leveren vaak vergelijkbare bomen op, hoewel ze niet altijd identiek zijn.
Regressieverlies
Regressiebomen kiezen doorgaans splitsingen die de kwadratische fout, absolute fout of een andere regressie‑criterium verminderen. Elk blad voorspelt vervolgens een waarde op basis van de trainingsdoelen binnen dat gebied.
CART en andere boomalgoritmen
CART, of Classification and Regression Trees, gebruikt binaire splitsingen en vormt de basis van gangbare implementaties zoals de beslissingsbomen van scikit-learn. Andere algoritmen zijn ID3, C4.5 en C5.0. Implementaties verschillen in de ondersteunde split‑types, de omgang met missende waarden, snoeien en doelstellingen.
Categorische variabelen kunnen codering, directe subset‑splits of implementatiespecifieke verwerking vereisen. Missende waarden kunnen worden geïmputeerd of afgehandeld via geleerde standaardrichtingen of surrogaatsplits. Het is belangrijk het gedrag van de specifieke bibliotheek te begrijpen in plaats van aan te nemen dat elke boom‑implementatie op dezelfde manier werkt.
Boomcomplexiteit beheersen
Een diepe boom kan ruis onthouden. Veelvoorkomende controles zijn:
- Maximale diepte: beperkt de lengte van een voorspellingspad.
- Minimum aantal monsters per splitsing of blad: voorkomt kleine regio’s.
- Minimale impurity‑daling: vereist dat een splitsing voldoende voordeel oplevert.
- Maximum aantal bladeren: begrenz de totale complexiteit.
- Kosten‑complexiteit snoeien: verwijdert takken waarvan de verbetering de toegevoegde complexiteit niet rechtvaardigt.
Snoeien is een gestructureerd optimalisatieproces, geen willekeurige verwijdering. Hyperparameters moeten worden gekozen met validatiedata of cross‑validatie, terwijl de uiteindelijke testset onaangeroerd blijft.
Sterke punten en beperkingen
Beslissingsbomen kunnen interacties en drempelseffecten modelleren zonder feature‑scaling. Ze accepteren numerieke en, afhankelijk van de implementatie, categorische invoer. Voorspelling is snel, en een kleine boom is gemakkelijk te visualiseren.
Echter, een enkele boom kan een hoge variantie hebben, abrupte voorspellingsveranderingen veroorzaken nabij een splitsing, en de voorkeur geven aan kenmerken met veel mogelijke split‑punten. Bomen extrapoleren ook slecht bij regressie: buiten de waargenomen regio’s geeft een blad nog steeds een waarde terug die is geleerd van de trainingssamples. Een grote boom is mogelijk niet begrijpelijker dan een ander complex model.
Van één boom naar ensembles
Ensemble‑learning combineert meerdere modellen. Een random forest traint veel bomen op opnieuw gesamplede observaties en subsets van kenmerken, en neemt vervolgens hun voorspellingen gemiddeld. Gradient boosting bouwt bomen sequentieel zodat elke nieuwe boom de resterende fout aanpakt. Deze benaderingen presteren doorgaans beter dan één boom, maar ze geven wat interpreteerbaarheid op en voegen computationele kosten toe.
Feature‑importance van een boom of ensemble moet zorgvuldig worden geïnterpreteerd. Op impurity gebaseerde importance kan bevooroordeeld zijn, en het belang van een kenmerk bewijst geen causaliteit. Permutatie‑importance, partial‑dependence‑tools en domein‑review bieden extra context.
Hoe een boom splitsingen en voorspellingen leert
Een beslissingsboom partitioneert de feature‑ruimte recursief. Bij elk knooppunt evalueert een trainingsalgoritme kandidaat‑feature‑drempels of categorische partities en selecteert een splitsing die de impurity het meest vermindert, zoals Gini‑impurity of entropie voor classificatie en kwadratische fout voor regressie. Bladeren slaan een klassendistributie of numerieke voorspelling op op basis van de trainingsobservaties die hen bereiken. Gierige splitsing is computationeel praktisch maar garandeert niet de globaal beste boom, en verschillende monsters of tiebreaking kunnen verschillende structuren opleveren.
Continue, ordinale, categorische en missende features vereisen expliciete verwerking. One‑hot‑encoding kan veel kandidaat‑splitsingen creëren; native categorische methoden kunnen geordende statistieken gebruiken maar hebben een lek‑veilige implementatie nodig. Bomen vereisen geen scaling, maar kunnen variabelen met hoge cardinaliteit bevoordelen en kleine groepen isoleren. Diepte, minimale bladgrootte, minimale impurity‑daling en kosten‑complexiteit snoeien beheersen variantie. Kies deze met validatiedata en evalueer calibratie, omdat een blad‑kans gebaseerd op weinig gevallen extreem en onstabiel kan zijn.
Interpretatie, faalmodi en gebruik in productie
Een pad van wortel tot blad is een exacte regel voor één modelvoorspelling, maar het is niet automatisch een causale verklaring. Gecorreleerde variabelen kunnen elkaar vervangen, kleine dataveranderingen kunnen bovenste splitsingen wijzigen, en een eenvoudig ogend pad kan afhankelijk zijn van bevooroordeelde labels. Globale feature‑importance gebaseerd op impurity kan misleidend zijn; permutatie‑importance, partial‑dependence en tegenfeitelijke controles voegen context toe maar hebben ook aannames. Rapporteer onzekerheid en test of een vermeende regel standhoudt op onafhankelijke data en relevante subgroepen.
Enkele bomen zijn nuttig wanneer transparantie, lage latentie en een bescheiden niet‑lineaire structuur belangrijk zijn, maar ensembles bieden doorgaans een sterkere voorspellende prestatie. Valideer grensgedrag, zeldzame categorieën, missende waarden en invoer buiten het trainingsbereik. Geëxporteerde regels moeten de trainings‑preprocessing en numerieke vergelijkingen exact reproduceren. Monitor blad‑bezetting, output‑distributie, fouten en opkomende categorieën. Een boom die veel nieuwe gevallen naar een klein of eerder leeg gebied leidt, moet een review activeren, zelfs als de aggregaat‑drift klein blijft. Houd een fallback voor ongeldige schema’s en documenteer elke snoei‑ of drempelbeslissing.
Voorbeeld: een interpreteerbare krediettriageboom
Een kredietverstrekker gebruikt een boom uitsluitend om onvolledige aanvragen te prioriteren voor handmatige beoordeling, niet om krediet goed te keuren of af te wijzen. Het doel is een gedocumenteerde volledigheidsuitkomst, en kenmerken die bij intake beschikbaar zijn, sluiten latere beslissingen uit. Groeps‑tijdelijke validatie vergelijkt een ondiepe gesnoeide boom met regels en logistische regressie. Minimale bladgrootte voorkomt regels gebaseerd op een handvol aanvragers, terwijl calibratie en klasse‑specifieke fouten worden gerapporteerd over kanalen en relevante beschermde groepen.
Beoordelaars zien het exacte pad en de bronwaarden, maar kunnen foutieve data corrigeren en de routing overschrijven. De organisatie test gecorreleerde proxy’s en tegenfeitelijke veranderingen, monitort blad‑bezetting en missende waarden, en beschouwt plotseling verkeer naar een klein blad als een datakwaliteitsincident. Beleidswijzigingen creëren een nieuwe modelversie en validatie, geen ongedocumenteerde split‑bewerking. Omdat het gebruik invloed heeft op toegang en last, ontvangen aanvragers een menselijk kanaal en wordt de boom nooit gepresenteerd als een causale verklaring van kredietwaardigheid.
Implementatie‑bewijs en operationele gereedheid
Een productie‑beslissing vereist meer dan een succesvolle demonstratie. Definieer de beoogde gebruikers, operationele omgeving, invoer, uitvoer, afhankelijkheden, eigenaar en de consequentie van elke belangrijke fout. Stel een reproduceerbare basislijn en een versie‑gebaseerde evaluatieset vast vóór afstemming. Test gewone gevallen, randvoorwaarden, misvormde of missende invoer, distributieverandering, afhankelijkheidsuitval, misbruik, en de groepen of omgevingen die waarschijnlijk onderbediend worden. Meet taakkwaliteit samen met calibratie of onzekerheid, latentie, doorvoersnelheid, resource‑kosten, toegankelijkheid, privacy en beveiliging. Leg elke transformatie en drempel vast zodat een onafhankelijke reviewer het resultaat kan reproduceren en bewijs kan onderscheiden van een aantrekkelijk prototype.
Voor de lancering moet autoriteit worden toegewezen voor release, uitzonderingen, wijzigingen, rollback en pensionering. Gebruik een gefaseerde uitrol, behoud een veilige fallback, en verifieer monitoring met opzettelijk geïnjecteerde fouten. Operationele telemetrie moet de invoer‑kwaliteit, output‑gedrag, model‑ of regelversie, afhankelijkheidsgezondheid, menselijke overrides en bevestigde uitkomsten onthullen zonder onnodige gevoelige data te verzamelen. Definieer alarm‑drempels en een verantwoordelijke voor respons, en beoordeel vervolgens bewijsmateriaal uit de praktijk na de uitrol in plaats van aan te nemen dat offline prestaties aanhouden. Her‑evalueer telkens wanneer gegevensbronnen, gebruikers, modellen, leveranciers, beleid, hardware of doelstellingen veranderen. Een onderhouden systeem heeft ook gedocumenteerd herstel, incident‑leren, verwijder‑ en retentie‑procedures nodig, en een duidelijk punt waarop het moet worden uitgeschakeld of vervangen.
Primaire referenties












