AI-basisprincipes
Wat is Overfitting?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Overfitting treedt op wanneer een model patronen of ruis vastlegt die uitzonderlijk goed werken op de trainingsdata, maar niet generaliseren naar nieuwe voorbeelden. Een overfit model kan een zeer lage trainingsfout hebben, terwijl de validatie‑ of real‑world‑prestaties aanzienlijk slechter zijn.
Het tegenovergestelde probleem is underfitting: het model of het trainingsproces kan zelfs op de trainingsset niet genoeg signaal vastleggen. Goed modelleren balanceert fit en generalisatie in plaats van te streven naar perfecte trainingsprestaties.
Belangrijkste conclusies
- Alleen trainingsprestaties kunnen generalisatie niet diagnosticeren.
- Early stopping moet de validatie‑gedrag gebruiken, nooit herhaalde beslissingen op de uiteindelijke testset.
- Meer data kan helpen, maar meer features of capaciteit kan overfitting ook verergeren.
- Regularisatie, augmentatie, cross‑validatie, lekpreventie en een passende evaluatie pakken verschillende oorzaken aan.
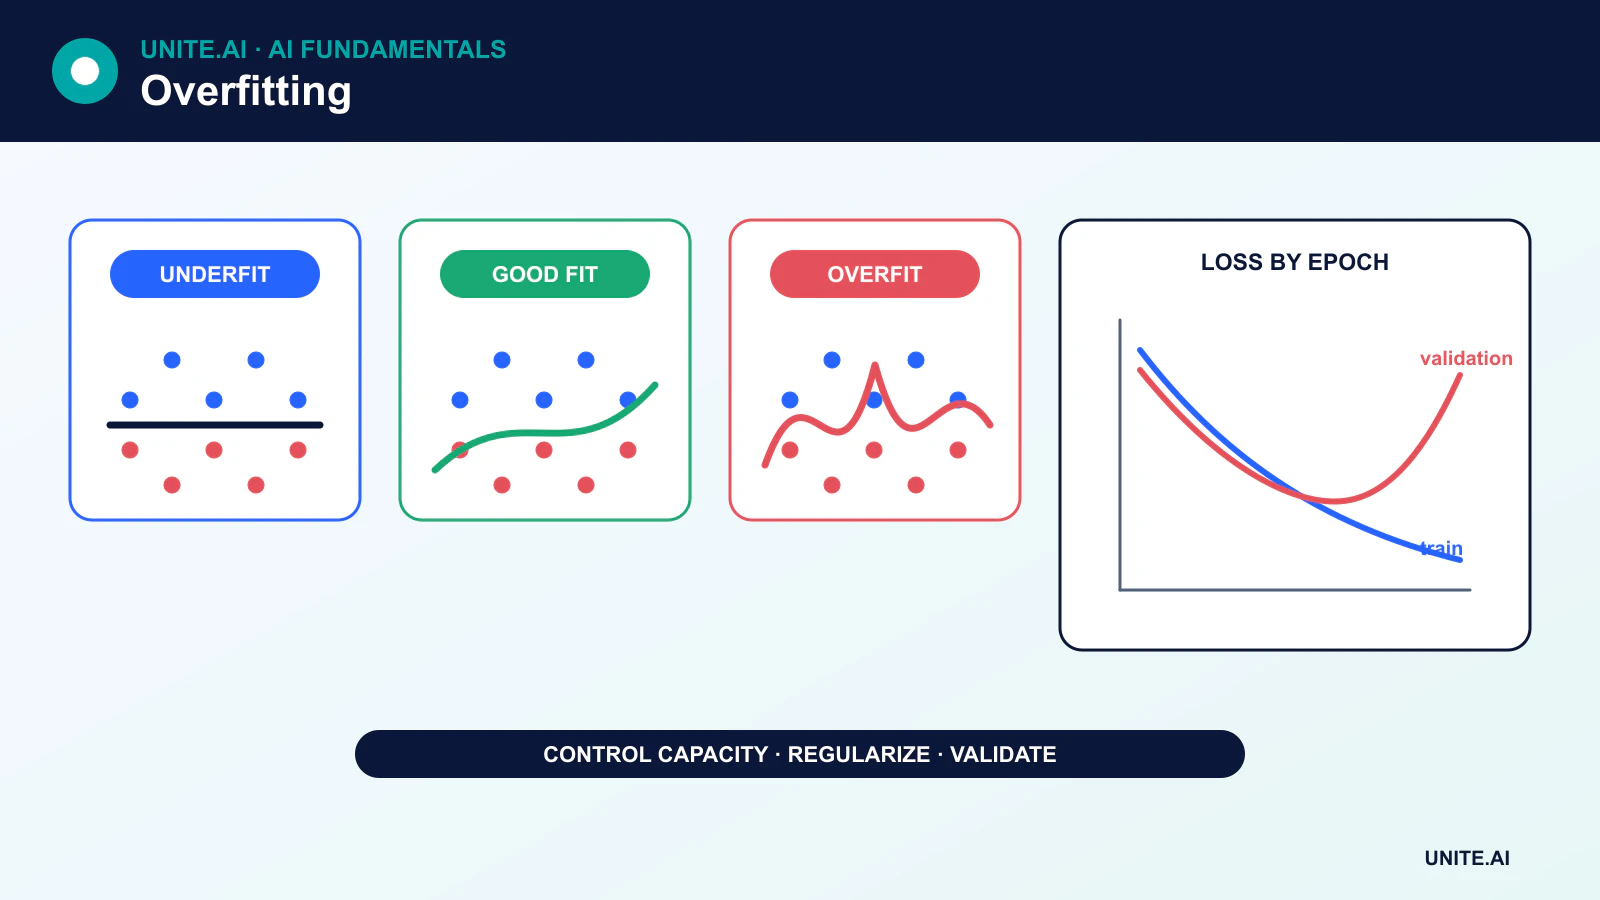
Fit, underfitting en overfitting
Een model underfit wanneer zijn aannames te restrictief zijn, zijn features belangrijke signalen weglaten, de optimalisatie ontoereikend is of de training onvoldoende is. Het toevoegen van relevante features of capaciteit kan helpen, maar het willekeurig toevoegen van features kan ruis en overfitting vergroten.
Een model overfit wanneer zijn effectieve capaciteit te hoog is ten opzichte van de informatie in de trainingsdata. Voorbeelden zijn een diepe decision tree die kleine bladeren maakt, een polynoom die willekeurige fluctuaties volgt, of een neuraal netwerk dat voorbeelden uit het hoofd leert.
De rol van trainings-, validatie- en testdata
- Trainingsdata past modelparameters aan.
- Validatiedata selecteert architectuur, hyperparameters, drempels en het stopmoment.
- Testdata levert een definitieve schatting nadat die keuzes zijn gemaakt.
Als de testset herhaaldelijk beslissingen stuurt, wordt deze onderdeel van het ontwikkelingsproces en levert ze geen onbevooroordeelde eindschatting meer op. Cross‑validatie kan efficiënter gebruikmaken van beperkte data, maar alle preprocessing en feature‑selectie moeten binnen elke trainingsfold plaatsvinden.
Early stopping
Tijdens het trainen daalt de trainingsloss meestal gestaag. De validatieloss kan aanvankelijk dalen en later stijgen wanneer het model zich specialiseert op trainingsruis. Early stopping bewaart het checkpoint met de beste validatiedoelstelling of stopt nadat de validatie gedurende een gedefinieerde patience‑periode niet meer is verbeterd.
Het juiste checkpoint is niet dat met de laagste trainingsloss. Een aparte definitieve testset wordt geëvalueerd nadat early stopping en afstemmingsbeslissingen zijn afgerond.
Regularisatiemethoden
Gewichtsstraffen
L2-regularisatie of weight decay ontmoedigt grote parameterwaarden. L1-regularisatie kan sparsere coëfficiënten stimuleren. Hun effecten hangen af van het model en de optimizer; AdamW bijvoorbeeld ontkoppelt weight decay van de adaptieve update.
Dropout en stochastische regularisatie
Dropout maskeert willekeurig activaties tijdens het trainen. Andere methoden laten paden vallen, verstoren features of verzachten labels. Deze technieken wijzigen de trainingsdoelstelling en moeten bij inferentie uitgeschakeld of op passende wijze behandeld worden.
Data‑augmentatie
Augmentatie creëert realistische variaties — zoals uitsnedes, rotaties, ruis of parafraseringen — die het doel moeten behouden. Ongeldige transformaties kunnen het label wijzigen en het model schaden. Voor vision helpen tools zoals Albumentations bij het implementeren van gecontroleerde pipelines.
Capaciteitsbeheersing
Minder diepe bomen, minder parameters, feature‑selectie, pruning en eenvoudigere hypotheseklassen kunnen de variantie verminderen. Tree pruning is criterium‑gedreven, niet willekeurige verwijdering van geleerde details.
Data‑lekkage kan eruitzien als uitzonderlijke prestaties
Lekkage treedt op wanneer informatie die bij voorspelling niet beschikbaar is, in de training of evaluatie terechtkomt. Veelvoorkomende voorbeelden zijn het normaliseren op de volledige dataset, het splitsen van herhaalde records over folds, het gebruiken van toekomstige data om het verleden te voorspellen, of het opnemen van een feature die is afgeleid van het target.
Lekkage is geen gewone overfitting, maar creëert dezelfde misleidende kloof tussen offline resultaten en productie. De splitsingsstrategie moet rekening houden met tijd, identiteit, locatie en data‑generatieprocessen.
Distributieverschuiving is een apart probleem
Een model kan generaliseren naar zijn testdistributie en toch falen wanneer productiedata verandert. Nieuwe apparaten, beleidsregels, populaties, seizoenen of adversarieel gedrag kunnen de relatie tussen input en target verschuiven. Monitoring en periodieke her‑evaluatie zijn noodzakelijk, zelfs wanneer het oorspronkelijke model niet overfit was.
Diagnostiseren van overfitting
Gebruik leercurves, cross‑validatievariantie, subgroep‑metriek, calibratie en foutinspectie. Als zowel trainings‑ als validatieprestaties slecht zijn, richt je dan op underfitting, features, labels of optimalisatie. Als de training sterk is en de validatie zwak, onderzoek dan capaciteit, lekkage, regularisatie en representativiteit voordat je simpelweg meer data verzamelt.
Waarom overfitting gebeurt en hoe het te detecteren
Overfitting treedt op wanneer een model patronen leert die de trainingsfout verminderen maar niet generaliseren naar de doelpopulatie. Oorzaken omvatten een te hoge capaciteit ten opzichte van effectieve data, labelruis, herhaalde entiteiten, flexibele feature‑selectie, lekkage en afstemming op dezelfde validatieset. Een groeiende kloof tussen training‑ en validatieprestaties is veelvoorkomend bewijs, maar een kleine kloof sluit overfitting niet uit als beide sets besmetting delen of afwijken van productie. Leercurves over datavolume en capaciteit helpen variantie van bias te onderscheiden.
Lekkage is bijzonder misleidend: toekomstige informatie, duplicaten, overlap van subjecten, preprocessing op alle data, of labels gecodeerd in metadata kunnen uitstekende scores op achtergehouden data opleveren. Splits op de eenheid die nieuw zal zijn bij inzet — patiënt, klant, machine, locatie of tijd — voordat transformaties of augmentaties worden toegepast. Houd een definitieve testset afgesloten tijdens het kiezen van features, architectuur en drempels. Als teams herhaaldelijk testresultaten inspecteren, wordt de testset een andere validatieset en moet deze vervangen of formeel gecorrigeerd worden.
Regularisatie, modelselectie en productiedrift
Verminder overfitting met meer representatieve data, lagere capaciteit, weight decay, dropout, early stopping, augmentatie, ensembles of beperkingen die de domeinstructuur weerspiegelen. Elke methode heeft afwegingen: augmentatie kan labels vervormen, dropout verandert optimalisatie, en ensembles verhogen de serving‑kosten. Cross‑validatie schat de variabiliteit van selectie, maar gegroepeerde of tijd‑bewuste folds moeten de inzetgrens behouden. Vergelijk met een eenvoudig model en rapporteer onzekerheid over folds of seeds in plaats van de meest gunstige run te selecteren.
Productie kan een andere vorm van generalisatiefout onthullen wanneer inputs, gebruikers, incentives of metingen veranderen. Monitor feature‑ en predictiedistributies, calibratie, subgroepresultaten en vertraagde ground truth. Retrain niet automatisch op onbeoordeelde feedback; de beslissingen van het model kunnen de labels die later worden gezien beïnvloeden. Diagnose of de fout voortkomt uit drift, datapijplijnen, beleidswijzigingen of een ongeldig target. Overfitting wordt beheerst door experimenteel ontwerp en levenscyclusdiscipline, niet door één enkele regularisatie‑instelling.
Voorbeeld: lekken elimineren in een fraudemodel
Een initiële fraude‑classifier scoort extreem goed omdat herhaalde kaart‑ en handelaar‑gebeurtenissen in willekeurige train‑ en test‑rijen voorkomen, en chargeback‑informatie die weken later wordt geregistreerd als feature wordt meegenomen. Het team reconstrueert de beschikbaarheidstijd van elke feature, verwijdert post‑beslissingsvelden, groepeert per account en gebruikt een forward‑time‑split. De prestaties dalen scherp, maar schatten nu de daadwerkelijke beslissing. Een eenvoudige regel‑baseline en leercurves sturen de benodigde modelcomplexiteit.
Regularisatie en early stopping worden alleen binnen historische folds afgestemd. De uiteindelijke evaluatie rapporteert precisie bij review‑capaciteit, recall, calibratie en kosten per fraude‑type en klantsegment. In productie komen bevestigde labels laat binnen en zijn ze bevooroordeeld door welke transacties werden beoordeeld, waardoor monitoring score‑drift scheidt van uitkomstschattingen. Retraining maakt gebruik van geadjudiceerde gevallen en replay tegen het huidige beleid. Het project geeft de voorkeur aan een lagere eerlijke score boven een hoge gelekte score die de productie niet overleeft.
Implementatie‑bewijs en operationele gereedheid
Een productiebeslissing vereist meer dan een succesvolle demonstratie. Definieer de beoogde gebruikers, operationele omgeving, inputs, outputs, afhankelijkheden, eigenaar en de consequentie van elke belangrijke fout. Stel een reproduceerbare basislijn en een versie‑gecontroleerde evaluatieset vast vóór afstemming. Test gewone gevallen, grensvoorwaarden, misvormde of ontbrekende input, distributieverschuiving, afhankelijkheidsuitval, misbruik, en de groepen of omgevingen die waarschijnlijk onderbediend worden. Meet taakkwaliteit samen met calibratie of onzekerheid, latency, doorvoersnelheid, resource‑kosten, toegankelijkheid, privacy en beveiliging. Leg elke transformatie en drempel vast zodat een onafhankelijke reviewer het resultaat kan reproduceren en bewijs kan scheiden van een aantrekkelijk prototype.
Voor de lancering moet autoriteit worden toegewezen voor release, uitzonderingen, wijzigingen, rollback en pensionering. Gebruik een gefaseerde uitrol, behoud een veilige fallback, en verifieer monitoring met opzettelijk geïnjecteerde fouten. Operationele telemetrie moet de input‑kwaliteit, output‑gedrag, model‑ of regelversie, afhankelijkheidsgezondheid, menselijke overrides en bevestigde uitkomsten onthullen zonder onnodige gevoelige data te verzamelen. Definieer alarm‑drempels en een verantwoordelijke voor respons, en beoordeel vervolgens real‑world‑bewijs na inzet in plaats van aan te nemen dat offline prestaties blijven bestaan. Her‑evalueer telkens wanneer datasources, gebruikers, modellen, leveranciers, beleid, hardware of doelstellingen veranderen. Een onderhouden systeem heeft ook gedocumenteerd herstel, incident‑leren, verwijder‑ en retentieprocedures, en een duidelijk punt waarop het moet worden uitgeschakeld of vervangen nodig.
Veelgestelde vragen
Kan een eenvoudig model overfitten?
Ja. Herhaalde feature‑selectie, drempel‑afstemming of evaluatie op dezelfde hold‑out kan het ontwikkelingsproces overfitten, zelfs wanneer het uiteindelijke model eenvoudig is.
Lost meer trainingsdata altijd overfitting op?
Nee. Meer representatieve, correct gelabelde data kan helpen, maar gedupliceerde, bevooroordeelde, gelekte of out‑of‑domain‑data mogelijk niet. Het leerdoel en het evaluatie‑ontwerp blijven belangrijk.
Primaire referenties