
AI-basisprincipes
Kant-en-klare versus aangepaste machine learning-modellen

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
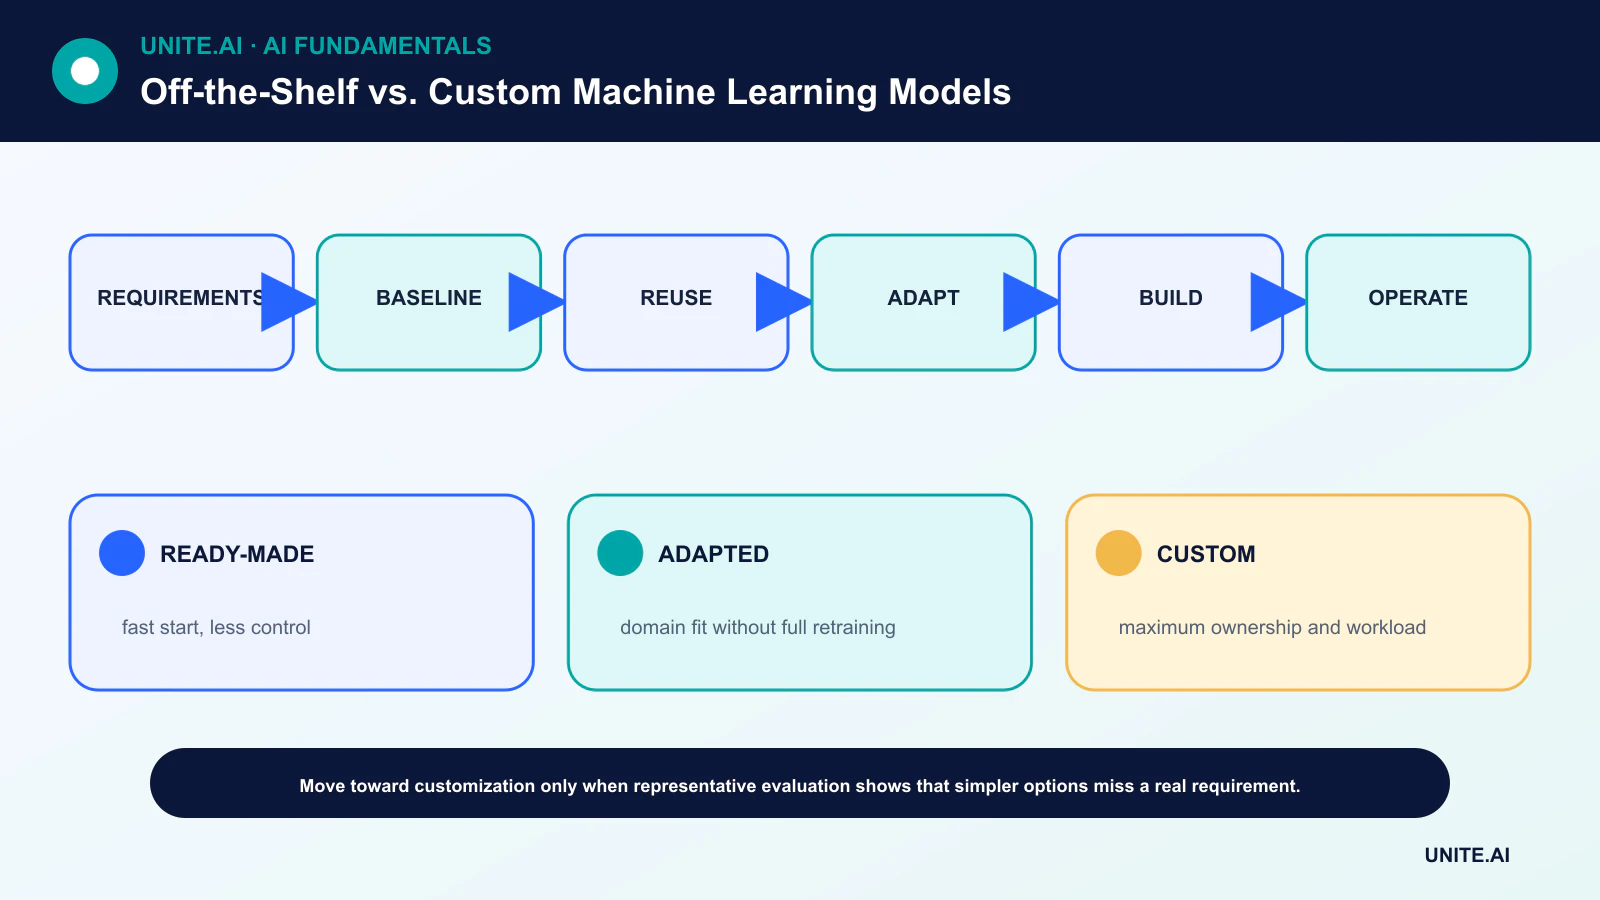
Het kiezen van een machine‑learning‑oplossing is zelden een eenvoudige koop‑tegen‑bouw‑beslissing. Het echte continuüm loopt van een gehoste API of verpakte model, via prompten, retrieval en fine‑tuning, tot een volledig aangepaste architectuur die is getraind op organisatiespecifieke data.
De beste optie is de minst complexe aanpak die voldoet aan een geverifieerde productvereiste. Een aangepast model kan controle en differentiatie bieden, maar het creëert ook een voortdurende verplichting om datapijplijnen, evaluaties, monitoring, beveiliging, updates en rollback te beheren.
Belangrijkste conclusies
- Begin met een meetbare taak, een niet‑ML‑baseline en acceptatiedrempels.
- Evalueer kandidaatmodellen op representatieve private data in plaats van alleen publieke benchmark‑scores.
- Neem integratie, latency, beoordeling, retraining en incidentkosten op in de totale eigendomskosten.
- Geef de voorkeur aan omkeerbare fasen: baseline, ophalen of prompten, fine‑tunen, en train dan vanaf nul alleen wanneer bewijs dit ondersteunt.
Definieer de beslissing voordat u een model kiest
Specificeer de gebruiker, beslissing, invoer, uitvoer, foutkosten, latency‑budget, verkeerspatroon en escalatieroute. Bepaal of een deterministische regel of zoek‑systeem voldoende van het probleem oplost. De Rules of ML van Google raden eenvoudige baselines en betrouwbare infrastructuur aan vóór complexe modellering.
Maak een offline evaluatieset die de productie weerspiegelt, inclusief zeldzame en adversariale gevallen. Waar beslissingen mensen raken, definieer subgroepcontroles en regels voor menselijke beoordeling. Deze poorten maken vergelijkingen concreet in plaats van de architectuurkeuze tot een voorkeur te maken.
Het hergebruik‑ en adaptatiecontinuüm
Een gehoste API biedt snelle integratie en beheerde schaalbaarheid, maar beperkte controle over model‑internals, versies en gegevensverwerking. Een open voorgetraind model vergroot de implementatie‑controle. Retrieval of prompt‑engineering kan domeincontext toevoegen zonder de gewichten te wijzigen.
Fine‑tuning of parameter‑efficiënte adapters kan gedrag specialiseren. Trainen vanaf nul is alleen gerechtvaardigd wanneer de data, doelstelling, schaal of eigendomsvereiste niet via hergebruik kan worden vervuld. Transfer learning legt vaak het grootste deel van de waarde vast met aanzienlijk minder data en rekenkracht.
Kwaliteit, controle en lock‑in
Meet de taakkwaliteit, kalibratie, latency, doorvoersnelheid, beschikbaarheid en foutconsistentie. Een vendor‑model kan automatisch verbeteren, maar kan ook gedrag wijzigen; een zelfgehost model kan vastgezet worden, maar vereist dat het team upgrades en kwetsbaarheden beheert.
Contractuele voorwaarden moeten data‑retentie, trainingsgebruik, regionale verwerking, intellectueel eigendom, serviceniveaus, exportpaden en veroudering behandelen. Portabiliteit verbetert wanneer de applicatie model‑specifieke adapters scheidt van de bedrijfslogica en reproduceerbare evaluatie‑artefacten opslaat.
Privacy, veiligheid en operaties
Breng elke gegevensstroom en bedreigingsgrens in kaart. Gevoelige invoer kan privé‑netwerken, on‑premise inferentie of edge‑AI vereisen. Zelf‑hosting maakt een systeem niet automatisch veilig; het draagt de verantwoordelijkheid voor beveiliging en naleving over op de operator.
Productie‑eigendom omvat observeerbaarheid, drift‑controles, misbruikmonitoring, incidentrespons en rollback. Het operationele team moet kunnen aangeven welk model, welke prompt, welke dataversie en welk beleid een resultaat heeft opgeleverd.
Gebruik gefaseerd bewijs, niet ideologie
Voer een tijdgebonden benchmark uit met dezelfde dataset en acceptatiecriteria over alle opties. Schat de engineering‑tijd, annotatie, accelerator‑gebruik, vendor‑kosten, beoordelingsarbeid, foutkosten en de verwachte frequentie van verandering.
Kies de eenvoudigste kandidaat die de poorten passeert, en evalueer vervolgens opnieuw wanneer vereisten of prijzen veranderen. Maatwerk is waardevol wanneer het meetbaar voordeel of noodzakelijke controle oplevert — niet alleen omdat een op maat gemaakt model strategisch belangrijk klinkt.
Vereisten en totaal‑kostenvergelijking
Een kant‑en‑klare model, API of verpakt systeem biedt vooraf gebouwde functionaliteit met vendor‑ondersteuning en snellere initiële implementatie. Een aangepast model wordt getraind of aanzienlijk aangepast voor een specifieke taak, data en operationele omgeving. De keuze begint met vereisten: doelresultaat, kwaliteit per subgroep en randgeval, latency, doorvoersnelheid, beschikbaarheid, uitlegbaarheid, data‑residentie, update‑controle, integratie, beveiliging en falen‑gevolg. Een generieke benchmark of demo kan niet beantwoorden of een product aan die vereisten voldoet.
Totale kosten omvatten evaluatie, datavoorbereiding, labeling, integratie, licenties of gebruik, infrastructuur, monitoring, beoordeling, incidentrespons, upgrades en exit. Kant‑en‑klaar verlaagt de initiële engineering, maar kan variabele kosten, lock‑in, gedragsveranderingen en beperkte observeerbaarheid veroorzaken. Aangepaste ontwikkeling voegt data‑ en MLOps‑verantwoordelijkheid toe en kan nog steeds afhankelijk zijn van voorgetrainde gewichten en vendors. Modelkosten moeten worden gemeten per succesvolle taak met de vereiste kwaliteit, niet per token of trainingsrun alleen.
Evaluatie, inkoop en adaptatie
Stel een representatieve private testset op vóór de vendor‑selectie en voer elke kandidaat uit onder identieke prompts, preprocessing, drempels en operationele limieten. Neem ambiguëteit, adversariale, niet‑ondersteunde, meertalige en hoog‑gevolg‑gevallen op. Meet nauwkeurigheid, kalibratie, latency, kosten, weigering, beveiliging en impact op menselijke workflows. Test API‑uitval, rate‑limits, regionaal gedrag en versie‑wijzigingen. Vendor‑claims vereisen documentatie over training, rechten, privacy, retentie, subprocessors, veiligheid, ondersteuning en incident‑notificatie.
Adaptatie‑opties vormen een spectrum: configuratie, retrieval, prompting, fine‑tuning, parameter‑efficiënte updates, aangepaste heads of training vanaf nul. Gebruik de minst complexe methode die aan het bewijs voldoet. Retrieval is geschikt voor vaak wisselende kennis; tuning kan formaat‑ of domeingedrag vormgeven; deterministische code moet exacte regels afhandelen. Valideer gecombineerde systemen omdat een sterk basismodel nog steeds kan falen door slechte retrieval, permissies of integratie.
Levenscyclus en exit‑planning
Gehoste producten kunnen veranderen of verdwijnen, terwijl aangepaste modellen technische schuld worden zonder eigenaren. Houd rekening met versie‑afhankelijkheden, monitor gedrag en uitkomsten, definieer triggers voor retraining of her‑evaluatie, en onderhoud rollback. Bewaar data en interfaces die nodig zijn om te migreren, onderhandel over verwijdering en export, en vermijd het blootstellen van het proprietaire schema van één vendor door de hele applicatie. De beste keuze kan hybride: commerciële capaciteit voor standaardtaken en aangepaste componenten waar domeinprestaties, controle of risico duurzame waarde creëren.
Voorbeeld: kiezen van een document‑extractiemodel
Een bedrijf stelt een private testset van facturen op over leveranciers, talen, scans, handschrift en randgevallen, en vergelijkt vervolgens een beheerde API, open voorgetraind model, aangepast model en een regels‑baseline. Het beoordeelt veld‑nauwkeurigheid, monetaire fouten, niet‑ondersteunde documenten, latency, doorvoersnelheid, privacy, residentie, integratie en kosten per correct verwerkte factuur. Vendor‑demo’s en publieke benchmarks vervangen deze gerichte evaluatie niet.
De gekozen hybride oplossing maakt gebruik van een commerciële OCR‑service met lokale validatie en menselijke beoordeling voor lage vertrouwensscores of hoge bedragen. Contracten definiëren retentie, subprocessors, updates en verwijdering; de architectuur bewaart bronbestanden en een exit‑pad. Een schaduw‑periode detecteert schema‑ en leverancierstekorten. Monitoring scheidt OCR, extractie, validatie en correcties van reviewers. Als het vendor‑gedrag verandert, kan het team bevriezen, overschakelen of meer werk naar de eigen component verplaatsen zonder de financiële workflow opnieuw te moeten schrijven.
Implementatie‑bewijs en operationele gereedheid
Een productie‑beslissing vereist meer dan een succesvolle demonstratie. Definieer de beoogde gebruikers, operationele omgeving, invoer, uitvoer, afhankelijkheden, eigenaar en de consequentie van elke belangrijke fout. Stel een reproduceerbare baseline en een versie‑gebaseerde evaluatieset op vóór het tunen. Test gewone gevallen, randvoorwaarden, misvormde of ontbrekende invoer, distributieverandering, afhankelijkheidsuitval, misbruik, en de groepen of omgevingen die waarschijnlijk onderbediend zijn. Meet taakkwaliteit samen met kalibratie of onzekerheid, latency, doorvoersnelheid, resource‑kosten, toegankelijkheid, privacy en beveiliging. Leg elke transformatie en drempel vast zodat een onafhankelijke reviewer het resultaat kan reproduceren en bewijs kan scheiden van een aantrekkelijk prototype.
Voor de lancering moet autoriteit worden toegewezen voor release, uitzonderingen, wijzigingen, rollback en pensionering. Gebruik een gefaseerde uitrol, behoud een veilige fallback, en verifieer monitoring met opzettelijk geïnjecteerde fouten. Operationele telemetrie moet de invoer‑kwaliteit, uitvoer‑gedrag, model‑ of regelversie, afhankelijkheidsstatus, menselijke overrides en bevestigde uitkomsten onthullen zonder onnodige gevoelige data te verzamelen. Definieer alarm‑drempels en een respons‑eigenaar, en beoordeel vervolgens real‑world bewijs na de implementatie in plaats van aan te nemen dat offline prestaties behouden blijven. Evalueer opnieuw wanneer gegevensbronnen, gebruikers, modellen, vendors, beleidsregels, hardware of doelstellingen veranderen. Een onderhouden systeem heeft ook gedocumenteerde herstel‑, incident‑leer‑, verwijderings‑ en retentie‑procedures nodig, en een duidelijk punt waarop het moet worden uitgeschakeld of vervangen.
Veelgestelde vragen
Wanneer moet een team een model vanaf nul trainen?
Wanneer voorgetrainde of gehoste opties niet aan gevalideerde vereisten kunnen voldoen en het team voldoende eigen data, rekencapaciteit, expertise en langdurige operationele capaciteit heeft.
Is een kant‑en‑klare model onderhoudsvrij?
Nee. Integratie, evaluatie, versie‑wijzigingen, monitoring, privacy‑controles en fallback‑gedrag blijven de verantwoordelijkheid van de adoptant.
Primaire referenties











