
AI-basisprincipes
Wat is platformengineering? Platforms, ontwikkelaarservaring en guardrails

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Platform engineering is de praktijk van het bouwen en exploiteren van gedeelde interne mogelijkheden die software‑teams helpen applicaties te leveren en te draaien via ondersteunde self‑service‑workflows. Het platform wordt behandeld als een product waarvan de gebruikers ontwikkelaars en andere technische teams zijn.
Een platform is niet automatisch een portal, Kubernetes‑cluster of een verzameling scripts. Het wordt nuttig wanneer het de cognitieve belasting en doorlooptijd vermindert, terwijl het betrouwbaarheid, beveiliging, observeerbaarheid en organisatorische consistentie verbetert.
Belangrijkste conclusies
- Begin met onderzoek naar ontwikkelaars en terugkerende frictie, niet met een vooraf bepaalde tool‑stack.
- Bied optionele, ondersteunde gouden paden aan met duidelijke ontsnappingsroutes voor legitieme uitzonderingen.
- Stel mogelijkheden beschikbaar via API:s, sjablonen, automatisering en documentatie; een portal is slechts één interface.
- Meet gebruikersresultaten en productadoptie samen met levering, betrouwbaarheid, beveiliging en kosten.
Platform als intern product
Een platformteam identificeert interne gebruikers, trajecten, pijnpunten en gewenste resultaten. Het onderhoudt een roadmap, serviceniveaus, documentatie, ondersteuning en feedbackloops zoals elk productteam. Adoptie wordt verdiend door bruikbaarheid, niet opgelegd door het benoemen van een centraal team.
Dit breidt de samenwerking met DevOps uit. Applicatieteams behouden eigenaarschap over hun services, terwijl het platform herbruikbare mogelijkheden en beleid levert.
Mogelijkheden, portals en gouden paden
Mogelijkheden kunnen onder meer repositories, omgevingen, CI/CD, geheimen, identiteit, infrastructuur, observeerbaarheid, servicecatalogi, kosten en incidentintegratie omvatten. Een ontwikkelaarportal kan ze blootstellen, maar orkestratie en operationele services maken het platform echt.
Een gouden pad is een goed ondersteunde manier om een veelvoorkomende taak uit te voeren. Het moet veilige standaardinstellingen coderen en transparant blijven. Teams hebben een beheerd uitzonderingspad nodig wanneer de eisen verschillen.
Architectuur en guardrails
Gebruik stabiele interfaces en declaratieve API:s zodat het platform erachter kan evolueren. Scheid het control‑plane van workloads, beperk de reikwijdte van referenties, bewaar eigendom‑metadata en maak gegenereerde wijzigingen controleerbaar en omkeerbaar.
Integreer DevSecOps‑controles, beleid en artefact‑herkomst in workflows. Guardrails moeten snelle feedback en bruikbare remedie bieden in plaats van onverklaarde weigeringen.
Meten en evolueren
Meet de tijd tot eerste implementatie, doorlooptijd, herstel van mislukte wijzigingen, platformbeschikbaarheid, ondersteuningslast, adoptie, tevredenheid, beveiligingsstatus en kosten. Vermijd het tellen van portal‑logins als een proxy voor verbeterde levering.
Instrumenteer het platform via IT operations praktijken en interview gebruikers regelmatig. Verwijder ongebruikte paden, standaardiseer waar herhaling kostbaar is, en sta diversiteit toe waar het productwaarde creëert.
Interne ontwikkelaarsplatformen en gouden paden
Een intern ontwikkelaarsplatform is een product dat goedgekeurde infrastructuur en operationele mogelijkheden via self‑service‑interfaces blootstelt. Het kan een portal, servicecatalogus, sjablonen, API:s, command‑line‑tools, implementatieworkflows, geheimen, omgevingen en observeerbaarheid combineren. Het platform vervangt de cloud of Kubernetes niet; het organiseert ze tot bruikbare mogelijkheden.
Een gouden pad is een opinie‑gedreven, ondersteunde manier om een veelvoorkomende taak te voltooien, zoals het creëren van een service met een repository, CI‑pipeline, runtime, dashboards, meldingen en eigendom‑metadata. Het moet de gemakkelijkste veilige optie zijn, terwijl gerechtvaardigde uitzonderingen worden toegestaan. Een verplicht pad dat geen echte workloads kan ondersteunen, wordt een knelpunt of wordt omzeild.
Platformteams moeten ontwikkelaars behandelen als klanten en mogelijkheden als producten. Ontdekkingsinterviews, gebruiksanalyses, ondersteuningsdata, roadmaps, documentatie en service‑level‑doelen zijn even belangrijk als automatisering. Adoptie is bewijs van bruikbaarheid, maar adoptie alleen bewijst niet dat levering, betrouwbaarheid, beveiliging of de ontwikkelaarservaring zijn verbeterd.
Control‑planes, interfaces en operationeel model
Het platform‑control‑plane brengt de verklaarde intentie van een ontwikkelaar in overeenstemming met onderliggende resources. Een servicedefinitie kan een runtime, database, regio en betrouwbaarheidsniveau aanvragen; controllers vertalen dat naar cloud‑, netwerk‑, beleids‑ en observeerconfiguratie. Stabiele abstracties moeten incidentele complexiteit verbergen zonder operationele status die nodig is voor debugging te verbergen.
Interfaces kunnen web‑portals, API:s, Git‑gebaseerde configuratie, CLI:s en herbruikbare pipeline‑componenten omvatten. De beste interface hangt af van de taakfrequentie en gebruikersworkflow. Elke interface vereist authenticatie, autorisatie, validatie, auditgeschiedenis, foutuitleg en versiebeheer. Self‑service zonder levenscyclusbeheer leidt tot verlaten resources en configuratiespreiding.
Een platformteam bezit gedeelde mogelijkheden en aangelegde routes, terwijl applicatieteams de verantwoordelijkheid voor softwaregedrag en bedrijfsresultaten behouden. Veiligheids-, betrouwbaarheid-, financiële- en infrastructuurteams leveren beleid en services. Expliciete verantwoordelijkheidsgrenzen voorkomen dat het platform een niet‑verantwoordelijke ticket‑queue wordt of een poging om elke engineering‑beslissing te centraliseren.
Waarde meten en platformfalen voorkomen
Meet de doorlooptijd tot een eerste productie‑implementatie, de tijd voor het provisionen van omgevingen, implementatiefrequentie, foutpercentage bij wijzigingen, hersteltijd, cognitieve belasting, ondersteuningsvolume, betrouwbaarheid en adoptie van beveiligingscontroles. Segmenteer de resultaten per team en workload. Een snellere sjabloon‑lancering heeft beperkte waarde als dag‑twee‑wijzigingen traag blijven of incidenten moeilijker te diagnosticeren zijn.
Veelvoorkomende fouten omvatten bouwen voordat de gebruikers zijn begrepen, het kopiëren van de stack van een groot bedrijf, ruwe infrastructuur achter een portal blootstellen, voortijdige standaardisatie afdwingen en optimaliseren voor de output van het platformteam. Begin met één pijnlijke terugkerende reis, breng de stappen en wachttijden in kaart, lever een dun einde‑t‑eind‑pad en itereer op basis van waargenomen resultaten.
Platformen moeten evolueren zonder elke service te destabiliseren. Gebruik versie‑gebaseerde contracten, deprecatiewindows, geautomatiseerde migraties, compatibiliteitstests en duidelijke eigenaarschap. Volg platform‑afhankelijkheden zodat een control‑plane‑storing niet alle implementaties blokkeert of draaiende workloads schaadt. Documenteer break‑glass‑procedures en test regelmatig het herstel na platformfalen.
Voorbeeld: een self‑service‑pad voor een nieuwe API
Een ontwikkelaar kiest een goedgekeurd API‑sjabloon en geeft servicenaam, eigenaar, dataclassificatie, taal en betrouwbaarheidsniveau op. Het platform creëert een repository, afhankelijkheidsbeleid, CI‑pipeline, testomgeving, implementatieconfiguratie, servicecatalogus‑item, dashboards, meldingen en een eerste runbook. Het beleid valideert namen, regio’s, permissies en netwerkblootstelling vóór provisioning, terwijl de gegenereerde artefacten inspecteerbaar blijven en eigendom zijn van het team.
Het platform maakt levenscyclus‑operaties – omgeving aanmaken, implementeren, schalen, een geheim roteren, logs bekijken, terugrollen en buiten gebruik stellen – beschikbaar via stabiele API:s en een portal. Draaiende workloads blijven functioneren als de portal niet beschikbaar is. Uitzonderingen gebruiken een gedocumenteerd extensiepunt en een vervaldatum in plaats van een ongetraceerde handmatige wijziging. Versie‑sjablonen en geautomatiseerde migraties voorkomen dat platformverbeteringen stilletjes bestaande services breken.
Meet de tijd vanaf het aanmaken van de repository tot een gezonde productie‑implementatie, ontwikkelaarsprestatie, ondersteuningsvraag, fout bij wijziging, herstel, naleving van beleid en adoptie per workload‑type. Interview gebruikers die het pad verlaten en inspecteer waar ze wachten of de abstractie ontvluchten. Het platformteam moet de grootste terugkerende frictie prioriteren, betrouwbaarheid en roadmap publiceren en ongebruikte mogelijkheden buiten gebruik stellen. Een gepolijste catalogus is geen platform als teams nog steeds tickets nodig hebben voor elke betekenisvolle operatie.
Adoptie moet gefaseerd plaatsvinden. Begin met vrijwillige teams en één workload‑klasse, bewijs de dag‑twee‑operaties, en migreer vervolgens met tooling en ondersteuning. Publiceer de service‑doelstellingen en afhankelijkheidsstatus van het platform, en ontwerp een break‑glass‑route die gecontroleerd maar bruikbaar is tijdens storingen. Chargeback of showback kan de resource‑kosten blootleggen, maar productteams hebben ook verstandige standaardinstellingen nodig zodat financiële governance niet een andere handmatige goedkeuringsqueue wordt.
Praktische implementatie‑checklist
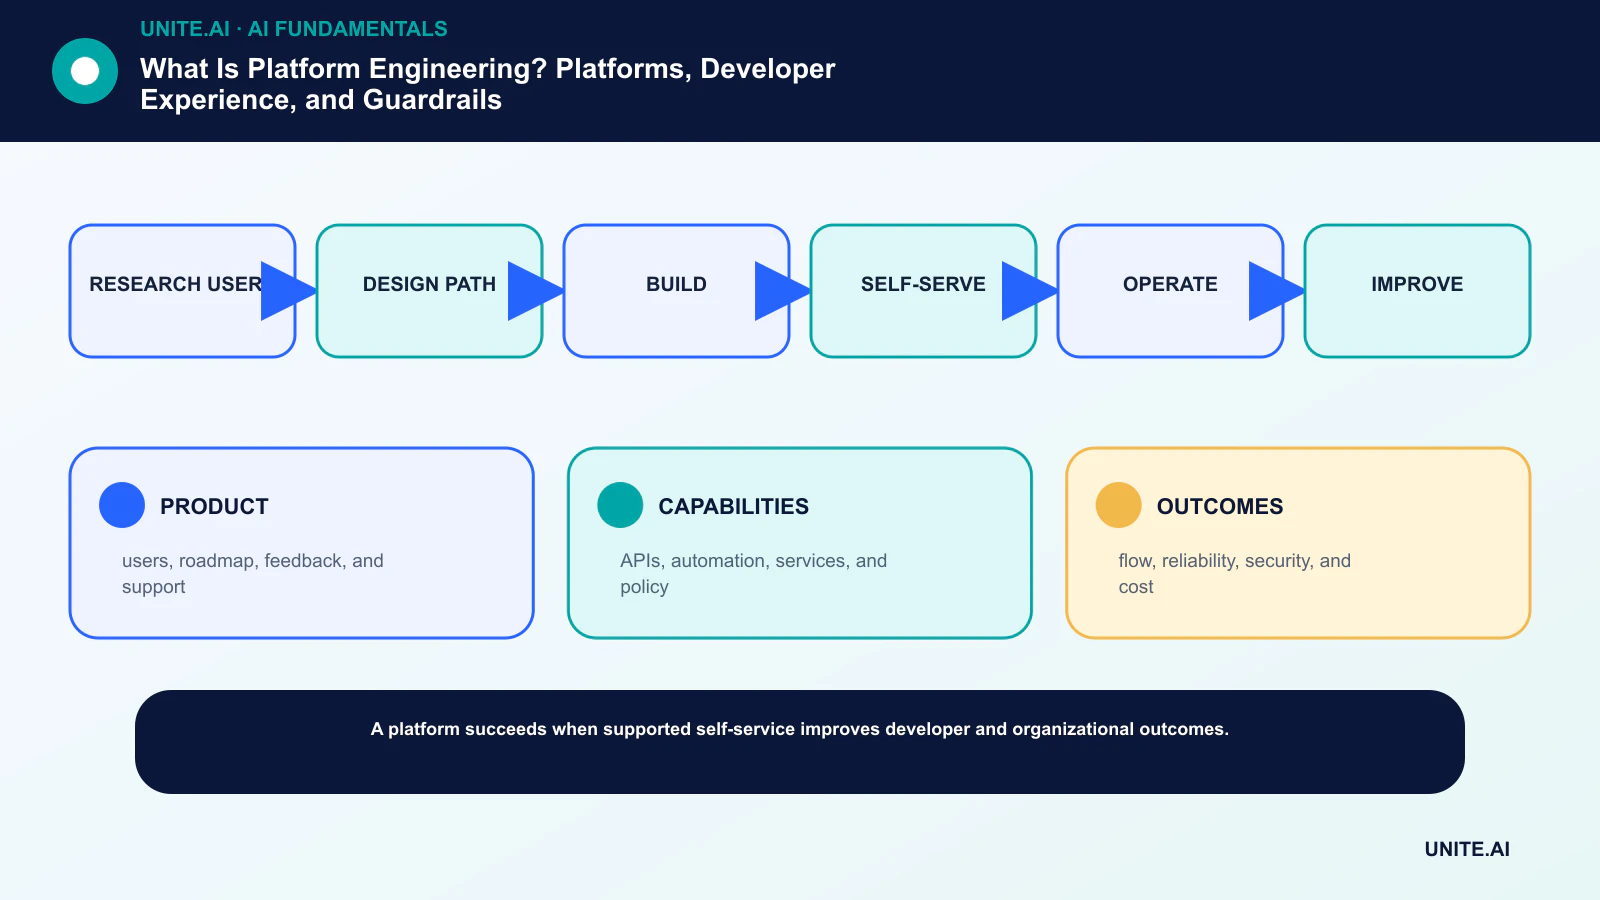
Zet het concept om in een begrensde, testbare workflow: gebruikers onderzoeken → pad ontwerpen → bouwen → self‑serve → exploiteren → verbeteren. Benoem een verantwoordelijke eigenaar, documenteer de data en afhankelijkheden, stel een eenvoudige basislijn vast, definieer acceptatie‑ en stopcriteria, test representatieve fouten, en bepaal monitoring, rollback en review voordat de scope wordt uitgebreid. Leg versies en aannames vast zodat een ander team het resultaat kan reproduceren en begrijpt wat er is veranderd.
Voor de lancering voer een gedocumenteerde readiness‑review uit met de mensen die het systeem bouwen, exploiteren, beveiligen en erdoor worden beïnvloed. Test normale gevallen, grensvoorwaarden, afhankelijkheidsfouten en misbruik; bewaar het bewijs en de onopgeloste risico’s. Definieer wie een release mag goedkeuren, een drempel mag aanpassen, een output mag overschrijven of de operatie mag stoppen. Herzie de beslissing zodra real‑world data beschikbaar is, want een technisch geslaagde pilot garandeert geen betrouwbare prestaties op grotere schaal.
- PRODUCT: gebruikers, roadmap, feedback en ondersteuning.
- CAPABILITIES: API:s, automatisering, services en beleid.
- OUTCOMES: flow, betrouwbaarheid, beveiliging en kosten.
Veelgestelde vragen
Vervangt platform engineering DevOps?
Nee. Platform engineering is een manier om DevOps‑principes op te schalen door gedeelde producten en self‑service‑mogelijkheden te bieden. Samenwerking en service‑eigenaarschap blijven essentieel.
Is een intern ontwikkelaarportal het platform?
Meestal niet. Een portal is een interface. Het platform omvat bovendien API:s, automatisering, infrastructuur, beleid, services, documentatie, ondersteuning en operationeel eigenaarschap.
Primaire referenties











