
AI-basisprincipes
Wat is incidentautomatisering? Workflows, beveiligingsrichtlijnen en toepassingsgevallen

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Incidentautomatisering maakt gebruik van software om operationele of beveiligingsincidenten te detecteren, verrijken, door te sturen, te coördineren en soms te verhelpen. Het verbindt monitoringsignalen met runbooks, ticketing, communicatie, toegangscontroles en herstelacties, zodat respondenten minder tijd besteden aan het kopiëren van gegevens en meer tijd aan het nemen van beslissingen.
Automatisering betekent niet het wegnemen van menselijke verantwoordelijkheid. Een veilig programma onderscheidt laag‑risicostappen die deterministisch zijn van acties die klanten of productie kunnen beïnvloeden, en past vervolgens goedkeuringen, beperkte inloggegevens, audit‑logs, time‑outs en rollback toe op basis van de impact.
Belangrijkste punten
- Automatiseer herhaalbare bewijsgaring voordat je autonome herstelpogingen onderneemt.
- Gebruik ernst, vertrouwen, impactradius en omkeerbaarheid om een goedkeuringsniveau te bepalen.
- Behandel elk runbook als versie‑beheerste productiecodel met tests en een eigenaar.
- Meet detectie, erkenning, herstel, herhaling en gebruikersimpact – niet alleen het aantal meldingen.
Van signaal tot gecoördineerde respons
Een workflow kan meldingen dedupliceren, recente deployments en logs toevoegen, de servicemedewerker identificeren, een incidentrecord openen, het on‑call‑team bellen, een communicatiekanaal aanmaken en een tijdlijn starten. Deze stappen verminderen de cognitieve belasting zonder automatisch een riskante diagnose te stellen.
Correlatie moet bewijsmateriaal behouden. Als een platform symptomen te agressief groepeert, kan dit gelijktijdige incidenten verbergen. Koppel de automatisering aan het eigenaarschap van IT‑operations en bewaar de ruwe signalen die respondenten mogelijk nodig hebben.
Kies acties op basis van risico
Alleen‑lezen‑queries, snapshots en omkeerbare verkeersverschuivingen zijn over het algemeen makkelijker te automatiseren dan het verwijderen van gegevens, het roteren van brede inloggegevens of het wijzigen van een productieschema. Definieer precondities, een uitvoeringstime‑out, postcondities en een rollback voor elke actie.
Gebruik service‑identiteiten met het minste privilege en scheid autorisatie van de workflow‑engine. Stappen met hoge impact moeten een geïdentificeerde goedkeurder vereisen. Als AIOps een oorzaak of oplossing voorstelt, hebben respondenten nog steeds ondersteunend bewijs en een veilige manier nodig om deze af te wijzen.
Bouw betrouwbare runbooks
Een runbook moet inputs, afhankelijkheden, eigenaar, scope, foutgedrag en geproduceerde bewijsmaterialen definiëren. Test het in een staging‑omgeving en tijdens game‑days. Idempotente stappen zijn waardevol omdat herhaaldelijk uitvoeren geen extra schade veroorzaakt.
Versie en review automatisering zoals andere software. Houd het verlopen van inloggegevens, API‑wijzigingen, rate‑limits, gedeeltelijke uitvoering en verborgen koppelingen tussen services in de gaten. Handmatige procedures blijven nodig wanneer het automatiseringsplatform zelf niet beschikbaar is.
Leer na herstel
Automatisering moet een tijdstempel‑record van signalen, beslissingen, acties, goedkeuringen en uitkomsten behouden. Een schuldvrije evaluatie kan vervolgens de bijdragende systeemcondities scheiden van de uiteindelijke trigger en lessen omzetten in geteste verbeteringen.
Nuttige metingen omvatten gemiddelde tijd tot erkenning en herstel, percentage veilige geautomatiseerde stappen, fout‑actieratio, herhaalde incidenten en klantimpact. Koppel bevindingen aan DevOps‑planning in plaats van te optimaliseren voor het aantal gesloten tickets.
Soorten incidentautomatisering
Evenementautomatisering normaliseert en verrijkt binnenkomende signalen. Coördinatie‑automatisering maakt een incidentrecord aan, belt eigenaren, opent communicatiekanalen en plaatst statusupdates. Diagnostische automatisering voert alleen‑lezen‑queries uit of maakt snapshots. Remediatie‑automatisering wijzigt de systeemstatus, terwijl herstel‑automatisering de gezondheid van de service verifieert en tijdelijke mitigaties sluit.
Deze categorieën mogen niet één standaard‑vertrouwensniveau delen. Verrijking kan vaak automatisch worden uitgevoerd; een productiefailover kan vertrouwenscontroles en een goedkeurder vereisen; gegevensherstel heeft meestal een incidentcommander en applicatie‑eigenaar nodig. De controle moet volgen op potentiële impact, niet op of de stap wordt geïmplementeerd door een regel of een machine‑learning‑model.
Beveiligingsincidenten voegen eisen toe voor het bewaren van bewijsmateriaal. Automatisering moet voorkomen dat een gecompromitteerde host wordt gewijzigd voordat vluchtige data is vastgelegd, gevoelige indicatoren in openbare kanalen worden blootgesteld, of gedeelde infrastructuur wordt geïsoleerd zonder de impactradius te begrijpen. Operationele en forensische runbooks kunnen overlappen, maar hun volgorde kan verschillen.
Workflow‑ontwerp en control‑plane
Modelleer het runbook als expliciete toestanden met precondities en eindresultaten. Elke actie moet melden gestart, geslaagd, mislukt, time‑out of overgeslagen, samen met een onveranderlijke uitvoeringsidentificatie. Een centrale orchestrator kan stappen coördineren, maar downstream‑services moeten hun eigen autorisatie handhaven en invoer onafhankelijk valideren.
Gebruik beperkte, kort‑levende inloggegevens en beperk netwerkpaden vanuit de automatiseringsengine. Scheid ontwikkelings‑, test‑ en productierunners. Geheimen mogen niet in chat‑transcripten of logs verschijnen. Voor acties met hoge impact is een twee‑personen‑goedkeuring of een break‑glass‑rol vereist, waarvan het gebruik een directe review‑trail creëert.
Ontwerp voor gedeeltelijke fouten. Een ticket kan worden aangemaakt terwijl het bellen mislukt; een verkeersverschuiving kan slagen in één regio en time‑out in een andere. Compensatie‑acties, reconciliatie‑taken en duidelijke eigenaarschap voorkomen dat de workflow succes meldt alleen omdat het orkestratieproces is beëindigd.
Voorbeelden, testen en volwassenheid
Een volwassen eerste use‑case is uitputting van database‑verbindingen: verzamel pool‑statistieken, recente deployments, trage queries en eigenaarsinformatie; open een incident; stel een omkeerbare schaal‑ of verkeersactie voor; vereis goedkeuring; verifieer vervolgens foutpercentage en latency. Hetzelfde patroon kan dienen voor certificaatverval, schijfdruk, mislukte taken of verdachte accountactiviteit.
Test runbooks via unit‑tests, gemockte API’s, staging‑incidenten, game‑days en gecontroleerde productiedrills. Inject verouderde data, weigering van permissies, trage afhankelijkheden, dubbele events en conflicterende incidenten. Bevestig dat retries veilig zijn en dat respondenten handmatige controle kunnen overnemen zonder te botsen met de automatisering.
Volwassenheid ontwikkelt zich van notificatie naar verrijking, naar begeleide acties, naar begrensde auto‑remediatie. Vooruitgang moet afhangen van bewijsmateriaal: stabiele diagnose, lage fout‑actieratio’s, geverifieerde rollback en duidelijk gebruikersvoordeel. Autonome afsluiting moet zeldzaam blijven totdat het systeem herstel kan aantonen en voldoende bewijs kan bewaren voor later leren.
Voorbeeld: automatisering van een productie‑service‑incident
Stel je een betalings‑API voor waarvan het foutpercentage stijgt na een deployment. Monitoring geeft een gestructureerde waarschuwing af met service, omgeving, regio, versie, foutbudget en runbook‑link. Automatisering verrijkt deze met het wijzigingsrecord, de gezondheid van afhankelijkheden, recente logs en eigenaarschap, en groepeert vervolgens dubbele waarschuwingen tot één incident. Een deterministisch beleid kan de verdere uitrol onmiddellijk pauzeren; een rollback moet bewijs vereisen dat de nieuwe versie de oorzaak is en dat rollback veilig is.
De workflow wijst een incidentcommander toe, opent communicatiekanalen, legt een tijdlijn vast en suggereert diagnostische stappen. Geautomatiseerde remediatie begint met laag‑risico, omkeerbare acties zoals het verplaatsen van verkeer naar een gezonde instantie. Elke actie vereist autorisatie, gelijktijdigheidslimieten, een time‑out, geverifieerde postcondities en rollback. Generatieve samenvattingen kunnen respondenten ondersteunen, maar bron‑telemetrie en commando’s blijven zichtbaar zodat het team een onjuiste narratief kan betwisten.
Meet de tijd tot detectie, erkenning, mitigatie en herstel; het aantal meldingen; onderdrukking van duplicaten; succes van remediatie; herhaling; en schade veroorzaakt door automatisering. Voer game‑days uit voor verlopen inloggegevens, gedeeltelijke regio’s, misleidende waarschuwingen en mislukte rollbacks. Na herstel bewaar je de feitelijke tijdlijn, identificeer je bijdragende technische en organisatorische omstandigheden, werk je runbooks en tests bij, en volg je correctieve werkzaamheden tot voltooiing in plaats van een snelle mitigatie als het einde van betrouwbaarheidswerk te beschouwen.
Praktische implementatie‑checklist
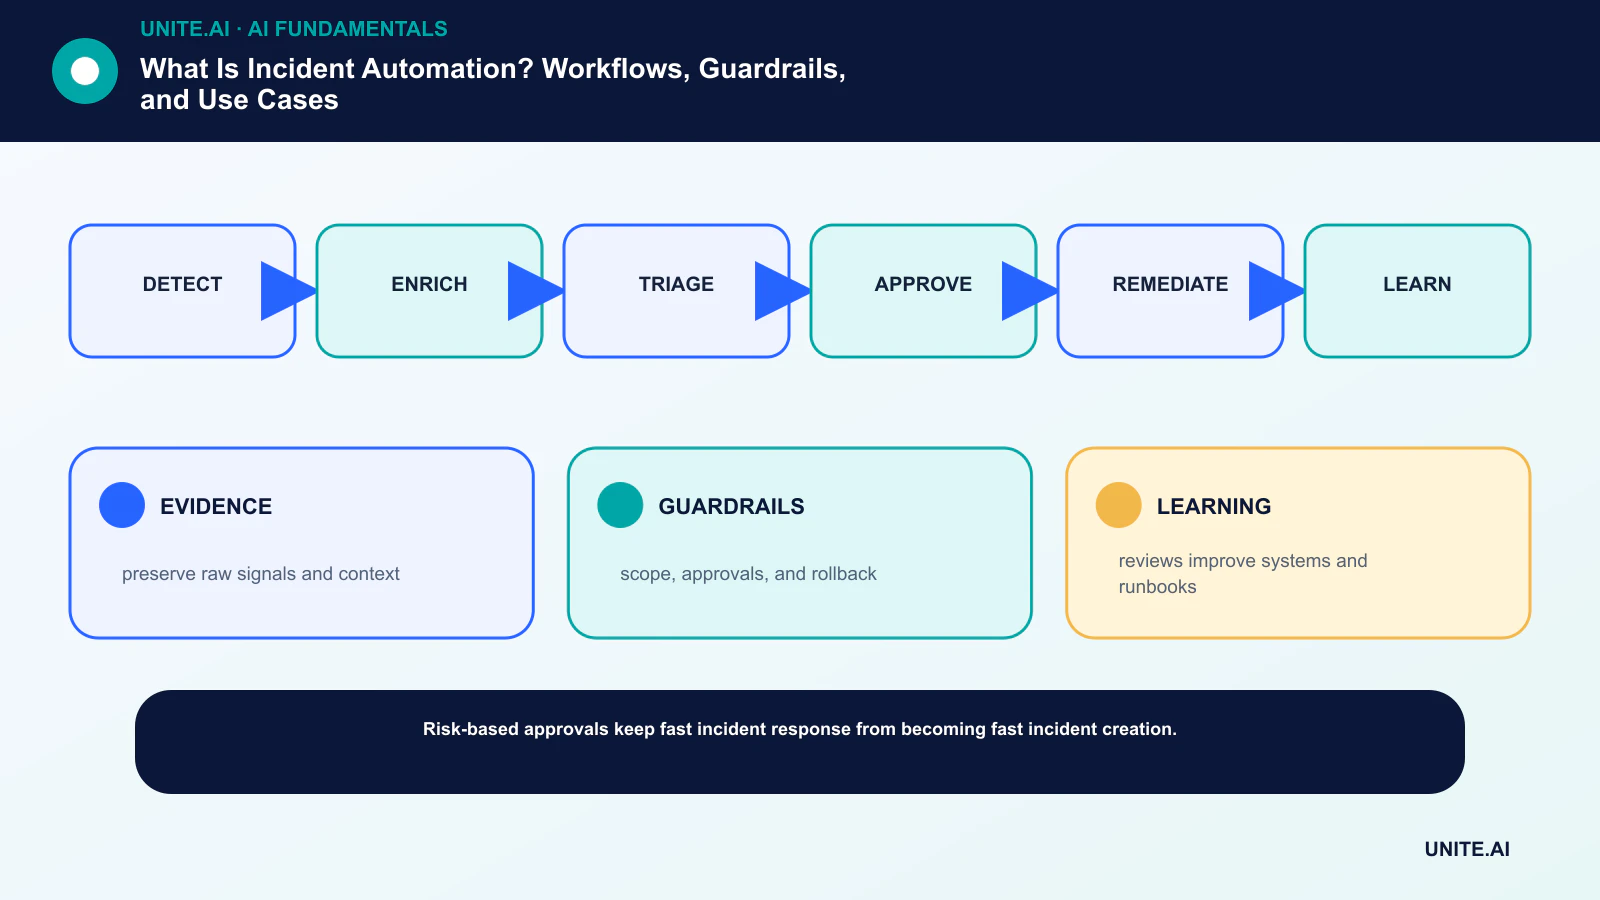
Zet het concept om in een begrensde, testbare workflow: detect → verrijk → triage → goedkeur → remedieer → leer. Benoem een verantwoordelijke eigenaar, documenteer de data en afhankelijkheden, stel een eenvoudige basislijn vast, definieer acceptatie‑ en stopcriteria, test representatieve fouten, en bepaal monitoring, rollback en review voordat je de scope uitbreidt. Leg versies en aannames vast zodat een ander team het resultaat kan reproduceren en begrijpt wat er is veranderd.
Voor de lancering voer je een gedocumenteerde gereedheidsreview uit met de mensen die het systeem bouwen, exploiteren, beveiligen en erdoor worden beïnvloed. Test normale gevallen, grensvoorwaarden, afhankelijkheidsfouten en misbruik; bewaar het bewijs en onopgeloste risico’s. Definieer wie een release mag goedkeuren, een drempel mag wijzigen, een output mag overschrijven of de werking kan stoppen. Herzie de beslissing nadat real‑world‑data binnenkomt, want een technisch geslaagde pilot garandeert geen betrouwbare prestaties op grotere schaal.
- EVIDENCE: bewaar ruwe signalen en context.
- GUARDRAILS: scope, goedkeuringen en rollback.
- LEARNING: evaluaties verbeteren systemen en runbooks.
Veelgestelde vragen
Is incidentautomatisering hetzelfde als AIOps?
Nee. AIOps past analytics of machine learning toe op operationele data. Incidentautomatisering is de bredere uitvoerings‑ en coördinatielaag; deze kan eenvoudige regels, AIOps‑output of beide gebruiken.
Wat moet als eerste geautomatiseerd worden?
Begin met hoog‑frequente, laag‑risico, goed begrepen stappen zoals verrijking, eigenaarsopzoeking, bewijsgaring, statusupdates en omkeerbare diagnostiek.
Primaire referenties











