
AI-basisprincipes
Wat is IT Operations (ITOps)?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
IT operations (ITOps) is het werk van het beheren van de technologische diensten waar een organisatie op vertrouwt. Het omvat compute, netwerken, identiteit, endpoints, cloudplatformen, databases, opslag, back-ups en de operationele processen die die componenten beschikbaar, veilig en ondersteunbaar houden.
Moderne ITOps is niet beperkt tot een netwerkoperationscentrum dat dashboards bekijkt. Teams beheren steeds vaker software‑gedefinieerde infrastructuur, platformdiensten, automatisering en gedistribueerd eigenaarschap, terwijl ze verantwoordelijk blijven voor incidenten, capaciteit, continuïteit en serviceniveaus.
Belangrijkste conclusies
- ITOps beheert diensten en hun afhankelijkheden over on‑premise, cloud‑ en edge‑omgevingen.
- Observability, configuratie en inventarisatie bieden de context die nodig is om storingen te interpreteren.
- Incidentmanagement herstelt de dienst; problemmanagement behandelt terugkerende of systemische oorzaken.
- ITOps overlapt met ITSM, SRE, DevOps, SecOps en AIOps, maar is niet identiek aan een van hen.
Diensten, assets en configuratie
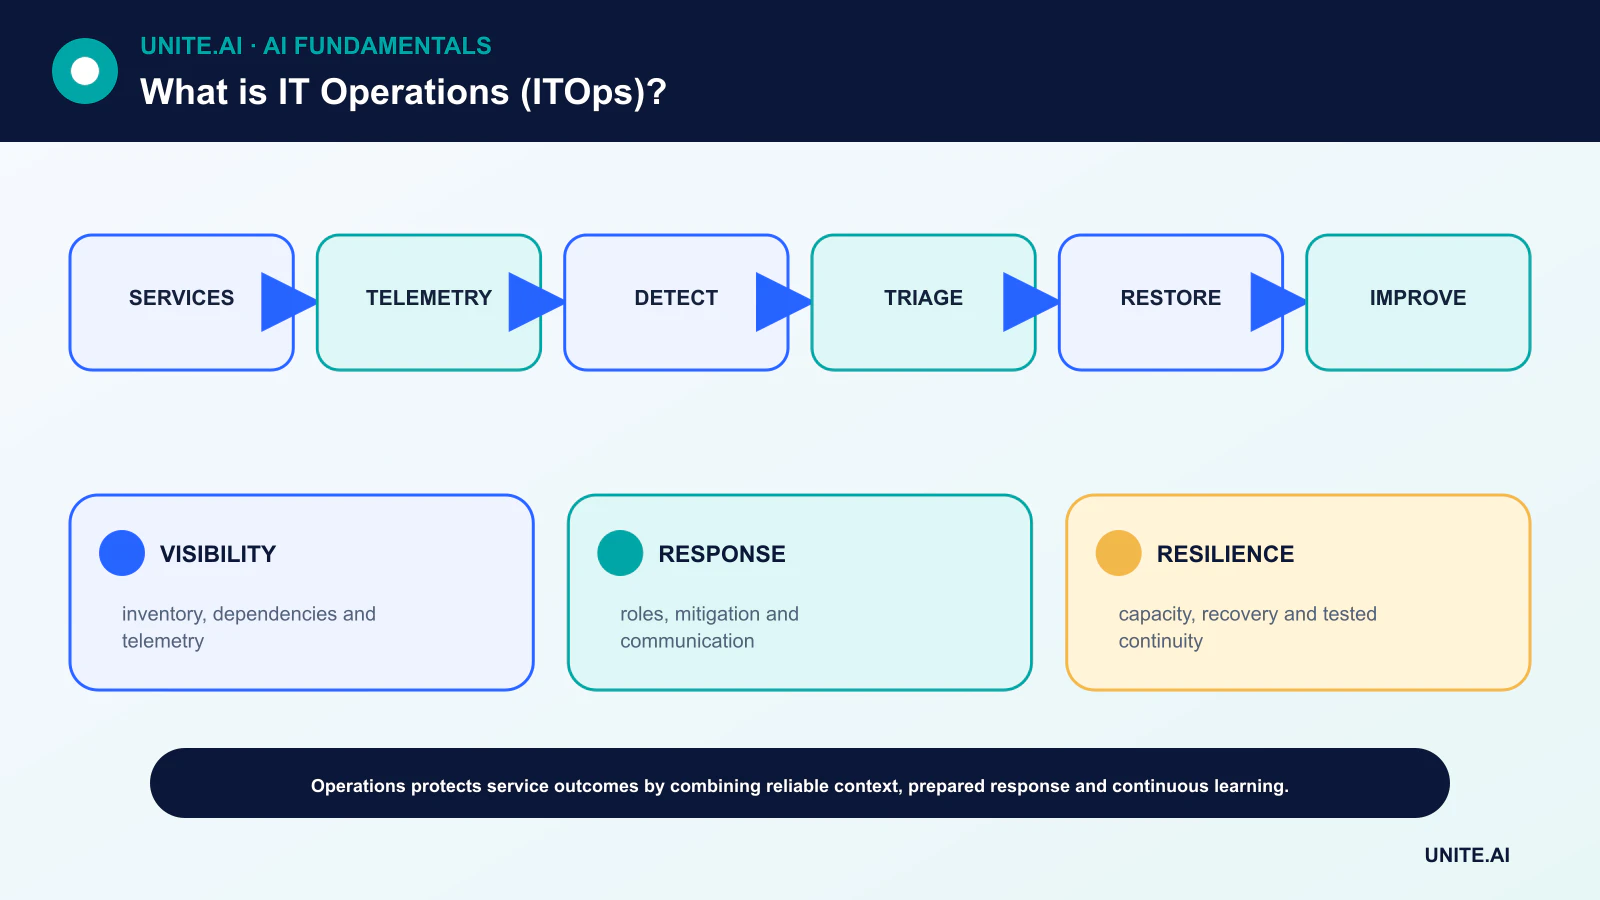
Operations begint met weten welke diensten bestaan, wie ze bezit, welke gebruikers ervan afhankelijk zijn en welke infrastructuur ze ondersteunt. Asset‑inventaris registreert componenten; configuratiebeheer legt relevante relaties en gecontroleerde status vast.
Een inventaris die nooit wordt afgestemd, wordt misleidend. Automatiseer ontdekking waar nuttig, identificeer autoritaire bronnen en registreer vertrouwen of actualiteit in plaats van te doen alsof elke afhankelijkheidskaart volledig is.
Observability en service‑doelstellingen
Metrics kwantificeren gedrag, logs registreren gebeurtenissen en traces volgen werk over diensten heen. Synthetische controles kunnen een gebruikersreis testen. Nuttige observability begint met vragen en service‑doelstellingen, waarna de signalen die nodig zijn om ze te beantwoorden worden verzameld.
Alerting moet omstandigheden identificeren die tijdige actie vereisen. Drempels zonder impact op gebruikers veroorzaken ruis, terwijl ontbrekende afhankelijkheidscontext de diagnose vertraagt. AIOps kan bij correlatie helpen, maar heeft betrouwbare telemetrie en operationele feedback nodig.
Incident-, probleem- en change‑management
Incidentmanagement coördineert detectie, triage, mitigatie, communicatie en herstel. Duidelijke rollen verminderen verwarring onder druk. Een tijdelijke workaround kan de dienst herstellen terwijl een latere probleemanalyse diepere oorzaken aanpakt.
Change‑management evalueert en registreert risico zonder elke wijziging in een wachtrij te plaatsen. Standaard, geautomatiseerde en low‑risk wijzigingen kunnen vooraf goedgekeurde paden volgen; high‑impact wijzigingen vereisen sterker bewijs, planning en rollback‑voorbereiding.
Capaciteit, veerkracht en continuïteit
Teams voorspellen de vraag naar resources, verwijderen knelpunten en testen gedrag onder belasting. Back‑ups zijn alleen nuttig wanneer herstel wordt getest. Redundantie helpt alleen wanneer faalmodi onafhankelijk zijn en failover daadwerkelijk werkt.
Business continuity definieert prioriteiten, hersteltijd en acceptabel gegevensverlies. Afhankelijkheden van identiteit, DNS, cloud‑control‑planes en leveranciers moeten in oefeningen worden opgenomen in plaats van verondersteld beschikbaar te zijn.
ITOps, ITSM, SRE en DevOps
IT service management biedt processen om diensten af te stemmen op de behoeften van de organisatie. Site reliability engineering past software‑engineering toe op operations en gebruikt service‑level objectives en error budgets. DevOps verbindt ontwikkeling en operationele feedback.
SecOps richt zich op bedreigingen en respons, terwijl ITOps de bredere service‑gezondheid onderhoudt. Organigrammen verschillen; de belangrijke eis is expliciet eigenaarschap en gedeeld bewijs over deze disciplines heen.
Het ITOps‑operatiemodel
IT‑operations houdt de technologische diensten van de organisatie beschikbaar, performant, veilig en herstelbaar. De scope omvat doorgaans endpoints, identiteit, netwerken, servers, cloud, opslag, samenwerking, databases, monitoring, servicedesk, back‑up en leveranciersdiensten. Moderne ITOps bestrijkt eigen infrastructuur en beheerde platformen, dus verantwoordelijkheid moet expliciet zijn, zelfs wanneer de operatie wordt uitbesteed. Een configuratie‑ of service‑inventaris verbindt technische componenten met eigenaren, gebruikers, afhankelijkheden, gegevensclassificatie en zakelijke kritikaliteit.
Service‑management organiseert incidenten, verzoeken, problemen, wijzigingen, assets, kennis en serviceniveaus. Incidentmanagement herstelt de dienst; problemmanagement onderzoekt terugkerende oorzaken; change‑enablement beoordeelt en coördineert risico. Elke wijziging behandelen als een trage goedkeuring leidt tot omzeilingen, terwijl ongereguleerde automatisering ongecontroleerde fouten veroorzaakt. Standaard low‑risk wijzigingen kunnen vooraf geautoriseerd en geautomatiseerd worden; high‑risk wijzigingen hebben bewijs, communicatie, rollback en planning op basis van impact nodig.
Betrouwbaarheid, capaciteit en continuïteit
Monitoring moet zich richten op gebruikersgerichte diensten en afhankelijkheden, niet alleen op het aantal apparaten. Definieer beschikbaarheid, latency, capaciteit, actualiteit en ondersteuningsdoelstellingen samen met de business‑eigenaren. Alert op actiegerichte symptomen en het verbruik van het error‑budget; verrijk events met eigenaarschap en recente wijzigingen. Capaciteitsplanningsmodellen omvatten vraag, verzadiging, licenties en doorlooptijd. Cloud‑elasticiteit verkort de provisioning‑vertraging, maar elimineert quotas, regionale limieten of kostenbeheersing niet.
Business continuity vereist geteste back‑ups, herstel, identiteitsherstel, netwerkalternatieven, leverancierscontacten en handmatige procedures. Definieer herstel‑tijd- en herstel‑puntdoelstellingen per dienst. Een back‑up is geen bewijs van herstel totdat deze is hersteld en gevalideerd. Oefen ransomware, region‑verlies, verlopen certificaten, identiteitsuitval en leverancier‑falen. Houd configuratie en infrastructuur als code bij waar mogelijk zodat herstel reproduceerbaar is.
Beveiliging, automatisering en metrics
Gebruik het principe van minste privileges, patch‑ en kwetsbaarheidsbeheer, endpoint‑controles, netwerksegmentatie, logging en incidentrespons. Automatiseer repetitief werk met idempotentie, limieten, goedkeuringen en audits. Meet service‑beschikbaarheid, incident‑herhaling, verzoekafhandeling, change‑falen, herstel, patch‑exposure, capaciteit, kosten en gebruikers‑tevredenheid — niet alleen ticket‑sluiting. ITOps is succesvol wanneer technologie het werk voorspelbaar ondersteunt en kan herstellen van falen, niet wanneer de infrastructuur druk lijkt of dashboards meer groene indicatoren bevatten.
Voorbeeld: herstel van een samenwerkingsservice
Een bedrijf stelt een herstel‑tijddoel van vier uur en een herstel‑puntdoel van één uur vast voor een samenwerkingsplatform. Het inventariseert identiteit, DNS, netwerk, gegevens, sleutels, configuratie, integraties en leveranciersafhankelijkheden. Een herstel‑oefening gaat ervan uit dat de primaire regio en het admin‑account niet beschikbaar zijn. Operators activeren een onafhankelijk beschermde nood‑identiteit, herstellen de service‑configuratie en gegevens in een geïsoleerde regio, en valideren permissies, berichten, integraties en client‑toegang. Business‑eigenaren verifiëren de herstelde service met realistische gebruikersreizen in plaats van alleen te vertrouwen op infrastructuur‑health‑checks.
De oefening registreert daadwerkelijk gegevensverlies, verstreken tijd, handmatige stappen, mislukte contacten en verborgen afhankelijkheden. Een back‑up die bestanden herstelt maar geen encryptiesleutels of identiteitsbeleid, wordt als onvolledig gemarkeerd. Corrigerende acties krijgen eigenaren en data toegewezen, en het runbook wordt bijgewerkt en opnieuw getest. Monitoring‑ en communicatiesjablonen worden opgenomen. De organisatie meet herstel‑bewijs in plaats van het succes van de back‑up‑taak, met de erkenning dat betrouwbare ITOps de service die gebruikers nodig hebben moet herstellen onder realistische faalcondities.
Implementatie‑bewijs en operationele gereedheid
Een productie‑beslissing vereist meer dan een succesvolle demonstratie. Definieer de beoogde gebruikers, operationele omgeving, inputs, outputs, afhankelijkheden, eigenaar en de consequentie van elke belangrijke storing. Stel een reproduceerbare basislijn en een versie‑gebaseerde evaluatieset vast vóór afstemming. Test gewone gevallen, randvoorwaarden, misvormde of ontbrekende input, distributieverschuiving, afhankelijkheidsuitval, misbruik, en de groepen of omgevingen die waarschijnlijk onderbediend worden. Meet taakkwaliteit samen met kalibratie of onzekerheid, latency, doorvoer, resource‑kosten, toegankelijkheid, privacy en beveiliging. Leg elke transformatie en drempel vast zodat een onafhankelijke reviewer het resultaat kan reproduceren en bewijs kan onderscheiden van een aantrekkelijk prototype.
Voor de lancering moet autoriteit worden toegewezen voor release, uitzonderingen, wijzigingen, rollback en beëindiging. Gebruik een gefaseerde uitrol, behoud een veilige fallback, en verifieer monitoring met opzettelijk geïnjecteerde storingen. Operationele telemetrie moet input‑kwaliteit, output‑gedrag, model‑ of regel‑versie, afhankelijkheids‑gezondheid, menselijke overrides en bevestigde uitkomsten onthullen zonder onnodige gevoelige gegevens te verzamelen. Definieer alert‑drempels en een respons‑eigenaar, en beoordeel vervolgens real‑world bewijs na de uitrol in plaats van aan te nemen dat offline prestaties behouden blijven. Her‑evalueer telkens wanneer gegevensbronnen, gebruikers, modellen, leveranciers, beleidsregels, hardware of doelstellingen veranderen. Een onderhouden systeem heeft ook gedocumenteerde herstel‑, incident‑leer‑, verwijder‑ en retentie‑procedures nodig, en een duidelijk punt waarop het moet worden uitgeschakeld of vervangen.
Veelgestelde vragen
Wat is het primaire doel van ITOps?
Het leveren en herstellen van betrouwbare technologische diensten binnen overeengekomen beveiligings-, prestatie-, continuïteits- en kosteneisen.
Wordt cloudinfrastructuur volledig door de cloudprovider beheerd?
Nee. Providers beheren delen van het onderliggende platform, terwijl klanten verantwoordelijk blijven voor configuratie, identiteit, gegevens, workloads, monitoring en vele service‑level beslissingen.
Primaire referenties












