
AI-basisprincipes
Wat is Asset Performance Management (APM)?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Asset performance management (APM) combineert assetstrategie, onderhoud, conditiebewaking, betrouwbaarheidsanalyse en operationele gegevens om de waarde die fysieke assets leveren te verbeteren. Het wordt vaak toegepast op apparatuur zoals turbines, pompen, voertuigen, productielijnen en infrastructuur.
APM is geen sensor‑dashboard of een voorspellend onderhoudsmodel op zich. Het is een besluitvormingsproces dat prestaties, kosten, risico, veiligheid en duurzaamheid in de hele levenscyclus van een asset in evenwicht brengt, met duidelijke eigenaarschap voor inspecties, werkzaamheden, reserveonderdelen en kapitaalplanning.
Belangrijkste punten
- Begin met kritikaliteit en falingsgevolgen, niet met de gemakkelijkst te verzamelen sensor.
- Combineer conditiegegevens met onderhoudsgeschiedenis, operationele context en technische kennis.
- Gebruik voorspellende signalen om een gedefinieerde werkbeslissing en doorlooptijdvereiste te ondersteunen.
- Meet vermeden risico, beschikbaarheid, onderhoudskwaliteit, levenscycluskosten en valse alarmen.
Van assetstrategie naar werk
Organisaties definiëren doelstellingen, assethiërarchieën, kritikaliteit, prestatiestandaarden, faalmodi en onderhoudsstrategieën. Een werkbeheersysteem plant inspecties en reparaties; APM‑analyses helpen prioriteren wanneer en waarom werk moet worden uitgevoerd.
Dezelfde conditie kan verschillende acties impliceren voor een redundante, goedkope pomp en een veiligheidskritische turbine. APM verbindt technische bewijsmateriaal aan de zakelijke en veiligheidscontext in plaats van één voorspellingsscore te optimaliseren.
Gegevens en digitale representaties
Nuttige bronnen omvatten sensors‑tijdreeksen, alarmen, operatorrondes, onderhoudsnotities, onderdelen, omgeving, belastingen en ontwerplimieten. Asset‑identifiers en tijdstempels moeten op elkaar afgestemd zijn vóór analyse. Ontbrekende, drijvende of vervangen sensoren kunnen valse trends veroorzaken.
Een digitale tweeling kan engineering‑modellen en live‑status combineren, maar heeft gevalideerde aannames en update‑regels nodig. Ongestructureerde technici‑notities kunnen context toevoegen die telemetrie mist.
Condities, voorspelling en besluit
Drempels detecteren bekende limieten; anomalie‑modellen markeren afwijkingen; diagnostische modellen schatten oorzaken; prognostische modellen schatten de resterende bruikbare levensduur. Elk vereist een tijdshorizon en onzekerheid die passen bij de onderhoudsbeslissing.
Een model dat een storing vijf minuten vóór het optreden voorspelt, kan nauwkeurig zijn maar operationeel nutteloos als onderdelen een week nodig hebben. Machine learning moet worden vergeleken met regels en betrouwbaarheidsmethoden en getest over verschillende operationele regimes.
Implementatie en meting
Begin met een kritische asset‑klasse, een geloofwaardige faalmodus, beschikbare doorlooptijd en een eigenaar die kan handelen. Integreer aanbevelingen in planning, werkorders en voorraad; verzamel het resultaat zodat de regel of het model kan worden beoordeeld.
Volg beschikbaarheid, ongeplande stilstand, onderhoudskosten, naleving van planning, valse alarmen, gemiste gebeurtenissen, veiligheidsblootstelling en levenscycluswaarde. Vermijd het claimen van vermeden storingen zonder een tegenfeitelijke methode en gedocumenteerde aannames.
Assethiërarchie, faalgedrag en kritikaliteit
Een APM‑programma begint met een asset‑hiërarchie die locaties, systemen, apparatuur, assemblages en onderhoudbare componenten verbindt. Elk niveau vereist consistente identifiers, eigenaarschap, locatie, specificaties en relaties. Zonder die basis kunnen sensor‑streams, werkorders, inspectie‑bevindingen en kostendossiers niet betrouwbaar dezelfde fysieke asset beschrijven.
Faalmodi verklaren hoe een asset kan stoppen met het vervullen van de vereiste functie, waarom de storing optreedt, welk bewijs eerst verschijnt en welke consequentie volgt. Faalmodus‑ en effectenanalyse, reliability‑centered maintenance en root‑cause‑analyse maken van onderhoud een risico‑geïnformeerde discipline in plaats van een kalenderactiviteit. De analyse moet symptomen onderscheiden van oorzakelijke mechanismen.
Kritikaliteit combineert waarschijnlijkheid met consequenties voor veiligheid, milieu, productie, kwaliteit, compliance en kosten. Een redundante pomp die een niet‑essentele lus bedient, mag niet hetzelfde monitoringsbudget krijgen als een compressor met een enkel punt van falen. Kritikaliteit verandert met de operationele context, dus teams moeten rangschikkingen herzien na proces‑, asset‑ of vraag‑veranderingen.
Conditiesbewaking, voorspelling en onderhoudsbeslissingen
Conditiesbewaking kan gebruikmaken van trillingen, temperatuur, druk, stroom, akoestische emissie, smeermiddelanalyse, visuele inspectie en operatorobservaties. De bemonsteringsfrequentie moet overeenkomen met de fysica van de storing. Hoge‑frequente lagertrillingen en langzaam drijvende corrosie vereisen verschillende sensoren, opslag, kenmerken en alarmlogica. Kalibratie en installatiekwaliteit maken deel uit van de datakwaliteit.
Voorspellende modellen kunnen anomalieën detecteren, bekende storingen classificeren, gezondheidsindicatoren schatten of de resterende bruikbare levensduur voorspellen. Een statistisch ongewoon signaal is niet automatisch een actie‑gerichte storing. Modellen hebben context van de operationele toestand, onzekerheid, doorlooptijdevaluatie en validatie over apparatuur, seizoenen, belastingen en onderhoudsgebeurtenissen nodig. Valse alarmen ondermijnen vertrouwen en arbeidskrachten; gemiste detecties kunnen tot ernstige verliezen leiden.
De output van analytics moet aansluiten op een besluit: inspecteren, smeren, de belasting verlagen, werk inplannen, een onderdeel bestellen of stilleggen. Beslissingsdrempels moeten de falingsgevolgen, interventiedoorlooptijd, personeelscapaciteit, reserveonderdelen en productievensters weerspiegelen. De economisch optimale drempel is zelden de drempel die een generieke modelmetric maximaliseert.
APM‑integratie, waardemeting en governance
APM verbindt operationele technologie met enterprise‑systemen zoals computer‑gebaseerd onderhoudsbeheer, enterprise‑asset‑management, historiek, voorraad en planning. Integratie moet tijdstempels, eenheden, asset‑identiteit, werkstatus en herkomst behouden. Netwerksegmentatie en gecontroleerde gateways zijn essentieel omdat diagnostisch gemak geen pad mag vormen naar veiligheid‑kritische regelsystemen.
Meet waarde via vermeden stilstand, verminderde noodonderhoud, onderhoudskosten, beschikbaarheid van reserveonderdelen, energie‑efficiëntie, opbrengst, veiligheidsblootstelling en levensduur van de asset. Vermeden storingen zijn tegenfeitelijk, dus gebruik geloofwaardige baselines, vergelijkbare assets, gedocumenteerde aannames en gevoeligheidsbereiken. Een pilot die veel anomalieën vindt maar geen onderhoudsbeslissingen wijzigt, heeft geen zakelijke waarde aangetoond.
Governance wijst eigenaren toe voor sensoren, modellen, alarmregels, faalbibliotheken en werkprocessen. Beoordeel alerts na elke interventie, registreer of de diagnose correct was, en voer bevestigde uitkomsten terug in regels en modellen. Operators en onderhouders hebben een manier nodig om aanbevelingen uit te dagen; lokale kennis is bewijs, geen weerstand tegen automatisering.
Voorbeeld: bescherming van een kritisch roterend asset
Voor een productie‑compressor brengt het team componenten en faalmodi in kaart, rangschikt verlies‑productie en veiligheidsgevolgen, en verbindt historiek‑tags, trilling‑sensoren, smeermiddelmonsters, inspecties en werkorders met één asset‑identiteit. Baseline‑gegevens moeten opstart, constante belasting, afschaling en seizoenscondities dekken. Anders kan het model normale operationele overgangen als storingen markeren of degradatie missen die alleen bij een bepaalde belasting zichtbaar is.
Een analytics‑laag detecteert veranderingen in het trillingenspectrum en de lagertemperatuur, schat onzekerheid en toont het bewijs naast vergelijkbare historische gebeurtenissen. Een aanhoudende alert creëert een inspectieverzoek in plaats van automatisch stil te leggen. De onderhoudsmedewerker registreert bevindingen, actie, vervangen onderdeel en bevestigde oorzaak. Die uitkomsten bepalen of de drempel, het faalmodel of de sensorinstallatie moet worden aangepast.
Evalueer de waarschuwing‑doorlooptijd, bevestigde detectiegraad, valse‑alarm‑belasting, vermeden stilstand, noodonderhoud, paraatheid van reserveonderdelen en onderhoudskosten ten opzichte van een gedocumenteerde baseline. Neem de kosten van sensoren, integratie, analyse en gewijzigde werkprocessen op. Een cybersecurity‑review isoleert monitoring van besturing, en governance wijst eigenaren toe voor data en modellen. Het doel is een veiliger economische onderhoudsbeslissing, niet de grootste mogelijke verzameling van asset‑telemetrie.
Praktische implementatiechecklist
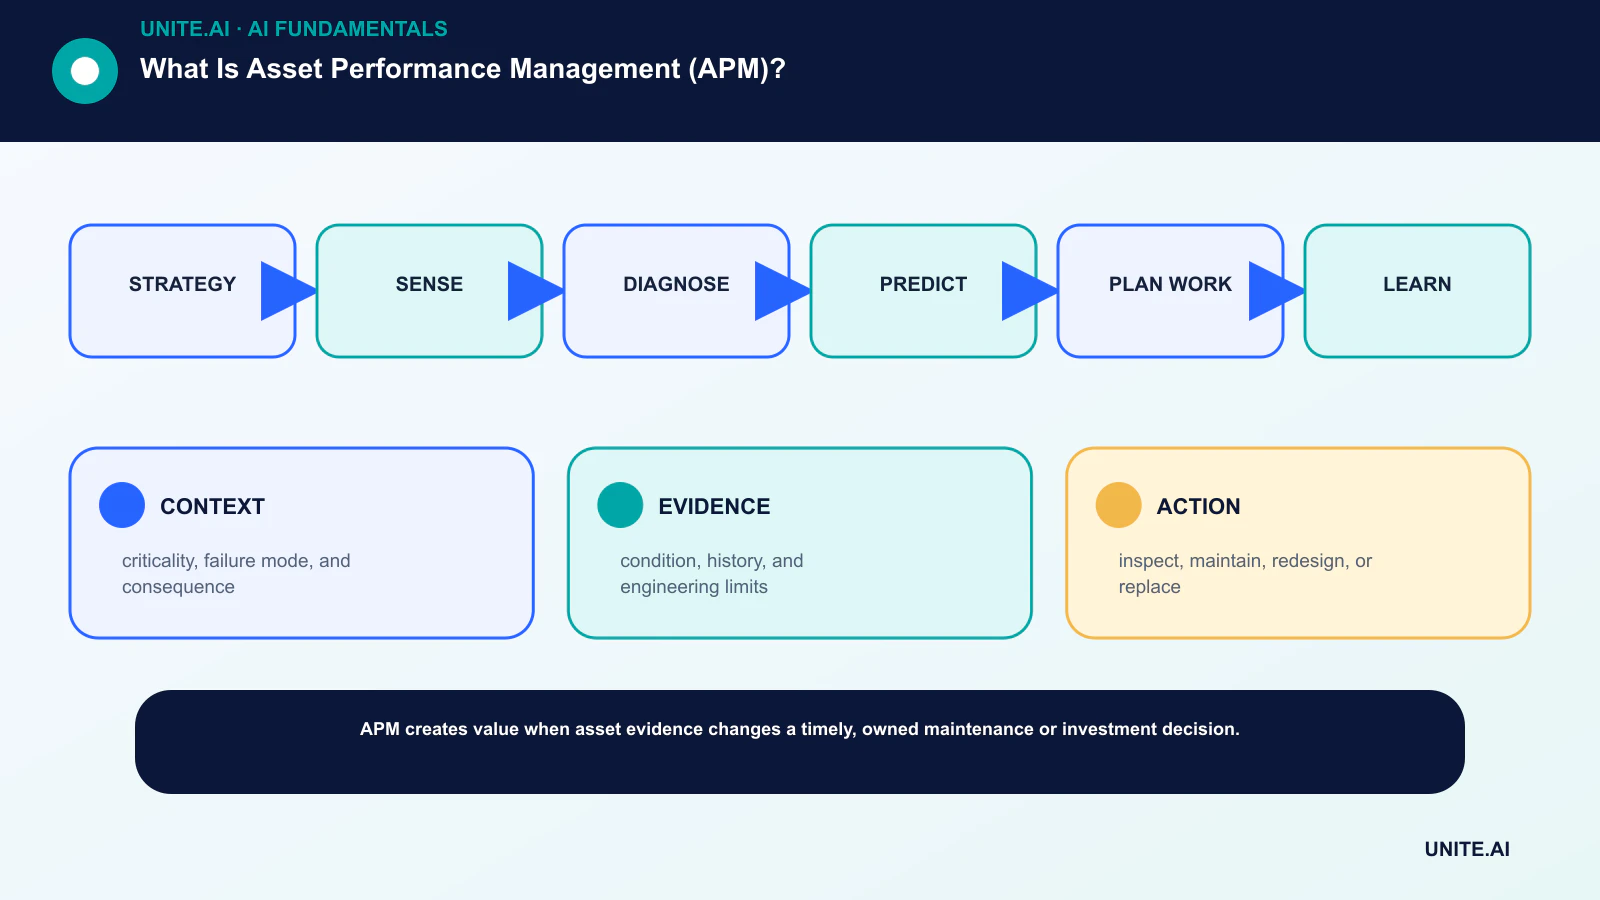
Zet het concept om in een begrensde, testbare workflow: strategie → waarnemen → diagnosticeren → voorspellen → werk plannen → leren. Benoem een verantwoordelijke eigenaar, documenteer de gegevens en afhankelijkheden, stel een eenvoudige baseline vast, definieer acceptatie‑ en stopcriteria, test representatieve storingen, en definieer monitoring, rollback en review voordat de scope wordt uitgebreid. Leg versies en aannames vast zodat een ander team het resultaat kan reproduceren en begrijpt wat er is veranderd.
Voor de lancering voer een gedocumenteerde gereedheidsreview uit met de mensen die het systeem bouwen, exploiteren, beveiligen en erdoor worden beïnvloed. Test normale gevallen, randvoorwaarden, afhankelijkheidsstoringen en misbruik; bewaar het bewijs en onopgeloste risico’s. Definieer wie de release kan goedkeuren, een drempel kan wijzigen, een output kan overschrijven of de operatie kan stoppen. Herzie de beslissing zodra real‑world data beschikbaar is, want een technisch succesvolle pilot garandeert geen betrouwbare prestaties op grotere schaal.
- CONTEXT: kritikaliteit, faalmodus en consequentie.
- EVIDENCE: conditie, geschiedenis en technische limieten.
- ACTION: inspecteren, onderhouden, herontwerpen of vervangen.
Veelgestelde vragen
Hoe verschilt APM van een CMMS?
Een CMMS beheert voornamelijk onderhoudswerk, planning en registraties. APM voegt assetstrategie, betrouwbaarheid‑ en conditie‑analyse, prioritering en prestatie‑beslissingen toe; de systemen integreren vaak.
Is voorspellend onderhoud vereist voor APM?
Nee. Preventief, conditie‑gebaseerd, run‑to‑failure, herontwerp‑ en vervangingsstrategieën kunnen allemaal passend zijn. Voorspelling is één instrument binnen een assetstrategie.
Primaire referenties












