
AI-basisprincipes
Wat is generatieve AI?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
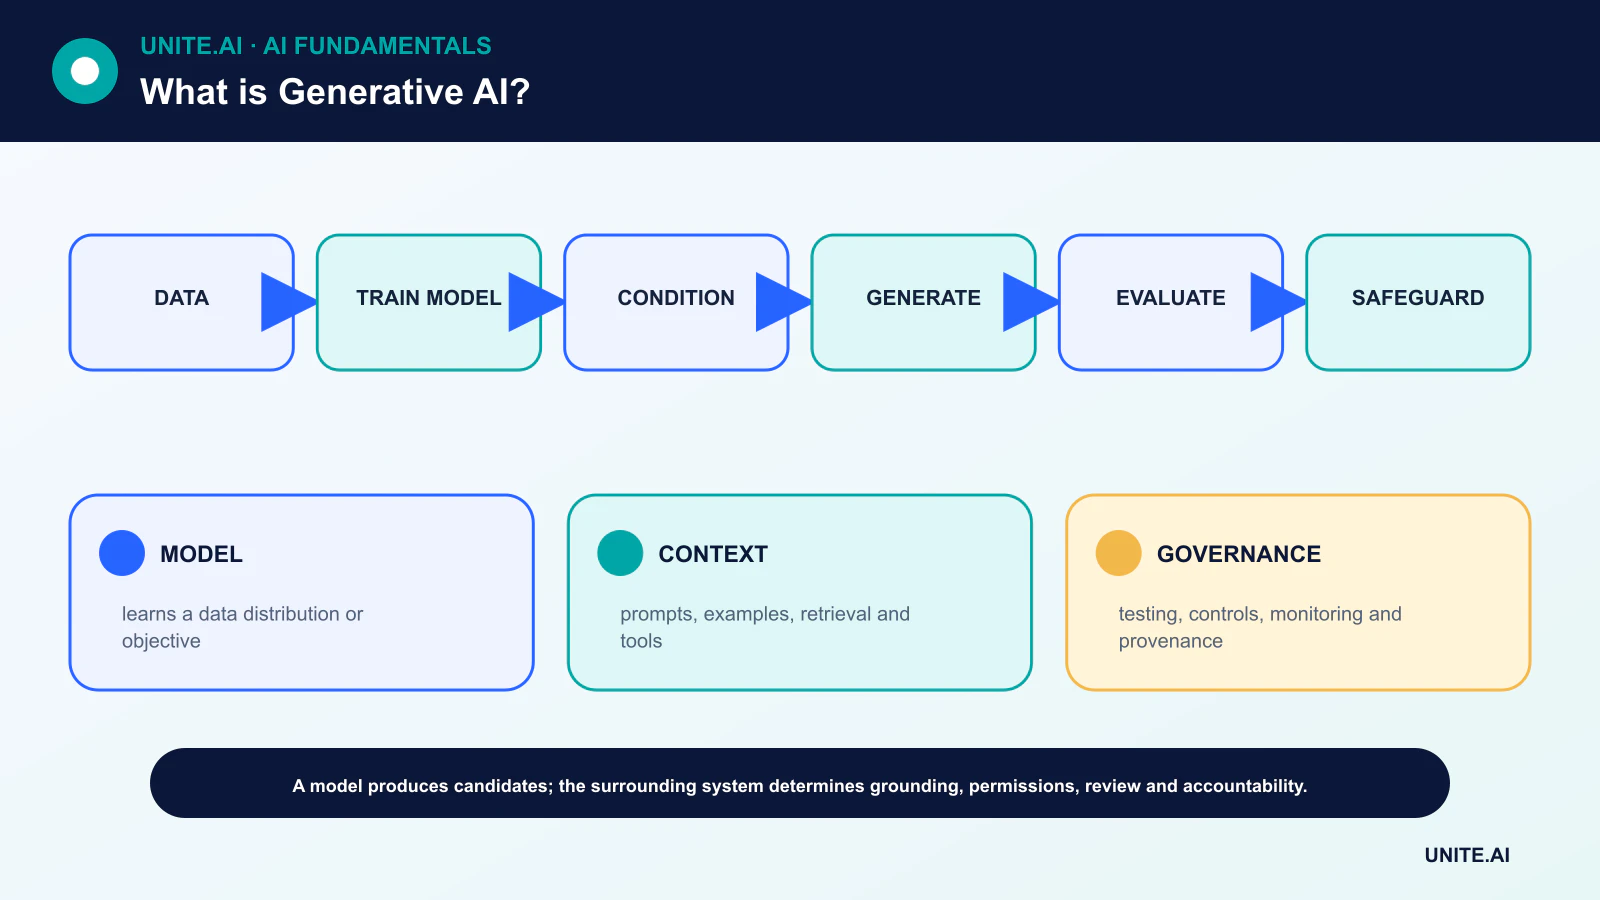
Generatieve AI verwijst naar modellen die patronen in data leren en nieuwe tekst, afbeeldingen, audio, video, code of andere representaties produceren wanneer ze worden geconditioneerd op instructies of voorbeelden. De output wordt gesynthetiseerd vanuit een probabilistisch model; het wordt niet intact uit een database opgehaald, hoewel retrieval‑tools extern bewijs kunnen leveren.
Verschillende modelfamilies genereren op verschillende manieren. Autoregressieve transformers voorspellen een reeks token voor token, diffusie‑modellen denoisen een monster iteratief, en generatieve adversariële netwerken leren via een wedstrijd tussen een generator en een discriminator.
Belangrijkste conclusies
- Generatie is conditionele sampling uit een geleerde verdeling, niet gegarandeerd feitelijk terughalen.
- Transformers, diffusie‑modellen, GAN’s en variationale auto‑encoders maken verschillende afwegingen.
- Retrieval en tools kunnen een systeem verankeren, maar hun uitvoer en permissies vereisen nog steeds validatie.
- Risicobeheer omvat data, model, interface, implementatie, monitoring en herkomst van content.
Hoe generatieve modellen leren
Trainingsdoelen belonen een model voor het voorspellen of reconstrueren van patronen in voorbeelden. Een taalmodel schat het volgende token; een diffusie‑model leert een ruisproces om te keren; een variational autoencoder leert een gestructureerde latente verdeling en decoder.
Deze training creëert statistische generalisatie, maar kan ook vooroordelen reproduceren, ongebruikelijke sequenties memoriseren of falen buiten de dataverdeling. Dataset‑documentatie, deduplicatie, privacy‑controles en een hold‑out‑evaluatie zijn daarom belangrijk vóór implementatie.
Belangrijkste architectuurfamilies
Autoregressieve transformers domineren tekst en ondersteunen multimodale reeksen. Diffusie‑modellen worden veel gebruikt voor beeld‑ en audio‑generatie met hoge fideliteit. GAN’s kunnen scherpe monsters en controleerbare beeldsystemen creëren, maar kunnen moeilijk te trainen zijn.
Variationale auto‑encoders bieden latente‑variabelemodellering en efficiënte representaties, soms gebruikt binnen grotere generatieve pijplijnen. Werkelijke producten combineren vaak meerdere modellen met retrieval, filters, tools en deterministische code.
Conditionering, sampling en controle
Een prompt, klasse‑label, afbeelding, audioclip of gestructureerd record kan generatie conditioneren. Sampling‑parameters wijzigen diversiteit en determinisme. Een lagere temperatuur kan token‑kansen concentreren, maar maakt een onjuist antwoord niet waar.
Controle verbetert wanneer het systeem expliciete schema’s, beperkte decoding, referentiemateriaal en validatie gebruikt. Prompt‑engineering verandert de context; fine‑tuning wijzigt parameters; retrieval levert externe informatie. Elk richt zich op een andere faalmodus.
Evaluatie is toepassingsspecifiek
Tekstsystemen kunnen feitelijkheid, taakvoltooiing, citatieondersteuning, toxiciteit en calibratietests nodig hebben. Beeld‑ of audiosystemen kunnen fideliteit, semantische afstemming, diversiteit, identiteitsveiligheid en perceptuele beoordeling vereisen. Combineer geautomatiseerde metrics met representatieve menselijke evaluatie.
Stel een versie‑gecontroleerde evaluatieset samen die gewone, zeldzame, adversariale en beleidsrelevante gevallen bevat. Volg latentie, kosten en weigergedrag evenals output‑kwaliteit. Een demo die door de maker is geselecteerd, is geen bewijs van betrouwbaarheid op populatieniveau.
Risico’s, waarborgen en herkomst
Belangrijke risico’s omvatten hallucinaties, prompt‑injectie, schadelijke content, impersonatie, onveilige tool‑gebruik, privacy‑lekken, auteursrechtelijke geschillen, automatiseringsbias en ondoorzichtige toeleveringsketens. Het Generative AI‑profiel van NIST organiseert acties over governance, content‑herkomst, pre‑deployment testing en incident‑disclosure.
Gebruik tools met het minste privilege, invoer/uitvoer‑controles, menselijke beoordeling voor consequentiale beslissingen, logging, rollback en gebruikersrapportage. Watermerken of content‑credentials kunnen signalen toevoegen, maar geen enkele detector of label stelt de waarheid vast. De bredere synthetische media workflow moet context en verantwoording behouden.
Modelfamilies en generatie‑mechanismen
Generatieve AI‑modellen schatten of leren een proces dat nieuwe tekst, afbeeldingen, audio, video, code of gestructureerde data kan produceren. Autoregressieve modellen voorspellen het volgende token of element; diffusie‑modellen leren een ruisproces om te keren; variationale auto‑encoders leren probabilistische latente variabelen; GAN’s trainen een generator tegen een discriminator. Multimodale systemen verbinden representaties over media heen. De output wordt gesampled uit geleerde statistische structuur, geconditioneerd op prompts, context, tools of andere inputs – niet opgehaald als een gegarandeerd feit.
Foundation‑modellen zijn voorgetraind op brede data en worden aangepast via prompting, retrieval, fine‑tuning, preference‑optimalisatie, control‑netwerken of taak‑specifieke heads. Tokenizers, encoders, decoders, latente ruimten en sampling‑instellingen bepalen de resultaten. Temperatuur en kandidaat‑filtering balanceren determinisme en diversiteit. Langere prompts bieden context maar kunnen conflicteren, afleiden of kwaadaardige instructies bevatten. Retrieval kan veranderende kennis verankeren, terwijl deterministische code exacte berekeningen en regels moet afhandelen.
Evaluatie, herkomst en rechten
Evalueer per taak: feitelijke juistheid en citatie voor antwoorden, uitvoering en beveiliging voor code, fideliteit en diversiteit voor media, en menselijk resultaat voor creatieve assistentie. Neem weigering, calibratie, latentie, kosten, talen, toegankelijkheid en adversariale tests op. Een vloeiende of fotorealistische output kan onjuist zijn. Bewaar model, prompt, seed, bron‑evidence, tool‑calls en post‑processing voor reproduceerbaarheid. Scheid retrieval‑kwaliteit van generatie zodat een gepolijste antwoord ontbrekende evidence niet kan verbergen.
Training en output roepen vragen op over auteursrecht, licentie, toestemming, privacy, publiciteit en vertrouwelijkheid. Stel herkomst en toegestaan gebruik voor invoergegevens vast; voorkom dat gebruikers geheimen blootleggen; test memorisatie; en bied rapportage‑ en verwijderingsprocessen. Synthetische media moeten, waar mogelijk, duurzame herkomst of disclosure dragen, vooral wanneer ze met bewijs kunnen worden verward. Gebruik geen gelijkenis, stem of stijl op manieren die rechten schenden of misleiden.
Implementatie‑controles
Behandel modeloutput als onbetrouwbare invoer. Valideer schema’s, sanitiseer code en bestanden, isoleer uitvoering, autoriseer elke tool extern, beperk kosten en snelheid, en vraag bevestiging voor consequentiale acties. Monitor falen, misbruik, drift en gebruikerscorrecties, met rollback en een niet‑generatieve fallback. Documenteer beoogd en verboden gebruik. Generatieve AI breidt de interface voor het creëren en transformeren van informatie uit, maar betrouwbaarheid en verantwoording komen van de omringende data, evaluatie, beveiliging, herkomst en het menselijke besluitvormingsproces.
Praktisch voorbeeld: een generatieve productbeschrijvingsassistent
Een retailer laat redacteuren concept‑beschrijvingen genereren uitsluitend op basis van goedgekeurde productattributen en merkrichtlijnen. De prompt bevat gestructureerde feiten, terwijl retrieval het actuele beleid levert. Output moet een schema volgen en wordt gevalideerd tegen bronwaarden; niet‑ondersteunde dimensies, veiligheidsclaims of certificeringen leiden tot afwijzing. Evaluatie omvat feitelijke nauwkeurigheid, stijl, duplicatie, meertalige kwaliteit, toegankelijkheid, latentie en redacteurcorrectie, vergeleken met sjablonen en handmatig schrijven.
Redacteuren keuren elke publicatie goed en kunnen bronvelden inzien. Het model kan geen prijs, voorraad of directe publicatie wijzigen. Prompts en productdata zijn beschermd tegen injectie, en vertrouwelijke leveranciersnotities worden uitgesloten. Monitoring volgt niet‑ondersteunde claims, bewerkingen, klachten, kosten en provider‑versies. Gegenereerde tekst wordt opgeslagen met herkomst. Het systeem bespaart alleen tijd bij het opstellen wanneer correcties en review de meerwaarde niet wegnemen en de productwaarheid wordt beheerd door autoritatieve data.
Implementatie‑bewijs en operationele gereedheid
Een productiebeslissing vereist meer dan een succesvolle demonstratie. Definieer de beoogde gebruikers, operationele omgeving, inputs, outputs, afhankelijkheden, eigenaar en de consequentie van elke belangrijke fout. Stel een reproduceerbare basislijn en een versie‑gecontroleerde evaluatieset op vóór afstemming. Test gewone gevallen, randvoorwaarden, misvormde of ontbrekende invoer, distributieverschuiving, afhankelijkheidsuitval, misbruik, en de groepen of omgevingen die waarschijnlijk onderbediend worden. Meet taakkwaliteit samen met calibratie of onzekerheid, latentie, doorvoersnelheid, resource‑kosten, toegankelijkheid, privacy en beveiliging. Leg elke transformatie en drempel vast zodat een onafhankelijke reviewer het resultaat kan reproduceren en bewijs kan onderscheiden van een aantrekkelijk prototype.
Voor de lancering wijs autoriteit toe voor release, uitzonderingen, wijzigingen, rollback en pensionering. Gebruik een gefaseerde uitrol, behoud een veilige fallback, en verifieer monitoring met doelbewust geïnjecteerde fouten. Operationele telemetrie moet invoerkwaliteit, output‑gedrag, model‑ of regelversie, afhankelijkheidsstatus, menselijke overrides en bevestigde uitkomsten onthullen zonder onnodige gevoelige data te verzamelen. Definieer alarmdrempels en een respons‑eigenaar, beoordeel vervolgens real‑world bewijs na implementatie in plaats van offline prestaties als blijvend aan te nemen. Her‑evalueer wanneer databronnen, gebruikers, modellen, leveranciers, beleid, hardware of doelstellingen veranderen. Een onderhouden systeem vereist ook gedocumenteerd herstel, incident‑leren, verwijder‑ en retentieprocedures, en een duidelijk punt waarop het moet worden uitgeschakeld of vervangen.
Veelgestelde vragen
Is generatieve AI hetzelfde als een groot taalmodel?
Nee. LLM’s vormen één klasse van generatief model. Generatieve AI omvat ook beeld-, audio-, video‑ en gestructureerde‑databasesystemen die met verschillende architecturen zijn gebouwd.
Kopieert een model zijn trainingsdata?
Het synthetiseert meestal uit geleerde patronen, maar memorisatie en bijna‑duplicatie kunnen voorkomen. Privacy‑ en herkomst‑risico’s moeten worden geëvalueerd in plaats van verondersteld te verdwijnen.
Primaire referenties












