
AI-basisprincipes
Wat is Transfer Learning?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Transfer learning hergebruikt kennis die voor één probleem is geleerd om het leren op een gerelateerd probleem te verbeteren. In plaats van elke parameter willekeurig te initialiseren, begint een beoefenaar met een voorgetraind model of representatie en past deze aan voor een doeltaak.
Deze aanpak is vooral nuttig wanneer de doeldataset klein is, labelen duur is, of pretraining meer rekenkracht vereist dan het doelteam kan rechtvaardigen. Een model vanaf nul trainen is het alternatief voor transfer learning — geen type transfer learning.
Belangrijkste punten
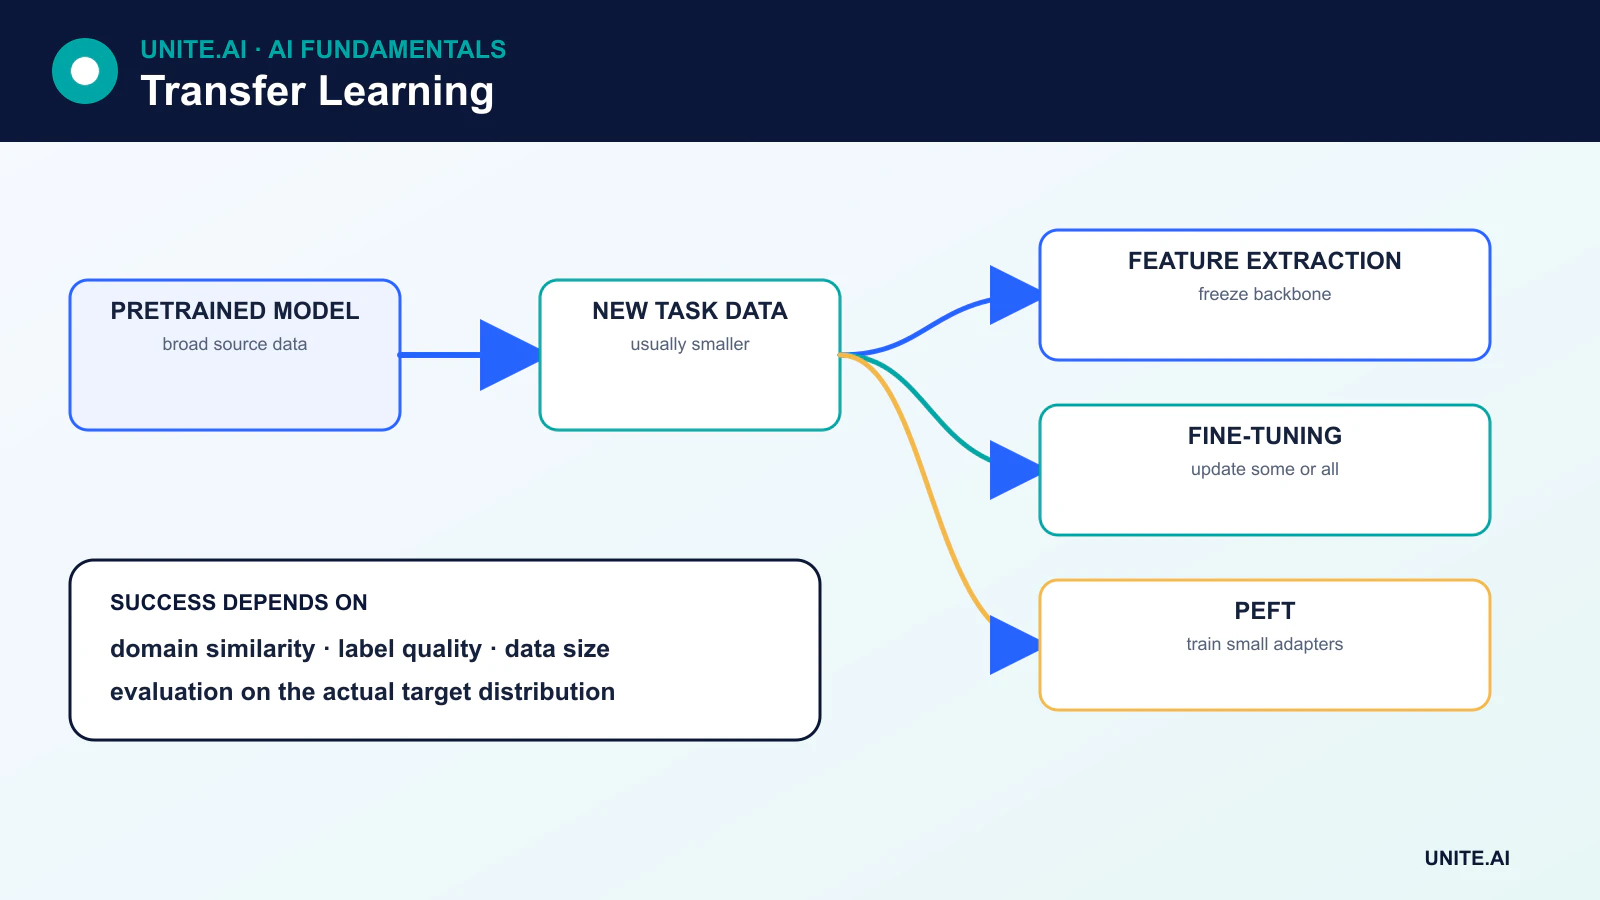
- Feature-extractie houdt een voorgetrainde basis bevroren en traint een nieuwe taak‑specifieke kop.
- Fine-tuning werkt enkele of alle voorgetrainde parameters bij met data uit de doeldomein.
- Parameter‑efficiënte methoden zoals adapters en LoRA passen een klein deel van het model aan.
- Transfer kan mislukken wanneer bron- en doeldomeinen verschillen, licenties conflicteren, of het bronmodel ongepaste bias bevat.
Waarom transfer learning werkt
Modellen leren vaak representaties die bruikbaar zijn buiten de exacte data waarop ze zijn getraind. Vroege lagen van een beeldmodel kunnen herbruikbare lokale patronen vastleggen; een taalmodel kan syntaxis, semantiek en brede associaties leren via zelf‑supervised voorspelling. Een doeltaak kan op die representaties voortbouwen in plaats van alles opnieuw te leren van beperkte voorbeelden.
Het voordeel hangt af van de gelijkenis tussen de bron‑ en doeltaken, de schaal en kwaliteit van de pretraining, en de manier waarop het model wordt aangepast. Hergebruik is niet gegarandeerd: overgedragen kenmerken kunnen irrelevant of zelfs schadelijk zijn.
Feature-extractie
Bij feature-extractie wordt de voorgetrainde basis bevroren zodat de parameters niet veranderen. De output wordt de invoer voor een nieuwe classifier, regressor of andere taak‑specifieke kop. Alleen de nieuwe kop wordt getraind.
Dit is snel en data‑efficiënt, en vermindert het risico bruikbare voorgetrainde representaties te vernietigen. Het kan echter onderfitten wanneer het doeldomein aanzienlijk verschilt van de pretraining. Lagen zoals batch‑normalisatie vereisen speciale zorg omdat hun opgeslagen statistieken en trainingsgedrag de aanpassing kunnen beïnvloeden, zelfs wanneer de meeste gewichten bevroren zijn.
Fijnafstemming
Fijnafstemming werkt voorgetrainde parameters bij met doeldata. Een veelvoorkomende werkwijze is:
- Laad het voorgetrainde model en vervang of voeg de output‑kop toe.
- Bevries de basis en train de nieuwe kop.
- Ontdooi geselecteerde lagen — of het volledige model — en ga verder met een lagere leersnelheid.
- Valideer op overfitting, vergetelheid en prestaties in het doeldomein.
Er bestaat geen universele regel dat alleen de laatste lagen moeten worden afgestemd. De beste keuze hangt af van de architectuur, de grootte van de doel‑data, domeingelijkenis, normalisatielagen, geheugen en rekenkracht. Volledige fine‑tuning kan meer capaciteit bieden, maar vereist meer middelen en kan catastrofisch vergetelheid veroorzaken.
Parameter‑efficiënte fine‑tuning
Grote transformers maken volledige fine‑tuning duur. Parameter‑efficiënte fine‑tuning (PEFT) wijzigt of voegt een kleine set parameters toe terwijl het grootste deel van het basismodel bevroren blijft.
- Adapters voegen kleine trainbare modules toe aan het netwerk.
- LoRA stelt gewichtsupdates voor met low‑rank matrices, waardoor het aantal trainbare parameters en het geheugen van de optimizer worden gereduceerd.
- Prompt‑ en prefix‑tuning leren continue taak‑specifieke invoer of interne prefixen.
PEFT kan veel taak‑aanpassingen rond één basismodel opslaan, hoewel inference‑serving, adapter‑compatibiliteit en beheer van samengevoegde gewichten nog steeds zorgvuldige engineering vereisen.
Transfer learning over verschillende datatypes
Beeldclassifiers beginnen meestal met modellen die voorgetraind zijn op grote beelddatasets. Taal systemen starten vanaf een foundation‑model en passen dit aan via supervised fine‑tuning, voorkeuroptimalisatie, retrieval of tool‑gebruik. Spraak-, audio-, eiwit- en multimodale modellen volgen vergelijkbare patronen.
Transfer kan ook plaatsvinden zonder het originele model te wijzigen. Een bevroren model kan embeddings produceren voor een downstream‑classifier, een vector‑similariteit‑zoek systeem, of een retrieval‑pipeline.
Domeinsverschuiving en negatieve transfer
Domeinsverschuiving treedt op wanneer doel‑invoer verschilt van bron‑data. Een medisch beeldmodel kan bijvoorbeeld apparatuur, populaties of acquisitie‑protocollen tegenkomen die afwezig waren tijdens de pretraining. Negatieve transfer betekent dat hergebruik de doelprestatie slechter maakt dan een geschikt vanaf‑nul‑referentie.
Teams moeten adaptatiestrategieën vergelijken, betekenisvolle subgroepen evalueren en een testset voor het doeldomein behouden. Als de bron‑taak slecht aansluit, kan een kleiner domeinspecifiek model beter presteren dan een groter algemeen model.
Licenties, herkomst en beveiliging
Een downloadbaar model is niet automatisch veilig om in te zetten. Controleer de licentie, toegestane toepassingen, openbaarmaking van trainingsdata, beperkingen in de model‑card en de afhankelijkheidsketen. Modellen kunnen bias reproduceren, gevoelige data memoriseren of kwaadaardige geserialiseerde code bevatten. Gebruik vertrouwde formaten, scan artefacten en laad onbetrouwbare gewichten in een geïsoleerde omgeving.
Wanneer transfer learning te gebruiken
Transfer learning is een sterke standaard wanneer een relevant voorgetraind model bestaat en de doel‑data beperkt is. Training vanaf nul kan de voorkeur hebben wanneer het domein sterk gespecialiseerd is, de licentie onverenigbaar is, de modelgrootte de inzetlimieten overschrijdt, of een eenvoudige taak niet profiteert van een grote voorgetrainde representatie. De beslissing moet empirisch worden gevalideerd in plaats van te worden aangenomen op basis van de modelgrootte.
Wat wordt overgedragen en hoe pas je het aan
Transfer learning hergebruikt representaties die zijn geleerd op een bron‑taak of dataset voor een doeltaak. In vision vangen vroege kenmerken vaak randen en texturen; in taal coderen voorgetrainde modellen statistische patronen over tokens en contexten. Transfer werkt wanneer bron‑representaties informatie bevatten die relevant is voor het doel, maar domein‑, label‑, modaliteits‑ en acquisitiedifferenties kunnen negatieve transfer veroorzaken. Begin met een voorgetrainde basis, controleer de trainingslicentie en documentatie, en vergelijk dit met het trainen van een klein doel‑specifiek model vanaf nul.
Feature-extractie bevriest de backbone en traint een nieuwe kop; gedeeltelijke fine‑tuning ontdooit geselecteerde lagen; volledige fine‑tuning werkt het hele model bij. Parameter‑efficiënte methoden voegen adapters of low‑rank updates toe, waardoor het aantal trainbare parameters wordt gereduceerd, maar niet noodzakelijk het inference‑geheugen. Gebruik een lagere leersnelheid voor voorgetrainde gewichten, behoud het normalisatiegedrag, en vermijd catastrofisch vergetelheid met schema’s, regularisatie, herhaling of begrensde updates waar nodig. Selecteer checkpoints op doel‑validatiedata en test meerdere random seeds omdat kleine doel‑datasets een hoge variantie opleveren.
Data, evaluatie en inzetafwegingen
Doel‑data moet de inzetcondities en belangrijke subgroepen weerspiegelen, en niet alleen een handig gelabeld monster zijn. Splits op onderwerp, bron, tijd of locatie om te voorkomen dat verwante voorbeelden over partities heen vallen. Test zowel in‑domain als verschoven condities. Vergelijk bevroren, gedeeltelijk afgestemde en volledig afgestemde varianten op kwaliteit, calibratie, trainingskosten, latentie en robuustheid. Een verbetering in de gemiddelde score kan een verlies verbergen op zeldzame klassen die voortkomen uit bron‑bias. Bekijk foutvoorbeelden voor bron‑specifieke shortcuts, vocabulaire‑gaten of sensorverschillen.
Houd het basismodel, de gewichten, tokenizer of preprocessing, adapter, data en licentie bij als één afhankelijkheids‑grafiek. Gehoste basismodellen kunnen gedrag veranderen; open gewichten kunnen toeleveringsketen‑ en patch‑verantwoordelijkheden introduceren. Valideer het samengevoegde of geëxporteerde artefact en scan modelbestanden van onbetrouwbare bronnen. In productie, monitor doel‑drift en prestaties, en behoud de mogelijkheid om zowel de aanpassing als de basisversie terug te draaien. Transfer vermindert de benodigde doel‑data; het elimineert niet het labelen, de evaluatie, privacy of domeinexpertise.
Voorbeeld: een vision‑model aanpassen aan een nieuwe kliniek
Een kliniek past een voorgetrainde beeld‑encoder aan om de beeldkwaliteit te classificeren vóór diagnostische beoordeling. Ze verifiëren de licentie en beoogde modaliteit van het bronmodel, verzamelen lokale apparaten en acquisitie‑condities, en splitsen per patiënt. Varianten met bevroren features, adapters, gedeeltelijke en volledige fine‑tuning worden vergeleken met een kleine lokale basislijn. Metingen omvatten klasse‑recall, calibratie, subgroep‑gedrag, rekencapaciteit en gevoeligheid voor apparaat, locatie en zeldzame artefacten.
Het aangepaste model kan geen diagnose stellen en leidt beelden met lage zekerheid of zonder ondersteuning door naar technici. Export‑validatie bevestigt lokale preprocessing en numerieke gelijkheid. Model-, adapter-, apparaat- en dataset‑versies worden in het dossier gekoppeld. Monitoring detecteert nieuwe scanners, protocolwijzigingen en output‑drift, terwijl periodieke beoordeelde monsters de werkelijke prestatie schatten. Een upgrade van het bronmodel wordt behandeld als een nieuwe afhankelijkheid die validatie vereist; transfer learning rechtvaardigt niet automatisch het hergebruiken van oud bewijs.
Implementatie‑bewijs en operationele gereedheid
Een productiebeslissing vereist meer dan een succesvolle demonstratie. Definieer de beoogde gebruikers, operationele omgeving, invoer, uitvoer, afhankelijkheden, eigenaar en de consequentie van elke belangrijke fout. Stel een reproduceerbare basislijn en een versie‑gebaseerde evaluatieset vast vóór afstemming. Test gewone gevallen, randvoorwaarden, misvormde of ontbrekende invoer, distributieverschuiving, afhankelijkheidsuitval, misbruik, en de groepen of omgevingen die waarschijnlijk onderbediend zijn. Meet taakkwaliteit samen met calibratie of onzekerheid, latentie, doorvoersnelheid, resource‑kosten, toegankelijkheid, privacy en beveiliging. Leg elke transformatie en drempel vast zodat een onafhankelijke reviewer het resultaat kan reproduceren en bewijs kan onderscheiden van een aantrekkelijk prototype.
Voor de lancering moet autoriteit worden toegewezen voor release, uitzonderingen, wijzigingen, rollback en pensionering. Gebruik een gefaseerde uitrol, behoud een veilige fallback, en verifieer monitoring met opzettelijk geïnjecteerde fouten. Operationele telemetrie moet de invoerkwaliteit, output‑gedrag, model‑ of regelversie, afhankelijkheidsgezondheid, menselijke overrides en bevestigde uitkomsten onthullen zonder onnodige gevoelige data te verzamelen. Definieer alarm‑drempels en een verantwoordelijke voor de respons, en beoordeel vervolgens real‑world bewijs na inzet in plaats van aan te nemen dat offline prestaties blijven bestaan. Her‑evalueer telkens wanneer databronnen, gebruikers, modellen, leveranciers, beleidsregels, hardware of doelstellingen veranderen. Een onderhouden systeem heeft ook gedocumenteerd herstel, incident‑leren, verwijder‑ en retentieprocedures, en een duidelijk punt waarop het moet worden uitgeschakeld of vervangen nodig.
Primaire referenties











