
AI-basisprincipes
Wat zijn CNN’s (Convolutionele Neurale Netwerken)?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
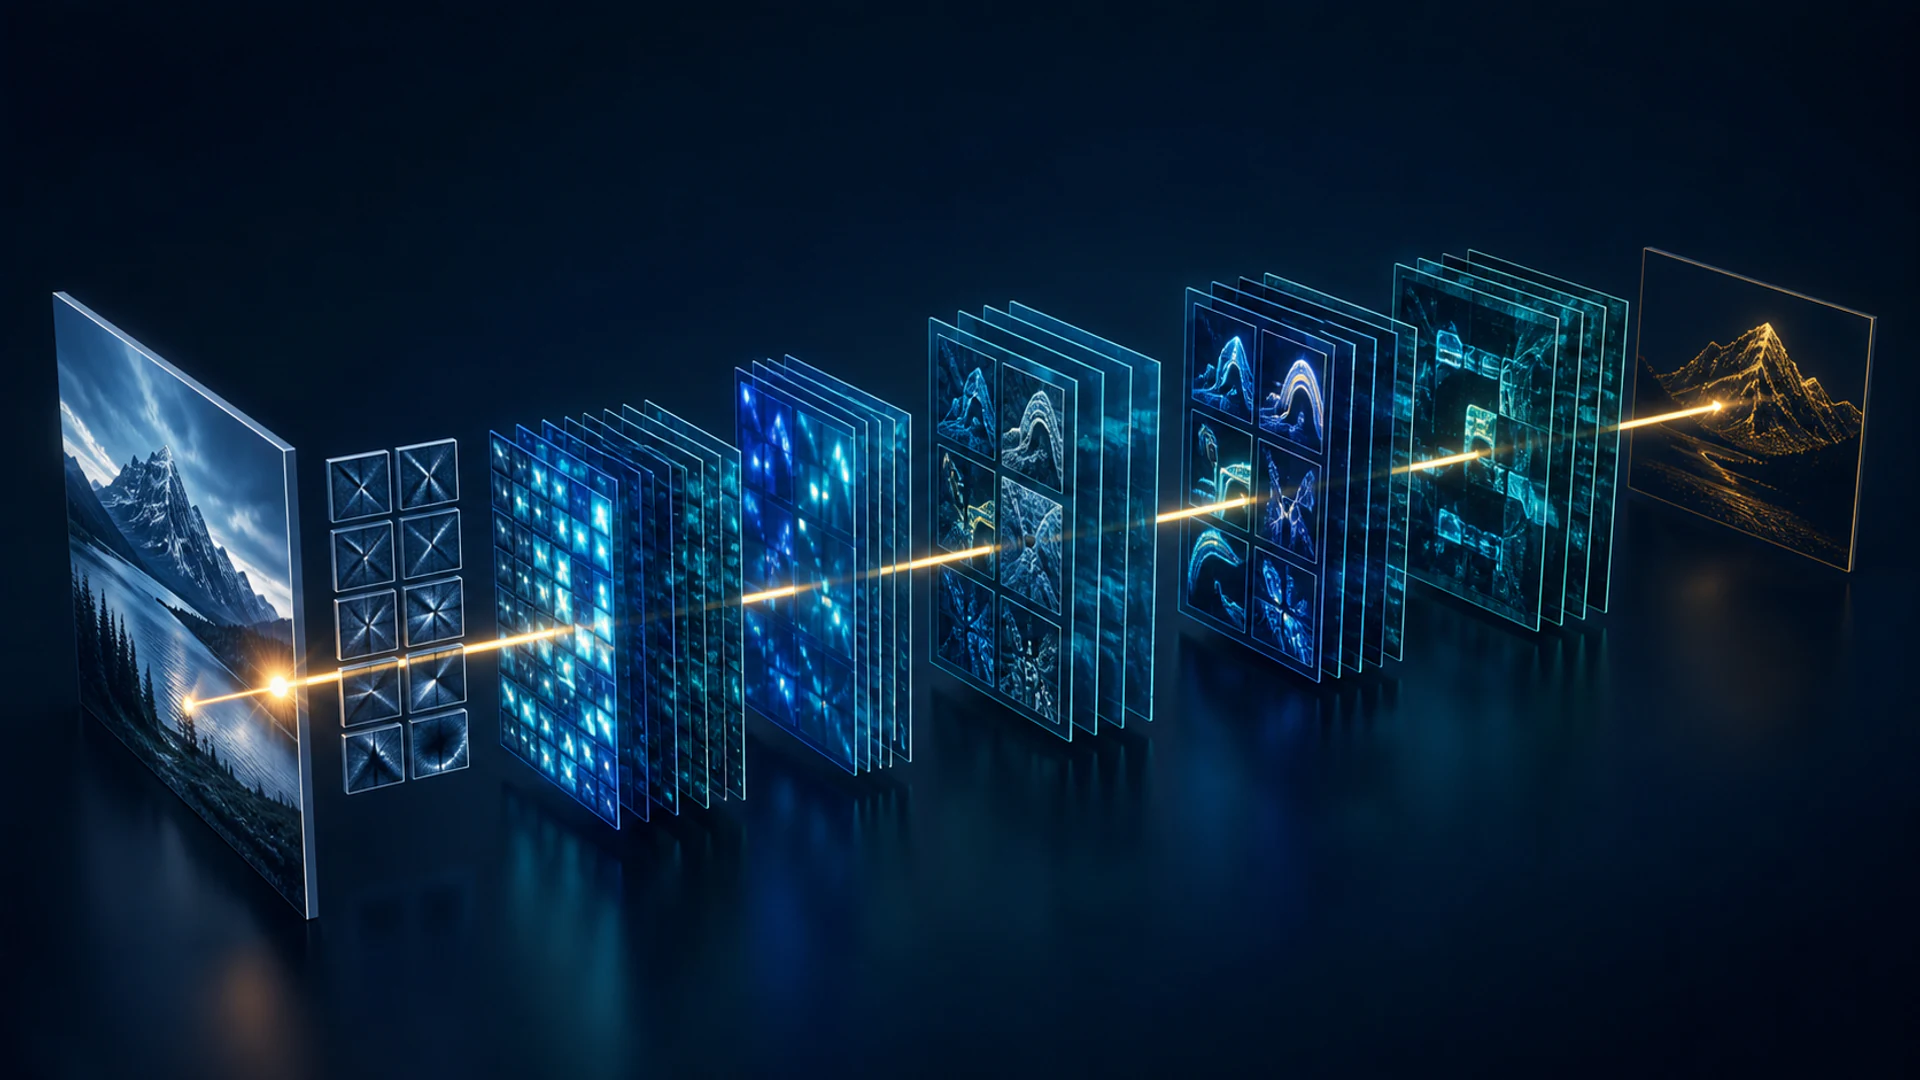
Een convolutioneel neuraal netwerk (CNN) is een neuraalnetwerkarchitectuur die geleerde filters over lokale gebieden van een invoer gebruikt. CNN’s werden fundamenteel voor moderne computer vision omdat ze patronen kunnen detecteren ongeacht waar die patronen verschijnen en dezelfde parameters over een afbeelding hergebruiken.
Een CNN zet een afbeelding niet van niet‑numerieke naar numerieke vorm om – de afbeelding komt al binnen als een tensor van pixelwaarden. Het doel is die tensor te transformeren naar feature‑maps die bruikbaar zijn voor classificatie, detectie, segmentatie of een andere taak.
Belangrijkste punten
- Een convolutie combineert lokale invoerwaarden met een geleerde kernel om een feature‑map te produceren.
- Stride, padding, dilatatie en pooling bepalen de ruimtelijke resolutie en het receptieve veld.
- Gewichtsdeling maakt CNN’s parameter‑efficiënter dan een volledig verbonden netwerk over ruwe pixels.
- Vision‑transformers bieden een alternatief, maar CNN’s blijven sterk voor efficiënte en data‑beperkte systemen.
Hoe convolutie werkt
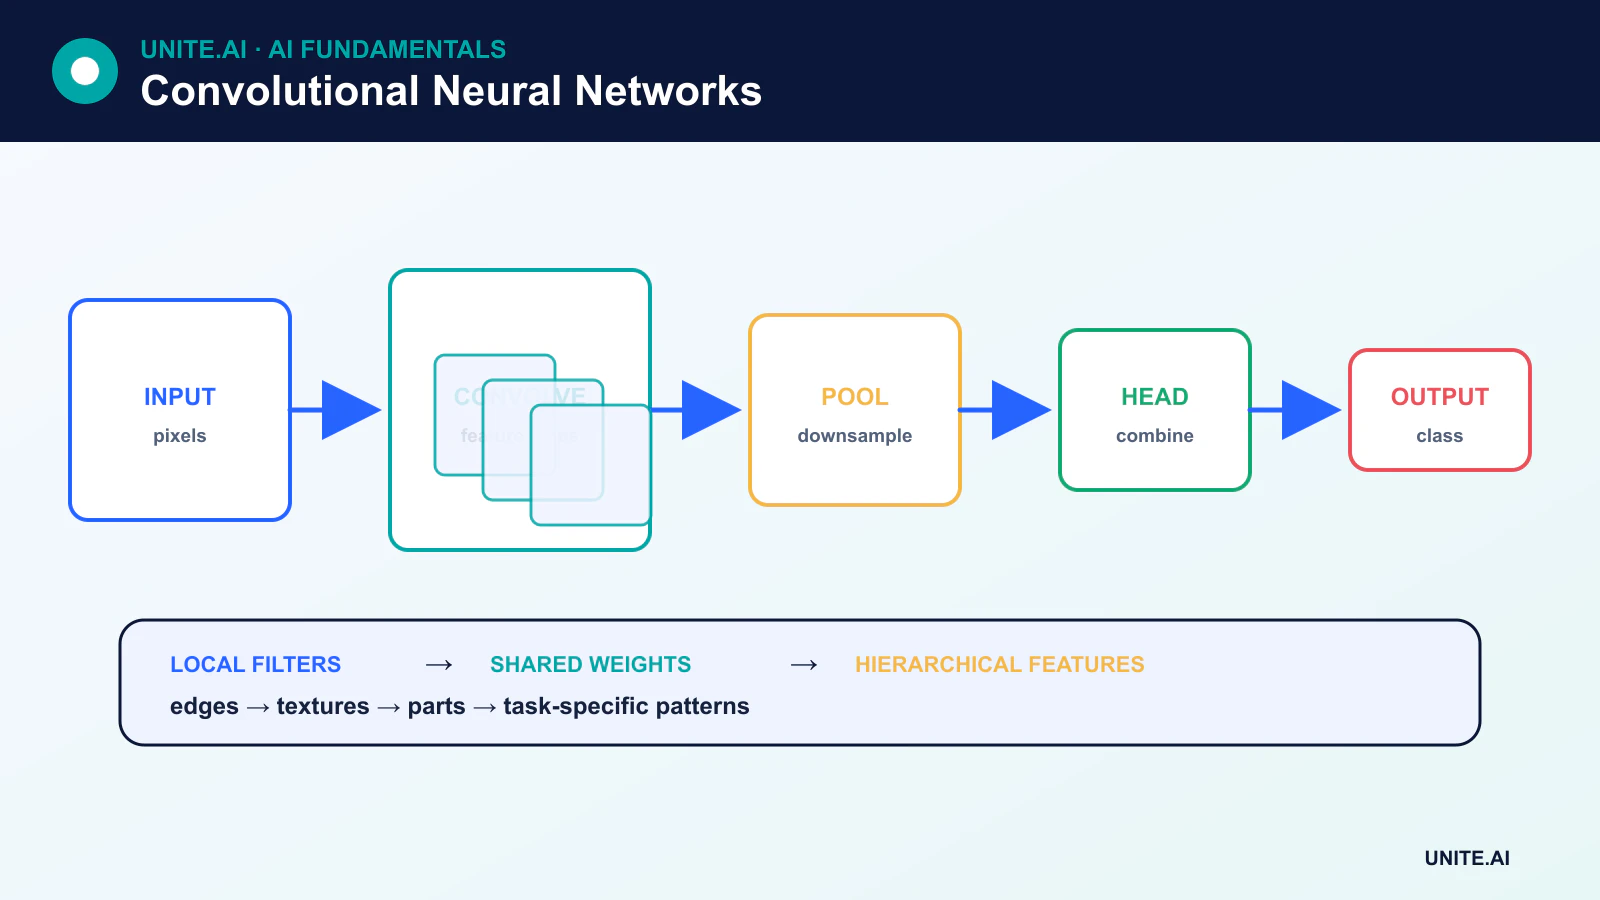
Een kernel is een klein raster van trainbare gewichten. Op elke positie vermenigvuldigt de CNN de kernelwaarden met de overeenkomstige invoerwaarden, telt de resultaten op en voegt meestal een bias toe. Door dit over de invoer te herhalen ontstaat een feature‑map.
Voor een kleurenafbeelding bestrijkt een kernel alle invoerkanalen. Een laag gebruikt meerdere kernels om meerdere outputkanalen te creëren. Tijdens het trainen berekent backpropagation de gradiënten voor deze kernelgewichten; de convolutie‑operatie maakt geen nieuwe vaste set gewichten aan voor elke afbeelding.
Stride, padding en dilatatie
- Stride bepaalt hoe ver de kernel beweegt. Een stride groter dan één verlaagt de ruimtelijke resolutie.
- Padding voegt waarden toe rond een invoer zodat randinformatie kan worden verwerkt en de outputgrootte kan worden gecontroleerd.
- Dilatatie spreidt kernel‑elementen uit, waardoor het receptieve veld wordt vergroot zonder proportioneel meer parameters toe te voegen.
Het receptieve veld is het gebied van de oorspronkelijke invoer dat een eenheid kan beïnvloeden. Het stapelen van convoluties vergroot dit, waardoor latere features informatie uit bredere gebieden kunnen combineren.
Activatie, normalisatie en pooling
Convolutionele lagen worden vaak gevolgd door niet‑lineaire activaties en normalisatie. Pooling vat lokale regio’s samen met een operatie zoals maximum of gemiddelde. Geleerde strided convoluties kunnen ook downsamplen.
Pooling is niet verplicht. Veel moderne netwerken gebruiken globale gemiddelde pooling nabij de output in plaats van een grote feature‑map te flattenen naar een volledig verbonden stapel. Dit vermindert parameters en laat het netwerk ruimtelijk bewijs aggregeren.
Een moderne CNN‑architectuur
Een typisch vision‑model bevat een stem, een reeks feature‑blokken, downsampling‑fasen en een taak‑head. Residual‑verbindingen laten een blok een aanpassing van zijn invoer leren en bieden een directe route voor informatie en gradiënten. Het succes van residual‑netwerken maakte het praktisch om veel diepere CNN’s te trainen.
Classificatie‑heads produceren klassen‑scores. Detectie‑heads voorspellen categorieën en boxen. Segmentatie‑architecturen voegen decoder‑paden toe die ruimtelijke details herstellen. Dezelfde CNN‑backbone kan opnieuw worden gebruikt via transfer learning.
Wat CNN‑lagen leren
Het is gebruikelijk om vroege filters te visualiseren die reageren op randen of texturen en latere representaties die correleren met delen of objecten. Dit is een nuttige intuïtie, maar geen vaste regel. Features hangen af van de taak, architectuur, data, doelstelling en het trainingsproces, en sommige eenheden combineren informatie die niet netjes overeenkomt met een menselijk concept.
CNN’s versus vision‑transformers
Vision‑transformers delen afbeeldingen op in patches en gebruiken attention om relaties daartussen te modelleren. Ze kunnen effectief opschalen met grote pre‑training datasets. CNN’s bouwen localiteit en translatie‑gerelateerde aannames direct in de architectuur, wat ze efficiënter en data‑effectiever kan maken in kleinere omgevingen.
Veel praktische systemen combineren convolutie en attention. De juiste architectuur hangt af van nauwkeurigheid, latentie, geheugen, trainingsdata, hardware en implementatie – niet van welke familie het nieuwste is.
Beperkingen en praktische overwegingen
CNN’s kunnen gevoelig zijn voor distributieveranderingen, adversariële perturbaties, achtergrond‑shortcuts en bevooroordeelde trainingsdata. Ze zijn niet perfect invariant voor positie, rotatie, schaal of gezichtspunt. Augmentatie en architectuurkeuzes kunnen de robuustheid verbeteren, maar bieden geen garantie.
Voor implementatie moet je end‑to‑end latentie, geheugen, doorvoersnelheid en subgroepgedrag meten. Kwantisatie en pruning kunnen kosten verlagen, vooral voor edge AI, maar gecomprimeerde modellen moeten opnieuw gevalideerd worden.
Convolutie, receptieve velden en moderne CNN‑blokken
Een convolutionele laag schuift geleerde kernels over een raster en deelt gewichten over posities. Kernelgrootte, stride, dilatatie en padding bepalen de outputvorm en het receptieve veld. Vroege lagen reageren vaak op lokale randen of texturen; diepere lagen combineren informatie over grotere gebieden, hoewel geleerde representaties niet noodzakelijk netjes overeenkomen met menselijke concepten. Pooling of strided convolutie verlaagt de ruimtelijke resolutie. Kanalen dragen feature‑maps, terwijl gegroepeerde en depthwise gescheiden convoluties cross‑channel mixing ruilen voor minder rekenwerk. Residual‑verbindingen maken zeer diepe netwerken makkelijker te optimaliseren.
Voor een invoerhoogte en -breedte bepaalt padding de behandeling van de rand en bepaalt stride de sampling. Agressieve downsampling kan kleine objecten verwijderen; zero padding kan randartefacten veroorzaken; dilatatie vergroot de context zonder dezelfde parametergroei, maar kan tot rastervorming leiden. Batch‑normalisatie hangt af van trainingsstatistieken, terwijl alternatieven beter kunnen presteren bij kleine batchgroottes. Moderne architecturen combineren bottlenecks, multi‑scale features, attention of omgekeerde residuals. Kies een architectuur op basis van taakresolutie, geheugenbandbreedte, latentie en doel‑hardware in plaats van alleen nauwkeurigheid van beeldclassificatie.
Training, interpretatie en implementatie
Gebruik augmentaties die labels behouden en echte variatie weerspiegelen, en splits op onderwerp of scène vóór augmentatie. Transfer learning is gebruikelijk: vervang de taak‑head, train deze, en ontdooi vervolgens voorzichtig de backbone. Evalueer klassen‑specifieke prestaties, calibratie, robuustheid tegen vervaging, compressie, verlichting, schaal, uitsnede en adversariële perturbatie. Visualisatiemethoden zoals feature‑maps en salientie kunnen shortcuts onthullen, maar ze zijn gevoelig voor methode en baseline. Bevestig vermoedelijke afhankelijkheid met contrafactuele afbeeldingen, occlusietests of dataset‑wijzigingen.
Geëxporteerde CNN’s kunnen worden gefuseerd, gekwantiseerd of gecompileerd voor GPU, NPU, browser of microcontroller. Valideer de gedeployde graph, inclusief preprocessing en postprocessing, op exacte apparaten. Meet end‑to‑end latentie, geheugen, energie en thermisch gedrag; input‑decodering kan een klein model domineren. Monitor camera‑ en afbeeldingsstatistieken, output‑distributie en bevestigde fouten. Gesigneerde model‑artefacten, beschermde update‑kanalen en een elegante sensor‑foutafhandeling maken deel uit van het productie‑ontwerp. CNN’s coderen een nuttige localiteitsbias, maar ze begrijpen niet automatisch objecten of causale scènes.
Voorbeeld: een CNN implementeren op een inspectiecamera
Een CNN classificeert oppervlakte‑defecten uit hoge‑resolutie line‑scan afbeeldingen. Ingenieurs delen afbeeldingen in tegels met overlap zodat kleine defecten downsampling overleven, behouden coördinaten voor beoordeling, en valideren augmentaties tegen echte optische variatie. Een residual CNN en een lichtere depthwise‑model worden vergeleken bij gelijke recall. Tests omvatten rand‑defecten, schittering, compressie, beweging, materiaal‑batches en camera‑vervangingen, met onafhankelijke productielots gereserveerd voor de uiteindelijke evaluatie.
Compilatie fuseert en kwantiseert het model voor een edge‑accelerator, maar de gedeployde graph wordt vergeleken met de referentie op gevoelige defectgevallen. Decode, tiling, inferentie en merge‑latentie worden end‑to‑end gemeten. Het systeem markeert dode pixels en belichtingsdrift apart van productdefecten. Operators kunnen bron‑tegels inspecteren en resultaten overschrijven. Model‑ en camera‑wijzigingen worden geleidelijk uitgerold, en de productielijn behoudt een veilige handmatige inspectieprocedure wanneer de vision‑pipeline niet beschikbaar is.
Implementatie‑bewijs en operationele gereedheid
Een productie‑beslissing vereist meer dan een succesvolle demonstratie. Definieer de beoogde gebruikers, operationele omgeving, inputs, outputs, afhankelijkheden, eigenaar en de consequentie van elke belangrijke storing. Stel een reproduceerbare basislijn en een versie‑gebaseerde evaluatieset op vóór afstemming. Test gewone gevallen, randvoorwaarden, misvormde of ontbrekende invoer, distributieverandering, afhankelijkheidsuitval, misbruik, en de groepen of omgevingen die waarschijnlijk onderbediend worden. Meet taakkwaliteit samen met calibratie of onzekerheid, latentie, doorvoersnelheid, resource‑kosten, toegankelijkheid, privacy en beveiliging. Leg elke transformatie en drempel vast zodat een onafhankelijke reviewer het resultaat kan reproduceren en bewijs kan onderscheiden van een aantrekkelijk prototype.
Voor de lancering moet autoriteit worden toegewezen voor release, uitzonderingen, wijzigingen, rollback en pensionering. Gebruik een gefaseerde uitrol, behoud een veilige fallback, en verifieer monitoring met opzettelijk geïnjecteerde storingen. Operationele telemetrie moet invoer‑kwaliteit, output‑gedrag, model‑ of regel‑versie, afhankelijkheidsstatus, menselijke overrides en bevestigde uitkomsten onthullen zonder onnodige gevoelige data te verzamelen. Definieer alarm‑drempels en een verantwoordelijke, en beoordeel vervolgens bewijsmateriaal uit de praktijk na implementatie in plaats van aan te nemen dat offline prestaties aanhouden. Evalueer opnieuw wanneer gegevensbronnen, gebruikers, modellen, leveranciers, beleid, hardware of doelstellingen veranderen. Een onderhouden systeem heeft ook gedocumenteerd herstel, incident‑leren, verwijder‑ en retentieprocedures, en een duidelijk punt waarop het moet worden uitgeschakeld of vervangen.
Veelgestelde vragen
Moet een CNN altijd pooling gebruiken?
Nee. Een CNN kan downsamplen met strided convolutie en kan resolutie behouden voor dichte voorspelling. Pooling is een ontwerptool, geen bepalende vereiste.
Zijn CNN‑filters handmatig ontworpen?
In een getrainde CNN worden kernelwaarden normaal gesproken uit data geleerd. Dit verschilt van klassieke vision‑filters waarvan de coëfficiënten vooraf worden gekozen voor bewerkingen zoals randdetectie.
Primaire referenties












