
AI-basisprincipes
Wat is uitlegbare AI?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Explainable AI (XAI) omvat methoden en praktijken die mensen helpen het gedrag of de output van een AI‑systeem te begrijpen. Een uitleg kan invloedrijke invoer beschrijven, een vergelijkbaar voorbeeld tonen, een contrafactuele wijziging presenteren, een globale regel samenvatten of aangeven wanneer het systeem het niet weet.
Er bestaat geen uitleg die in alle situaties het beste is. Een ontwikkelaar die een model debuggt, een auditor die beleidsnaleving test en een persoon die door een beslissing wordt getroffen, hebben verschillende bewijsmaterialen nodig. Uitleg moet daarom worden geëvalueerd op nauwkeurigheid, betekenis en beoogd gebruik – niet alleen op visuele aantrekkelijkheid.
Belangrijkste punten
- Transparantie beschrijft beschikbare informatie; interpretabiliteit betreft betekenis; een uitleg communiceert bewijs of redenen.
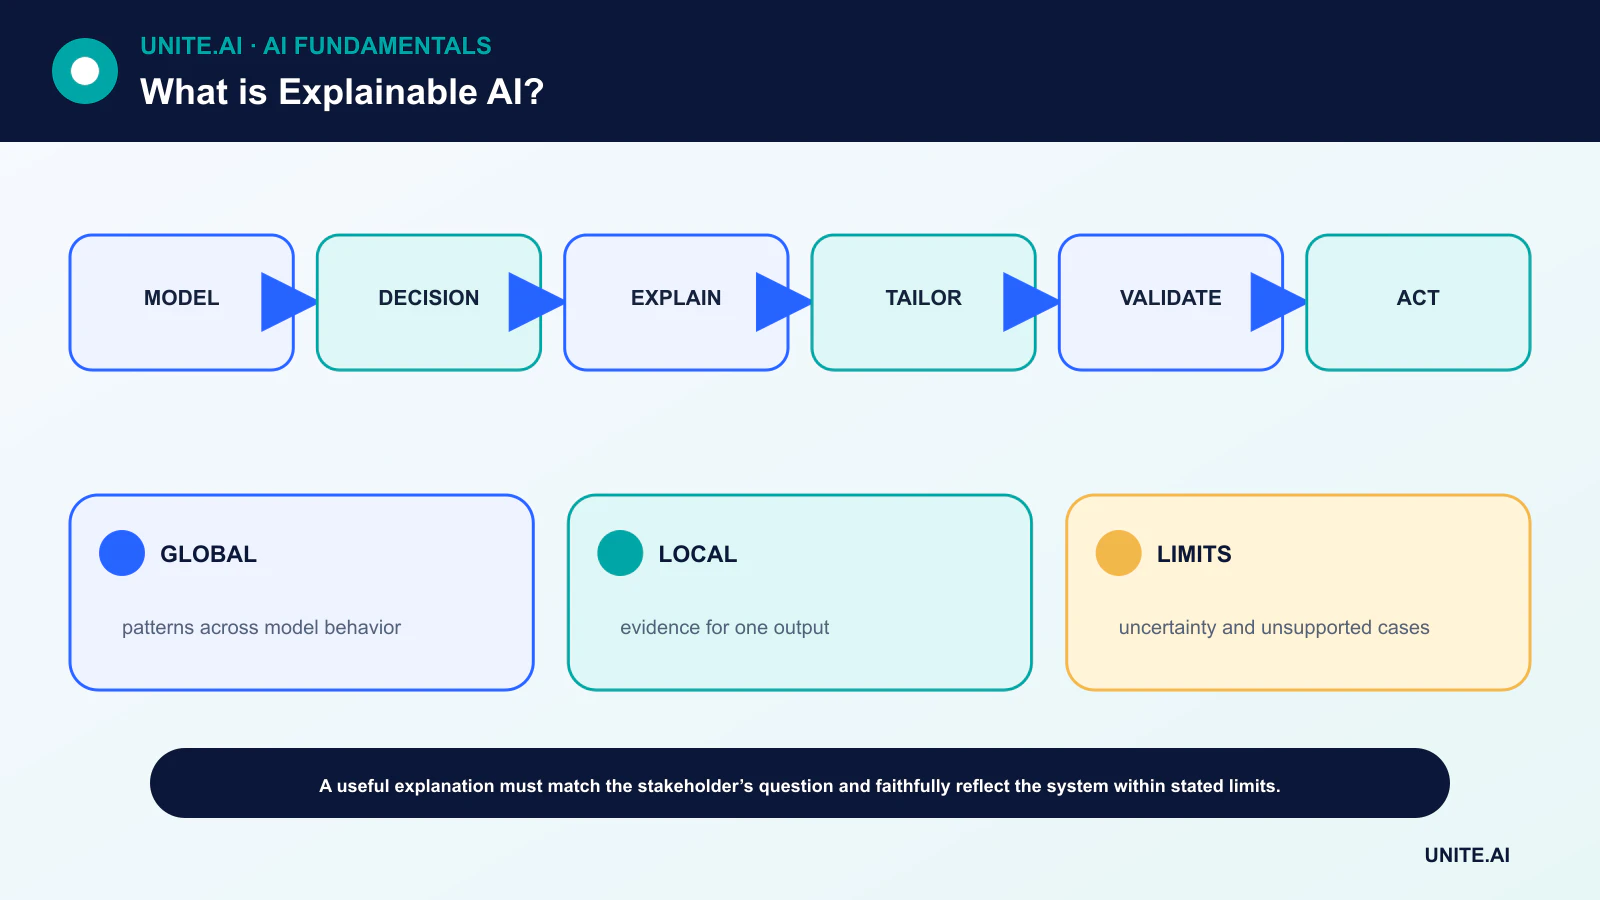
- Globale methoden vatten een model samen, terwijl lokale methoden één voorspelling of een klein gebied behandelen.
- Post‑hoc‑uitleg kan nuttig zijn, maar kan onstabiel of ontrouw aan het onderliggende model zijn.
- Een uitleg bewijst geen eerlijkheid, causaliteit, robuustheid of juistheid.
Vier principes voor nuttige uitleg
NIST stelt voor dat een systeem een uitleg biedt, deze betekenisvol maakt voor de beoogde gebruiker, ervoor zorgt dat hij het proces van het systeem nauwkeurig weergeeft, en de kennisgrenzen communiceert. Deze principes scheiden het bestaan van een uitleg van de kwaliteit ervan.
Betekenis is afhankelijk van het publiek. Een beknopte redencode kan een aanvrager helpen, terwijl een modelontwikkelaar distributies, gedrag van kenmerken en faalklusters nodig heeft. Beide moeten verbonden zijn met hetzelfde gedocumenteerde systeem en de besluitvormingscontext.
Intrinsieke en post‑hoc‑methoden
Een spaarzaam lineair model of een begrensde decision tree kan direct interpreteerbaar zijn binnen zijn geldige bereik. Een complex model kan in plaats daarvan post‑hoc‑kenmerktoeschrijving, een lokaal surrogate‑model, voorbeelden, salientie‑kaarten of contrafacten gebruiken.
Intrinsieke eenvoud is niet automatisch getrouw wanneer kenmerken slecht gedefinieerd zijn of de pijplijn verborgen blijft. Post‑hoc‑complexiteit is niet automatisch misleidend. De methode moet worden getest tegen de vraag die hij moet beantwoorden.
Kenmerktoeschrijving en gecorreleerde invoer
Toeschrijvingsmethoden wijzen delen van een output toe aan invoerkenmerken onder expliciete aannames. LIME past een eenvoudig lokaal surrogate‑model rond een voorspelling; SHAP‑gerelateerde methoden verbinden additieve toeschrijvingen met Shapley‑waardeconcepten.
Gecorreleerde kenmerken kunnen toeschrijvingen delen of uitwisselen, en een hoge toeschrijving is geen causaal effect. Het wijzigen van een kenmerk op zichzelf kan een onmogelijke persoon, afbeelding of transactie opleveren. Uitleg moet hun basislijn, steekproef‑ en afhankelijkheidsaannames vermelden.
Contrafacten, voorbeelden en globaal gedrag
Een contrafact vraagt welke haalbare wijziging een uitkomst zou veranderen. Beperkingen zijn essentieel: een uitvoerbare uitleg mag geen onveranderlijke, illegale of onrealistische wijzigingen aanbevelen. Op voorbeelden gebaseerde methoden tonen prototypes of invloedrijke trainingsgevallen, maar kunnen privégegevens blootleggen.
Globale analyse onderzoekt prestaties, partiële afhankelijkheid, monotoniciteit, interacties en subgroepsgedrag. Voor ensembles zoals gradient boosting combineer samenvattingen met lokaal bewijs en directe tests van verwachte beperkingen.
Valideer de uitleg en het systeem
Test de getrouwheid, stabiliteit onder kleine perturbaties, consistentie over equivalente invoer, gebruikersbegrip en of de uitleg een passende beslissing ondersteunt. Adversariële tests moeten nagaan of een overtuigende uitleg een verkeerde of gemanipuleerde output kan vergezellen.
XAI maakt deel uit van een bredere evaluatie: kwaliteit op een testset, calibratie, eerlijkheid, privacy, beveiliging, monitoring en beroepsmechanismen. Een uitleg kan verantwoording ondersteunen, maar kan geen verantwoorde governance vervangen.
Doelstellingen van uitleg en methodenfamilies
Uitlegbare AI moet beginnen met een vraag en publiek: waarom een beslissing plaatsvond, hoe het model zich over het algemeen gedraagt, welk bewijs het beïnvloedde, wat het resultaat zou veranderen, of of een beleid werd nageleefd. Lokale uitleg behandelt één voorspelling; globale uitleg vat breder gedrag samen. Intrinsiek interpreteerbare modellen tonen coëfficiënten, regels of structuren, terwijl post‑hoc‑methoden complexe modellen benaderen. Een uitleg van modelgedrag is niet automatisch een causale verklaring van de werkelijkheid of een rechtvaardiging dat een beslissing eerlijk is.
Kenmerktoeschrijvingsmethoden omvatten gradients, geïntegreerde gradients, SHAP‑achtige waarden, permutatie en lokale surrogate‑modellen. Op voorbeelden gebaseerde uitleg haalt invloedrijke of vergelijkbare gevallen op; contrafacten stellen wijzigingen voor die geassocieerd zijn met een andere output; conceptmethoden relateren interne representaties aan menselijke categorieën. Elk heeft aannames over basislijnen, onafhankelijkheid van kenmerken, lokale lineariteit of modeltoegang. Gecorreleerde variabelen, interacties en preprocessing kunnen toeschrijvingen onstabiel of misleidend maken. Vergelijk methoden en perturbeer invoer om te testen of een uitleg gedrag voorspelt.
Evaluatie en menselijke factoren
Evalueer de getrouwheid – of de uitleg overeenkomt met het model – los van de plausibiliteit voor een persoon. Test stabiliteit, sensitiviteit, volledigheid, spaarzaamheid en bruikbaarheid voor een gedefinieerde taak zoals debuggen of beroep. Menselijke studies hebben representatieve deelnemers nodig en moeten de kwaliteit van beslissingen, foutdetectie, vertrouwen en tijd meten, niet of gebruikers vinden dat een grafiek duidelijk is. Een overtuigende uitleg kan het vertrouwen in een verkeerd model vergroten, dus interfaces moeten onzekerheid, alternatieven en beperkingen tonen.
Contrafacten moeten haalbaar en uitvoerbaar zijn en geen wijziging van beschermde of onveranderlijke eigenschappen aanbevelen. Uitleg kan model- of persoonlijke informatie lekken en aanvallers helpen beslissingen te reverse‑engineeren. Pas toegangscontroles en output‑minimalisatie toe. Voor gereguleerde of high‑impact toepassingen moet de gegevensherkomst, modelversie, drempel en feitelijke besluitlogica worden bewaard; een generieke grafiek van kenmerk‑importantie kan geen juridisch betekenisvolle reden of menselijke beoordeling vervangen.
Uitleg verantwoord gebruiken
Kies het eenvoudigste model dat voldoet aan de prestatie‑ en operationele eisen, maar schaaf de geldigheid niet af voor oppervlakkige interpreteerbaarheid. Combineer uitleg met subgroep‑tests, robuustheidscontroles, causale analyse waar relevant, en uitkomstmonitoring. Documenteer het beoogde publiek en ongeldige gevolgtrekkingen. Als een uitleg verandert na een onschadelijke perturbatie, onderzoek dit dan vóór implementatie. Uitlegbaarheid is bewijs over een systeem onder een methode; het is waardevol voor debuggen, toezicht en communicatie, maar het certificeert geen waarheid, eerlijkheid, veiligheid of begrip.
Praktisch voorbeeld: een kredietrisicomodel uitleggen
Een kredietverstrekker definieert eerst het publiek en de benodigde reden: aanvragers hebben nauwkeurige beslissingsfactoren en een correctiepaden nodig, terwijl ontwikkelaars diagnostiek nodig hebben. Een gekalibreerde interpreteerbare basislijn wordt vergeleken met een boosted model. Lokale toeschrijvingen, contrafacten en globale foutanalyse worden getest op getrouwheid, stabiliteit, gedrag van gecorreleerde kenmerken en bruikbaarheid. Uitleg mag geen wijziging van leeftijd, handicap of een andere onveranderlijke eigenschap aanbevelen, en wordt niet gepresenteerd als causale effecten.
Het productiebeslissingsregister bewaart brongegevens, kenmerktransformatie, model, drempel, beleid en menselijke actie. Aanvragers kunnen onjuiste gegevens betwisten en een betekenisvolle beoordeling ontvangen. Monitoring controleert de uitkomst en de stabiliteit van de uitleg over groepen en modelupdates. Als een plausibele uitleg verandert onder een onschadelijke kenmerkperturbatie of een beslissende beleidsregel weglaten, wordt de uitrol gestopt. Uitlegbaarheid vult validatie en procedurele rechten aan; het excuseert geen ongeldige doelstelling, discriminerende uitkomsten of het ontbreken van verantwoordelijke menselijke autoriteit.
Implementatie‑bewijs en operationele gereedheid
Een productiebeslissing vereist meer dan een succesvolle demonstratie. Definieer de beoogde gebruikers, operationele omgeving, invoer, output, afhankelijkheden, eigenaar en de consequentie van elke belangrijke storing. Stel een reproduceerbare basislijn en een geversioneerde evaluatieset vast vóór afstemming. Test gewone gevallen, randvoorwaarden, misvormde of ontbrekende invoer, distributieverandering, uitval van afhankelijkheden, misbruik, en de groepen of omgevingen die waarschijnlijk onderbediend worden. Meet de taakkwaliteit samen met calibratie of onzekerheid, latency, doorvoersnelheid, resource‑kosten, toegankelijkheid, privacy en beveiliging. Leg elke transformatie en drempel vast zodat een onafhankelijke reviewer het resultaat kan reproduceren en bewijs kan onderscheiden van een aantrekkelijk prototype.
Voor de lancering moet autoriteit voor release, uitzonderingen, wijzigingen, rollback en pensionering worden toegewezen. Gebruik een gefaseerde uitrol, behoud een veilige fallback, en verifieer monitoring met opzettelijk geïnjecteerde storingen. Operationele telemetrie moet de kwaliteit van invoer, het gedrag van output, model‑ of regelversie, de gezondheid van afhankelijkheden, menselijke overrides en bevestigde uitkomsten onthullen zonder onnodige gevoelige gegevens te verzamelen. Definieer alarmdrempels en een verantwoordelijke voor de respons, en beoordeel vervolgens bewijsmateriaal uit de praktijk na implementatie in plaats van aan te nemen dat offline prestaties behouden blijven. Evalueer opnieuw wanneer gegevensbronnen, gebruikers, modellen, leveranciers, beleid, hardware of doelstellingen veranderen. Een onderhouden systeem heeft ook gedocumenteerde herstel‑, incident‑leer‑, verwijder‑ en retentieprocedures nodig, en een duidelijk punt waarop het moet worden uitgeschakeld of vervangen.
Veelgestelde vragen
Zijn aandachtkaarten uitleg?
Ze kunnen diagnostische signalen zijn, maar aandacht‑gewichten alleen garanderen niet dat ze de redenen voor de output van een model getrouw weergeven.
Vereist uitlegbare AI een eenvoudig model?
Niet altijd. Complexe modellen kunnen worden geanalyseerd met post‑hoc‑methoden, maar die uitleg vereist onafhankelijke validatie en duidelijk aangegeven grenzen.
Primaire referenties












