
AI-basisprincipes
Wat is mechanistische interpreteerbaarheid? Hoe onderzoekers AI-modellen analyseren

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Mechanistische interpreteerbaarheid bestudeert hoe geleerde componenten binnen een neuraal netwerk causaal gedrag produceren. In plaats van alleen inputs met outputs te correleren, formuleren onderzoekers hypothesen over features, aandachtshoofden, neuronen en circuits, en interveniëren ze om die hypothesen te testen.
Het vakgebied heeft gedetailleerde verklaringen geleverd voor geselecteerde gedragingen in kleine en middelgrote modellen, maar een volledige, getrouwe beschrijving van een frontier‑model blijft onbereikbaar. Geautomatiseerde verklaringen en aantrekkelijke visualisaties kunnen nuttige startpunten zijn, maar geen bewijs.
Belangrijkste conclusies
- Features zijn gerepresenteerde patronen; circuits zijn onderling verbonden componenten die een berekening zouden moeten uitvoeren.
- Activatie‑patching, ablatie en causale tracing testen of een component gedrag wijzigt.
- Superpositie betekent dat één neuron kan deelnemen aan veel features; sparse auto‑encoders proberen een andere feature‑basis.
- Interpretatiemethoden hebben grondwaarheid, falsificeerbare tests, dekking en evaluatie ten opzichte van alternatieve verklaringen nodig.
Van representatie naar mechanisme
Probing vraagt of informatie kan worden gedecodeerd uit een activatie. Attributie schat welke inputs of componenten belangrijk zijn. Mechanistisch werk gaat verder door een interne berekening voor te stellen en te controleren of interventies het verwachte tussen- en eindgedrag wijzigen.
Dit maakt het verwant aan, maar beperkter dan explainable AI. Een post‑hoc verklaring voor één beslissing is niet per se een teruggeïngineerd algoritme binnen het model.
Circuits en causale interventies
Onderzoekers kunnen een aandachtshoofd of feature die met een taak geassocieerd is identificeren, het afblaten, activaties van een andere run patchen, of traceren hoe informatie zich door lagen verplaatst. Een goede hypothese voorspelt gedrag op nieuwe voorbeelden en houdt stand onder controles.
Interventies kunnen off‑distribution toestanden creëren, waardoor een gedragsverandering niet automatisch de natuurlijke berekening onthult. Gebruik meerdere methoden, passende controles en kwantitatieve effecten in plaats van één illustratieve prompt.
Superpositie en sparse features
Neurale netwerken kunnen meer features representeren dan individuele dimensies door ze te superponeren. Een neuron kan daardoor activeren voor verschillende, niet‑gerelateerde patronen, waardoor labels op neuron‑niveau misleidend kunnen zijn.
Sparse auto‑encoders leren een grotere woordenlijst van features uit modelactivaties. Ze kunnen patronen beter scheidbaar maken, maar de gekozen sparsiteit, trainingsdata, reconstructiefout en geautomatiseerde labels beïnvloeden wat wordt teruggewonnen. Neural-network-features vereisen nog steeds causale validatie.
Veiligheid, debugging en beperkingen
Mechanistische tools kunnen helpen bij het vinden van gememoriseerde feiten, bias, misleidende strategieën of falende circuits en kunnen bewerken of monitoren ondersteunen. Dezelfde tools kunnen gedistribueerde, zeldzame of context‑afhankelijke berekeningen missen.
Beschouw bevindingen als afgebakend bewijs: modelversie, taak, dataset, laag, interventie, effect en onzekerheid. Koppel interpretatie aan gedrags‑evaluaties, red‑teaming en responsible‑AI-governance in plaats van het te gebruiken als een algemene veiligheidscertificaat.
Representaties, circuits en causaal bewijs
Mechanistische interpreteerbaarheid bestudeert hoe interne berekeningen modelgedrag produceren. Onderzoekers inspecteren activaties, gewichten, aandacht en tussenliggende features, en vormen vervolgens hypothesen over representaties en circuits. Een representatie hoeft niet in één neuron te worden opgeslagen; ze kan verspreid zijn over richtingen, lagen, tokens en context‑afhankelijke combinaties.
Sparse auto‑encoders proberen dichte activaties te ontleden in een grotere verzameling features die selectief activeren. Feature‑labels zijn menselijke interpretaties van waargenomen voorbeelden, geen grondwaarheid. Reconstructiefout, sparsiteit, feature‑splitsing, absorptie en dode features beïnvloeden wat de ontleding onthult en wat het mist.
Correlatie is onvoldoende voor een mechanistische bewering. Activatie‑patching, ablatie, causale tracing, steering en gerichte gewichtsinterventies testen of een component gedrag verandert zoals voorspeld. Interventies kunnen ook off‑distribution toestanden creëren, dus resultaten hebben controles, dose‑response‑analyse, alternatieve verklaringen en replicatie over prompts en modellen nodig.
Een rigoureuze interpreteerbaarheid‑workflow
Begin met een nauwkeurig gemeten gedrag en een dataset die concurrerende hypothesen scheidt. Lokaliseer relevante lagen, posities, componenten of features; inspecteer kandidaat‑mechanismen; interveneer; en test of het voorgestelde circuit nieuwe gevallen voorspelt. Houd exploratieve voorbeelden gescheiden van bevestigende evaluatie om selectiebias te verminderen.
Geautomatiseerde tools kunnen neuronen, features, heads of paden rangschikken, terwijl taalmodellen beschrijvingen kunnen voorstellen. Automatisering vergroot de dekking maar kan plausibele verhalen fabriceren. Beoordeel verklaringen op basis van gereserveerde activatie‑voorbeelden en causale voorspellingen, registreer onzekerheid, en maak artefacten reproduceerbaar met modelversie, tokenizer, prompts en code.
Mechanismen kunnen polysemantisch, redundant, niet‑lineair en verspreid zijn. Het verwijderen van één component kan door anderen worden gecompenseerd, terwijl een feature kan deelnemen aan verschillende gedragingen. Negatieve bevindingen zijn informatief: een schijnbaar circuit dat faalt buiten de samengestelde voorbeelden moet worden beperkt of verworpen in plaats van gered met een steeds vager verhaal.
Toepassingen, beperkingen en veiligheidsclaims
Interpreteerbaarheid kan helpen bij het debuggen van hallucinaties, bias, memorisatie, jailbreak‑gedrag of onverwachte generalisatie; modellen vergelijken; en wetenschappelijke hypothesen genereren. Het kan ook features identificeren voor monitoring of interventie. Deze toepassingen vereisen taak‑specifieke validatie omdat een nuttige onderzoeksvisualisatie niet automatisch een betrouwbare productie‑controle is.
Afwezigheid van een gedetecteerde feature bewijst niet de afwezigheid van een capaciteit of intentie, en een leesbare feature bewijst niet dat het model deze gebruikt in een bepaald antwoord. Tools observeren een projectie van berekening met beperkte dekking. Veiligheidsclaims moeten detectie‑gevoeligheid, false positives, distributie, tegenstander en bekende blinde vlekken specificeren.
Gebruik interpreteerbaarheid naast gedrags‑evaluaties, red‑teaming, datagovernance, toegangscontroles, monitoring en incident‑respons. Publiceer methoden en tegenvoorbeelden waar mogelijk. Het vakgebied ontwikkelt zich snel, maar huidige technieken leveren geen volledige, getrouwe verklaring van frontier‑modelredenering of een algemene garantie van alignment.
Voorbeeld in de praktijk: een voorgesteld modelcircuit testen
Stel dat een model een set aandachtshoofden en features lijkt te gebruiken om een indirect object in een zin op te lossen. Onderzoekers definiëren een gecontroleerde dataset met variërende namen, posities, afleiders en tegenvoorbeelden, en meten vervolgens het gedrag. Activatie‑inspectie identificeert kandidaat‑componenten, maar de hypothese wordt vóór interventie geschreven: welke informatie elke component draagt, waar deze naartoe beweegt, en hoe wijziging ervan de output moet veranderen.
Activatie‑patching en ablatie testen noodzaak en voldoendeheid over gereserveerde voorbeelden. Een gerichte bewerking die het voorspelde token in de verwachte richting wijzigt ondersteunt het mechanisme; brede prestatie‑schade niet. Controles patchen ongerelateerde posities en componenten, variëren de interventie‑grootte, en vergelijken alternatieve circuits. Het team publiceert negatieve gevallen waarin de verklaring faalt en vermijdt het toekennen van een menselijk leesbaar doel uitsluitend op basis van correlatie.
Om een veiligheids‑toepassing te claimen, moet de methode het relevante gedrag detecteren met bekende gevoeligheid onder realistische prompts en adversaire aanpassing. Feature‑monitoren worden geëvalueerd op false positives, omzeiling, modelupdates en causale relevantie. Interpreteerbaarheids‑evidence kan debugging en verdere tests sturen, maar handhaving blijft bij externe controles en gedragsmonitoring. Een overtuigend circuit‑diagram is een wetenschappelijke hypothese met bewijs — geen volledige verklaring van een model of een garantie over ongeziene gedragingen.
Praktische implementatie‑checklist
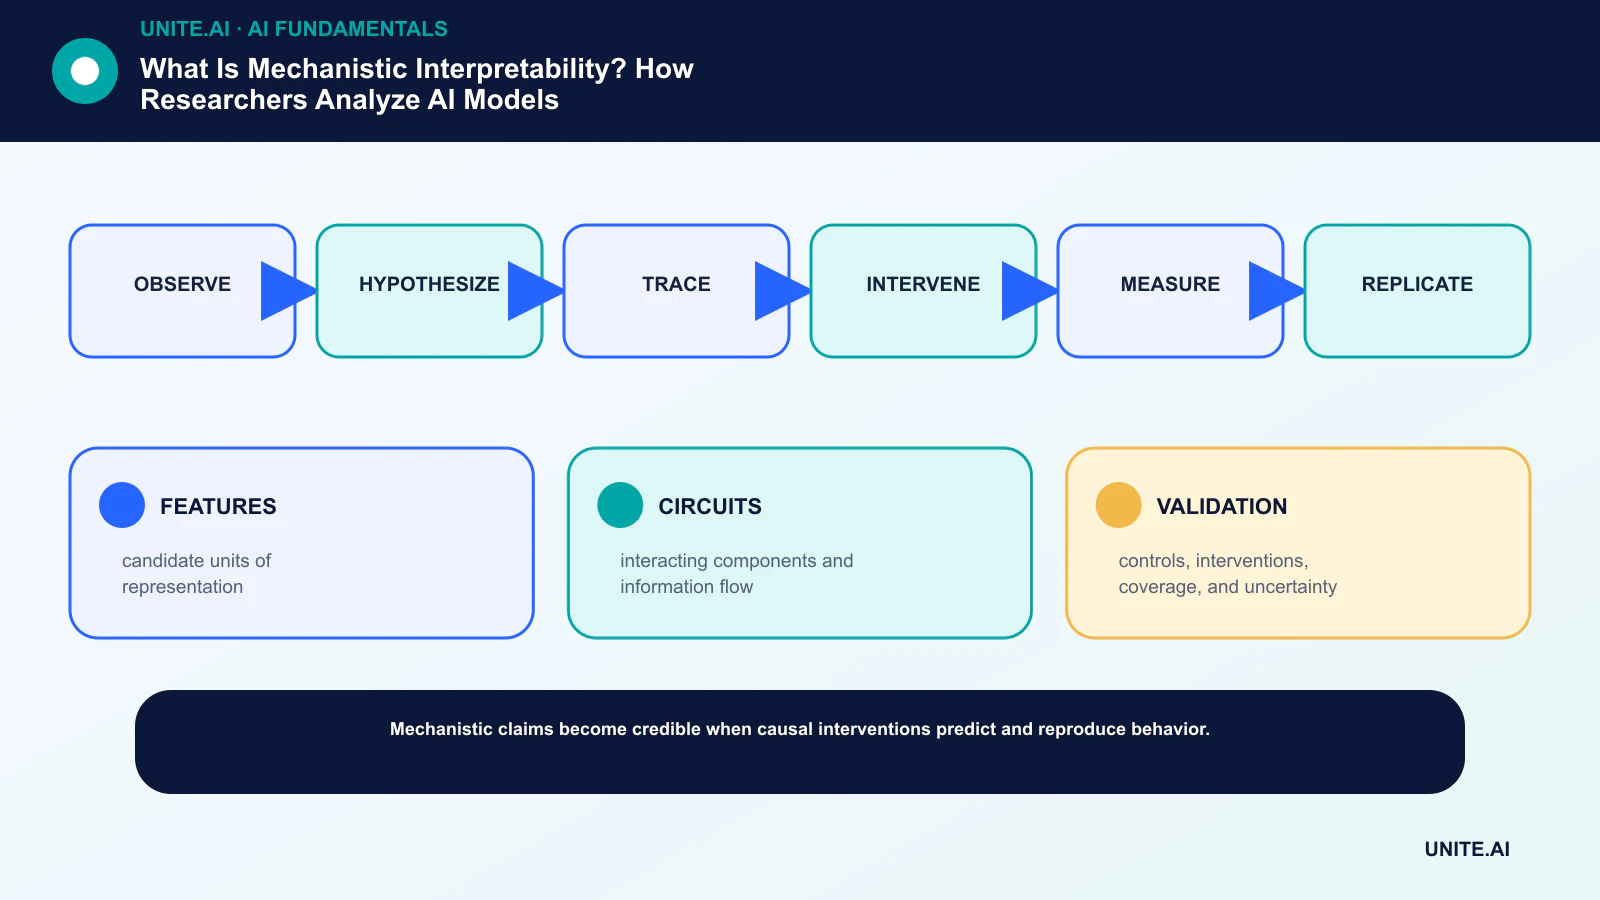
Zet het concept om in een begrensde, testbare workflow: observeren → hypothese vormen → traceren → interveniëren → meten → repliceren. Benoem een verantwoordelijke eigenaar, documenteer de data en afhankelijkheden, stel een eenvoudige basislijn vast, definieer acceptatie‑ en stopcriteria, test representatieve falen, en definieer monitoring, rollback en review voordat de scope wordt uitgebreid. Leg versies en aannames vast zodat een ander team het resultaat kan reproduceren en begrijpen wat er is veranderd.
Voor de lancering, voer een gedocumenteerde gereedheidsreview uit met de mensen die het systeem bouwen, exploiteren, beveiligen en erdoor worden beïnvloed. Test normale gevallen, randvoorwaarden, afhankelijkheids‑falen en misbruik; bewaar het bewijs en onopgeloste risico’s. Definieer wie de release mag goedkeuren, een drempel mag wijzigen, een output mag overschrijven of de werking mag stoppen. Herzie de beslissing nadat real‑world data binnenkomt, want een technisch geslaagde pilot garandeert geen betrouwbare prestaties op grotere schaal.
- FEATURES: kandidaat‑eenheden van representatie.
- CIRCUITS: onderling verbonden componenten en informatiestroom.
- VALIDATION: controles, interventies, dekking en onzekerheid.
Veelgestelde vragen
Is mechanistische interpreteerbaarheid hetzelfde als het lezen van modelgewichten?
Nee. Ruwe gewichten zijn niet vanzelfsprekend. Onderzoekers analyseren activaties, features, componenten en interventies om causale hypothesen te bouwen en te testen.
Kunnen sparse auto‑encoders een LLM volledig verklaren?
Nee. Ze bieden een kandidaat‑feature‑basis en kunnen circuitanalyse ondersteunen, maar dekking, getrouwheid, reconstructie, labeling en schaalbaarheid blijven open vraagstukken.
Primaire referenties












