
AI-basisprincipes
Wat is reinforcement learning?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Reinforcement learning (RL) is een machine‑learning‑kader waarin een agent leert hoe te handelen door te interageren met een omgeving. Na elke actie verandert de omgeving en kan een beloning teruggeven. Het doel van de agent is een beleid te leren dat de verwachte cumulatieve beloning maximaliseert, niet alleen de beloning van de volgende zet.
RL wordt gebruikt wanneer beslissingen zich over tijd ontvouwen en één actie invloed heeft op wat er daarna gebeurt. Het is conceptueel anders dan supervised learning, waarbij een dataset een doelantwoord levert voor elk trainingsvoorbeeld.
Belangrijkste punten
- Een RL‑probleem bevat een agent, een omgeving, toestanden, acties, beloningen en een beleid.
- Positieve en negatieve bekrachtiging verhogen beide gedrag; straf vermindert gedrag.
- De agent moet een balans vinden tussen het verkennen van onbekende acties en het exploiteren van al bekende werkende acties.
- Waarde‑gebaseerde, beleid‑gebaseerde, actor‑critic, model‑gebaseerde en offline methoden lossen verschillende RL‑omgevingen op.
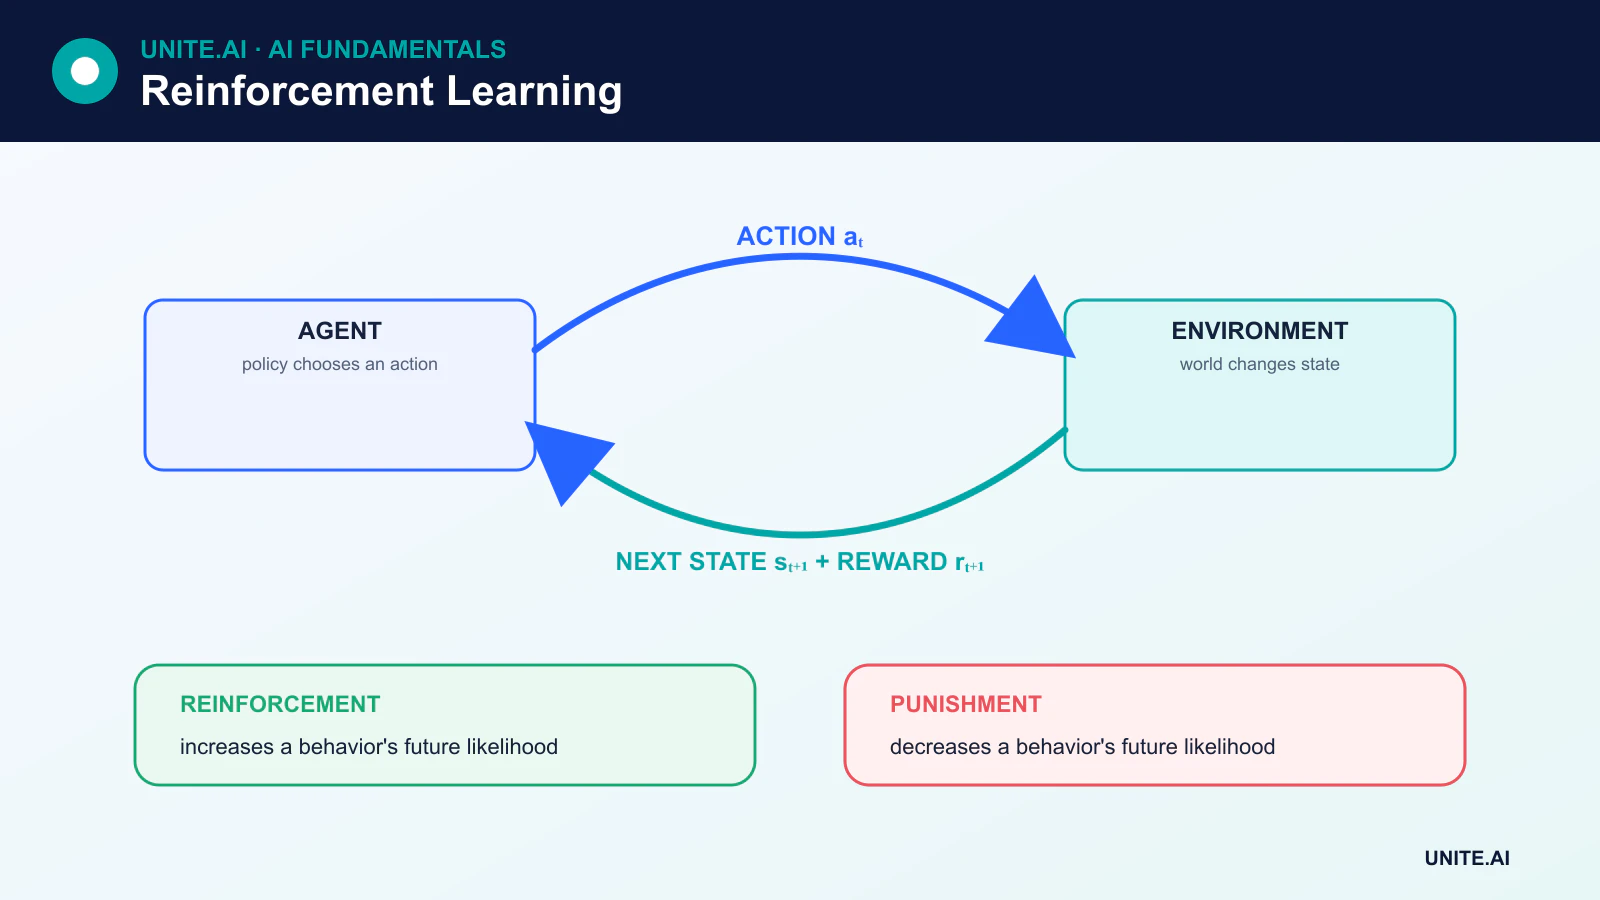
De componenten van reinforcement learning
Veel RL‑problemen worden gemodelleerd als een Markov decision process (MDP). Een MDP omvat:
- State: informatie die de huidige situatie beschrijft.
- Action: een keuze die beschikbaar is voor de agent.
- Transition: hoe de toestand verandert na een actie.
- Reward: onmiddellijke feedback die door een transitie wordt geproduceerd.
- Policy: de strategie van de agent om acties te selecteren.
- Discount factor: hoe sterk toekomstige beloningen meetellen ten opzichte van onmiddellijke beloningen.
Een toestand hoeft niet alles over de wereld bloot te leggen. Wanneer belangrijke informatie verborgen is, kan het probleem gedeeltelijk observeerbaar zijn en heeft de agent mogelijk een geheugen of geloofs‑toestand nodig.
Bekrachtiging is niet hetzelfde als straf
De terminologie komt uit de gedragspsychologie. Positive reinforcement voegt een consequentie toe die een gedrag waarschijnlijker maakt. Negative reinforcement verwijdert een onaangename voorwaarde en maakt een gedrag eveneens waarschijnlijker. Een straf die bedoeld is om een actie minder waarschijnlijk te maken, is straf, niet negatieve bekrachtiging.
In machine learning spreken beoefenaars vaker direct over positieve beloningen, negatieve beloningen, kosten en straffen. Het essentiële punt is hoe die signalen de opbrengst vormen die de agent probeert te maximaliseren.
Return, waarde en credit‑toewijzing
Een beloning beschrijft één transitie. De return combineert beloningen over tijd, meestal door beloningen die verder in de toekomst plaatsvinden te verdisconteren. Een state-value function schat de verwachte return vanuit een toestand, terwijl een action-value function de verwachte return schat na het nemen van een specifieke actie in die toestand.
Dit creëert het credit‑toewijzingsprobleem: als een nuttig resultaat veel later arriveert, welke eerdere acties verdienen dan credit? RL‑algoritmen verschillen in hoe ze deze relatie schatten.
Monte Carlo- en temporal‑difference‑leren
Monte Carlo methods leren van volledige gesamplede returns, doorgaans nadat een episode is beëindigd. Temporal-difference (TD) methods actualiseren een schatting vóór het uiteindelijke resultaat door de waargenomen beloning te combineren met een schatting van wat volgt. TD‑leren bootstrapt daardoor vanuit de huidige waardeschattingen.
Geen van beide families is universeel beter. Monte Carlo‑doelen zijn onbevooroordeeld onder het gesamplede beleid, maar kunnen een hoge variantie hebben en vereisen voltooiing van een episode. TD‑methoden kunnen online leren en van doorlopende taken, maar hun bootstrapped doelen introduceren bias.
Exploratie versus exploitatie
Exploration verzamelt informatie door acties te proberen waarvan de waarde onzeker is. Exploitation selecteert de actie waarvan men momenteel gelooft dat deze de beste return biedt. Een agent die nooit exploreert kan zich neerleggen op een slechte strategie; een agent die nooit exploiteert profiteert niet van wat hij geleerd heeft.
Eenvoudige strategieën omvatten epsilon‑greedy actieselectie, op vertrouwen gebaseerde exploratie, entropiebonussen en intrinsieke‑beloningsmethoden. In veiligheid‑kritische omgevingen kan onbeperkte exploratie onaanvaardbaar zijn, waardoor simulatie, beperkingen, offline data of menselijk toezicht belangrijk worden.
Belangrijkste reinforcement‑learning‑benaderingen
Value-based methods
Q‑learning en verwante algoritmen leren actiewaarden en leiden een beleid af door hoge‑waarde acties te selecteren. Deep reinforcement learning gebruikt neurale netwerken om waardefuncties of beleidsregels te benaderen wanneer de toestandsruimtes te groot zijn voor een tabel.
Policy-gradient methods
Policy‑gradient‑methoden passen direct een geparameteriseerd beleid aan om de verwachte return te verbeteren. Ze zijn nuttig voor continue acties en stochastische beleidsregels, maar kunnen gradient‑schattingen met hoge variantie hebben.
Actor-critic methods
Een actor kiest acties terwijl een critic waarde schat en een leersignaal levert. Dit combineert directe beleidsoptimalisatie met waardeschatting.
Model-based and model-free RL
Model‑based systemen leren of gebruiken een model van transities en beloningen zodat ze kunnen plannen. Model‑free systemen leren waardes of beleidsregels zonder expliciet de omgeving te modelleren. Model‑based methoden kunnen ervaring efficiënt benutten, maar fouten in het geleerde model kunnen de planning misleiden.
Offline reinforcement learning
Offline RL leert van een vaste dataset in plaats van tijdens het trainen nieuwe interacties te verzamelen. Het kan de kosten of risico’s van exploratie verminderen, maar de agent moet over‑schatting van acties die slecht in de data vertegenwoordigd zijn vermijden.
RLHF en menselijke voorkeuren
Reinforcement learning from human feedback (RLHF) gebruikt voorkeurgegevens om een beloningssignaal te trainen of direct een beleid te optimaliseren. Het is gebruikt om het gedrag van taalmodellen af te stemmen op menselijke oordelen. Voorkeuroptimalisatie biedt geen garantie op waarheid of veiligheid: resultaten hangen af van wie de feedback leverde, wat er beoordeeld werd en hoe het doel is ontworpen.
Beperkingen
RL kan enorme aantallen interacties vereisen, onstabiel gedrag vertonen tijdens training, en onbedoelde shortcuts in een beloningsfunctie exploiteren. Evaluatie is moeilijk omdat resultaten kunnen variëren met willekeurige seeds en omgevingsdetails. Goede praktijken omvatten meerdere runs, transparante baselines, begrensde doelstellingen, out‑of‑distribution testing en monitoring voor reward hacking.
Een RL‑probleem ontwerpen: toestand, actie, beloning en horizon
Reinforcement learning modelleert opeenvolgende beslissingen. De omgeving levert een observatie, de agent selecteert een actie volgens een beleid, en een transitie levert een beloning en de volgende observatie op. Een Markov decision process veronderstelt dat de toestand de informatie bevat die nodig is om toekomstige transities en beloningen te voorspellen; gedeeltelijke observeerbaarheid vereist geheugen, geloofstoestand of recursieve representaties. Discounting regelt het gewicht van uitgestelde uitkomsten, terwijl episodische en doorlopende taken verschillende return‑definities vereisen. Een slechte ontwerp van toestanden of acties kan een oplosbaar doel onleerbaar maken.
Beloningsontwerp specificeert gedrag indirect en is een belangrijke bron van falen. Een proxy kan worden uitgebuit: een agent die beloond wordt voor snelheid kan veiligheid negeren, terwijl een agent die alleen bij voltooiing van de taak wordt beloond te weinig leersignaal kan ontvangen. Voeg beperkingen en beëindigingsregels toe op basis van echte vereisten, test de gevoeligheid van de beloning en inspecteer trajecten op onbedoelde strategieën. Exploratiemethoden balanceren het verzamelen van informatie met het exploiteren van huidige kennis. Off‑policy data kan de steekproeffefficiëntie verbeteren, maar een mismatch tussen het gedrag en het doelbeleid vereist daarvoor ontworpen algoritmen.
Evaluatie, simulatie en veilige inzet
Waarde‑gebaseerde methoden schatten de verwachte return voor toestanden of acties; policy‑gradient‑methoden optimaliseren een geparameteriseerd beleid; actor‑critic‑methoden leren beide. Model‑based RL leert of gebruikt transitiiedynamiek om te plannen. De geschikte familie hangt af van het type actie, data, nauwkeurigheid van de simulator, horizon en stabiliteitseisen. Vergelijk met heuristische, supervised en control‑theorie baselines. Evalueer gemiddelde en worst‑case return, overtredingen van beperkingen, steekproeffefficiëntie, robuustheid tegen omgevingsveranderingen en variantie over seeds in plaats van een run met de beste leercurve te kiezen.
Online exploratie kan onaanvaardbaar zijn in de gezondheidszorg, financiën, robotica en infrastructuur. Train waar mogelijk in simulatie of met gelogde data, kwantificeer de kloof tussen simulator en realiteit, en gebruik off‑policy evaluatie zorgvuldig omdat ongeziene acties geen ondersteuning hebben. Inzet moet acties, frequentie, bronnen en operationeel gebied beperken; menselijke goedkeuring voor gevolg‑rijke keuzes omvatten; en een veilige controller of noodstop bieden. Monitor de beloning naast de feitelijke uitkomsten omdat een agent zijn score kan verbeteren terwijl hij het beoogde doel schaadt. Her‑valideer na veranderingen in omgeving, beleid of beloning.
Voorbeeld: energiebeheer met reinforcement learning
Een gebouwbeheerder modelleert temperatuur, bezetting, weer, toestandsstatus van apparatuur en elektriciteitsprijs, met acties beperkt tot veilige setpoint‑aanpassingen. De beloning combineert comfort, energie, vraag‑tarieven en apparatuur‑beperkingen, maar daadwerkelijke comfort‑schendingen worden apart geëvalueerd zodat beloningsoptimalisatie geen schade kan verbergen. Historische regeling en model‑predictive control bieden baselines. Training maakt gebruik van een gekalibreerde simulator met willekeurig weer, sensorruis en apparatuur‑efficiëntie.
Voordat de regeling invloed uitoefent op het gebouw, draait het beleid tegen live observaties zonder actie. Ingenieurs inspecteren trajecten, constraint‑marges en gedrag tijdens vakanties, hittegolven, storingen en ontbrekende sensoren. Inzet beperkt de actieratio en -reikwijdte en behoudt de bestaande veiligheidscontroller. Een mens kan op elk moment ingrijpen. Monitoring vergelijkt energie en comfort met overeenkomende periodes, registreert interventies en rolt terug als schendingen, onverwachte cycli of model‑mismatch de gedefinieerde drempels overschrijden.
Implementatie‑bewijs en operationele gereedheid
Een productie‑beslissing vereist meer dan een succesvolle demonstratie. Definieer de beoogde gebruikers, operationele omgeving, inputs, outputs, afhankelijkheden, eigenaar en de consequentie van elk belangrijk falen. Stel een reproduceerbare baseline en een versie‑gebaseerde evaluatieset vast vóór afstemming. Test gewone gevallen, randvoorwaarden, misvormde of ontbrekende input, distributieverandering, uitval van afhankelijkheden, misbruik, en de groepen of omgevingen die waarschijnlijk onderbediend worden. Meet taakkwaliteit samen met calibratie of onzekerheid, latency, doorvoersnelheid, resource‑kosten, toegankelijkheid, privacy en beveiliging. Leg elke transformatie en drempel vast zodat een onafhankelijke reviewer het resultaat kan reproduceren en bewijs kan onderscheiden van een aantrekkelijk prototype.
Voor de lancering moet autoriteit worden toegewezen voor release, uitzonderingen, wijzigingen, rollback en pensionering. Gebruik een gefaseerde uitrol, behoud een veilige fallback, en verifieer monitoring met opzettelijk geïnjecteerde storingen. Operationele telemetrie moet input‑kwaliteit, output‑gedrag, model‑ of regelversie, afhankelijkheidsstatus, menselijke overrides en bevestigde uitkomsten onthullen zonder onnodige gevoelige gegevens te verzamelen. Definieer alarm‑drempels en een verantwoordelijke voor de respons, en beoordeel vervolgens de real‑world‑evidence na inzet in plaats van aan te nemen dat offline prestaties behouden blijven. Her‑evalueer wanneer gegevensbronnen, gebruikers, modellen, leveranciers, beleidsregels, hardware of doelstellingen veranderen. Een onderhouden systeem heeft ook gedocumenteerd herstel, incident‑leren, verwijder‑ en retentieprocedures nodig, en een duidelijk punt waarop het moet worden uitgeschakeld of vervangen.
Primaire referenties












