AI-basisprincipes
Wat is backpropagation?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Backpropagation is het algoritme dat wordt gebruikt om te berekenen hoe de loss‑functie van een neuraal netwerk verandert ten opzichte van zijn trainbare parameters. Het past de kettingregel uit de calculus toe, achterwaarts door de bewerkingen die tijdens een voorwaartse pass zijn vastgelegd.
Backpropagation berekent gradiënten; het bepaalt op zichzelf niet de update. Een optimizer zoals stochastic gradient descent of AdamW gebruikt die gradiënten om gewichten, biaswaarden en andere trainbare parameters aan te passen.
Belangrijkste punten
- De voorwaartse pass bouwt tussenliggende waarden op en levert een voorspelling op.
- De verliesfunctie zet de voorspelling en het doel om in een scalair trainingsdoel.
- Backpropagation gebruikt lokale afgeleiden en de kettingregel om efficiënt parametergradiënten te berekenen.
- Moderne frameworks implementeren reverse-mode automatische differentiatie over een computationele graaf.
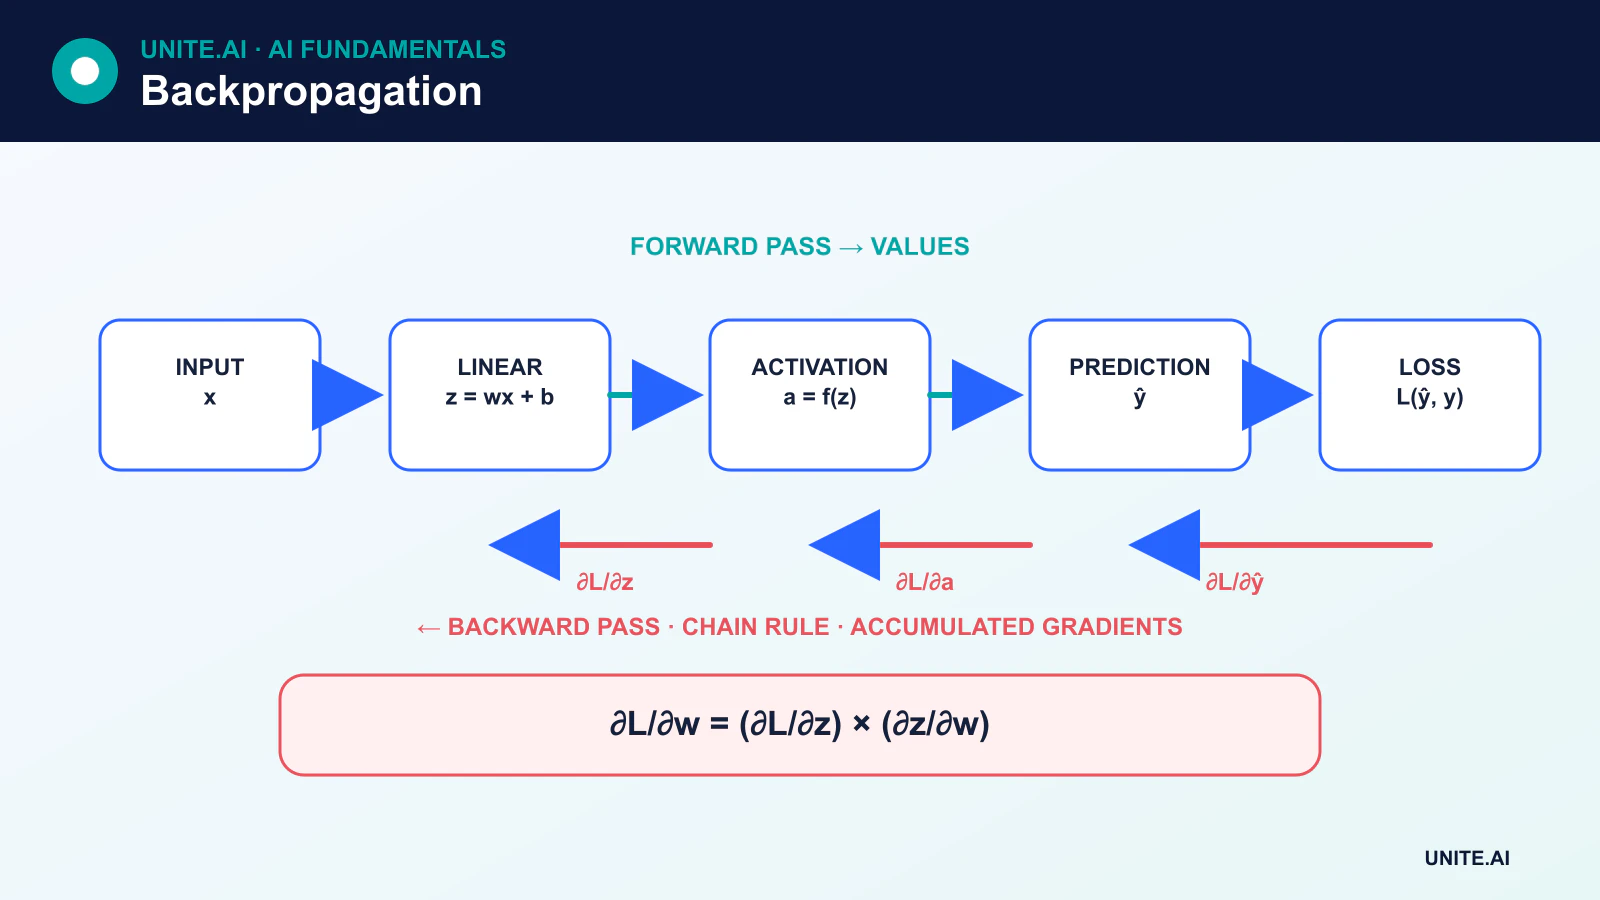
De voorwaartse pass
Beschouw een eenvoudige eenheid:
z = wx + bŷ = activation(z)
De invoer is x, terwijl w en b trainbare gewicht- en biasparameters zijn. Biases veranderen normaal tijdens het trainen net als gewichten. Een netwerk combineert veel van dergelijke bewerkingen, plus normalisatie, aandacht, convoluties, residuele verbindingen of andere differentieerbare blokken.
De voorwaartse pass evalueert die bewerkingen en levert een voorspelling op. Een verliesfunctie zoals cross-entropy of mean squared error meet het doel. De beste verliesfunctie hangt af van de taak en de interpretatie van de output.
De kettingregel
Als de loss L afhangt van een tussenwaarde z, en z afhangt van parameter w, geeft de kettingregel:
∂L/∂w = (∂L/∂z) × (∂z/∂w)
Een diep netwerk bevat veel paden. Backpropagation doorloopt de computationele graaf in omgekeerde richting, en verzamelt bijdragen wanneer een waarde de loss via meer dan één pad beïnvloedt. Het resultaat is een gradiënt voor elke trainbare parameter die heeft deelgenomen aan de voorwaartse berekening.
Een klein numeriek voorbeeld
Stel dat ŷ = wx + b, met x = 2, w = 3 en b = 1. De voorspelling is 7. Als het doel 5 is en de loss L = ½(ŷ - y)², dan:
∂L/∂ŷ = ŷ - y = 2∂ŷ/∂w = x = 2∂L/∂w = 2 × 2 = 4∂L/∂b = 2 × 1 = 2
De optimizer kan vervolgens w en b in de negatieve gradiëntrichting verplaatsen. Deze formule is specifiek voor de gekozen lineaire eenheid en de kwadratische foutloss; een universele backpropagation‑regel is de kettingregel over de daadwerkelijke graaf, niet één vaste “fout”-vergelijking.
Backpropagation versus gradient descent
Gradient descent is een optimalisatiemethode. Backpropagation levert de benodigde gradiënten. Een trainingsstap verloopt meestal als volgt:
- Wis of reset opgeslagen gradiënten.
- Voer de voorwaartse pass uit.
- Bereken de loss.
- Voer de achterwaartse pass uit.
- Pas de optimizer‑update toe.
Het scheiden van deze concepten maakt het makkelijker om momentum, AdamW, gradiëntaccumulatie en mixed‑precision training te begrijpen.
Automatische differentiatie
Frameworks zoals PyTorch registreren bewerkingen en bouwen een graaf tijdens de voorwaartse pass. Reverse-mode automatische differentiatie berekent vervolgens efficiënt vector‑Jacobiaanse producten van de outputs terug naar de parameters. Dit is algemener dan handmatig afgeleiden coderen voor een vast netwerk en vormt de basis van moderne deep learning-frameworks.
Sommige bewerkingen zijn niet‑differentieerbaar of hebben onstabiele afgeleiden. Frameworks definiëren subgradiënten of gedocumenteerde conventies in bepaalde gevallen, maar beoefenaars moeten nog steeds detached tensors, in‑place bewerkingen en numerieke precisie begrijpen.
Verdwijnende en exploderende gradiënten
Herhaalde vermenigvuldiging door vele lagen of tijdstappen kan gradiënten extreem klein of groot maken. Verdwijnde gradiënten vertragen het leren in eerdere lagen; exploderende gradiënten destabiliseren updates. ReLU‑familie‑activaties, zorgvuldige initialisatie, residuele verbindingen, normalisatie, gated recurrentie en gradient clipping helpen, maar geen is een universele oplossing.
Gradiënten controleren
Finite‑difference gradiëntcontrole vergelijkt een analytische of automatische gradiënt met een numerieke benadering. Het is traag maar nuttig voor het debuggen van aangepaste bewerkingen. Het monitoren van gradiëntnormen en het detecteren van NaN‑ of oneindige waarden kan instabiliteit tijdens het trainen aan het licht brengen.
De kettingregel door een computationele graaf
Backpropagation berekent efficiënt gradiënten van een scalair verlies ten opzichte van elke differentieerbare parameter. Een voorwaartse pass registreert tussenliggende waarden in een computationele graaf. Beginnend bij de loss past reverse‑mode automatische differentiatie de kettingregel toe, vermenigvuldigt lokale afgeleiden en verzamelt bijdragen waar paden samenkomen. Voor een laag y=f(x,w) combineert de upstream‑gevoeligheid voor y met partiële afgeleiden om gevoeligheden voor x en w te produceren. Backpropagation berekent gradiënten; de optimizer beslist hoe parameters veranderen.
Een eenvoudige affiene laag produceert y=Wx+b. De gradiënt voor W is het buitenproduct van de upstream‑gradiënt en de invoer, de gradiënt voor b somt upstream‑waarden op, en de invoer‑gradiënt vermenigvuldigt met de getransponeerde gewichtsmatrix. Activaties voegen element‑wise afgeleiden toe. Convolutie, normalisatie, aandacht en recursieve hergebruik volgen hetzelfde graaf‑principe maar vereisen correcte tensor‑vormen, broadcasting, masking en parameter‑deling. Frameworks vrijgeven opgeslagen activaties na de backward‑pass tenzij ze behouden blijven, waardoor het geheugen vaak groeit met batch‑grootte, diepte en sequentielengte.
Gradient‑fouten, verificatie en engineeringpraktijk
Producten van vele afgeleiden kunnen verdwijnen of exploderen. ReLU‑achtige activaties, zorgvuldige initialisatie, normalisatie, residuele verbindingen, gating en gradient clipping pakken verschillende mechanismen aan. Gesatureerde activaties en niet‑differentieerbare bewerkingen kunnen bruikbare signalen blokkeren; getrimde backpropagation beperkt de sequentie‑geschiedenis; mixed‑precision kan onder‑stroom komen zonder loss‑scaling. Exploderende gradiënten zijn een symptoom, dus clipping moet gepaard gaan met onderzoek naar learning‑rate, data, architectuur en numerieke fouten in plaats van ze te verbergen.
Verifieer aangepaste bewerkingen met finite‑difference gradiëntcontroles op kleine double‑precision invoer, vermijd niet‑differentieerbare punten. Inspecteer gradiëntnormen, NaN’s, inactieve parameters, en of gradiënten de verwachte modules bereiken. Wis opgehoopte gradiënten bewust en onderscheid trainings‑ van evaluatie‑gedrag voor dropout en normalisatie. Checkpointing herberekent activaties om geheugen te besparen; gedistribueerde training moet gradiënten consistent aggregeren. Een dalende trainings‑loss toont aan dat er een optimalisatiepad bestaat, niet dat gradiënten conceptueel correct zijn, data lekvrij is, of het model generaliseert.
Voorbeeld: verificatie van een aangepaste neurale laag
Een engineer implementeert een differentieerbare spectrale laag voor een audio‑netwerk. Een klein double‑precision‑test vergelijkt automatische gradiënten met centrale finite‑differences over invoer en parameters, met uitsluiting van punten waar de bewerking opzettelijk niet‑differentieerbaar is. Vorm, broadcasting, padding en complex‑naar‑reëel conversie krijgen afzonderlijke gevallen. De test verifieert opgehoopte gradiënten wanneer een parameter wordt hergebruikt en bevestigt dat gemaskeerde audio‑frames geen gradiënt produceren.
Tijdens training volgen dashboards gradiënt‑ en activatienormen, NaN’s, inactieve parameters en loss‑scaling. Een bewust beschadigde batch bevestigt dat validatie niet‑finite output opvangt vóór een optimizer‑update. Mixed‑precision en geëxporteerde implementaties worden vergeleken met de referentie. Checkpoint‑hervat‑tests omvatten optimizer‑state en willekeurige volgorde. De laag wordt niet geaccepteerd alleen omdat de totale loss daalt; eenheid‑gradiënten, numerieke stabiliteit en downstream‑generaliseerbaarheid moeten allemaal consistent bewijs leveren.
Bewijs van implementatie en operationele gereedheid
Een productie‑beslissing vereist meer dan een succesvolle demonstratie. Definieer de beoogde gebruikers, operationele omgeving, invoer, output, afhankelijkheden, eigenaar en de consequentie van elke belangrijke fout. Stel een reproduceerbare basislijn en een versie‑gebaseerde evaluatieset vast vóór afstemming. Test gewone gevallen, randvoorwaarden, misvormde of ontbrekende invoer, distributieverschuiving, uitval van afhankelijkheden, misbruik, en de groepen of omgevingen die het meest kans lopen onderbediend te worden. Meet taakkwaliteit samen met calibratie of onzekerheid, latentie, doorvoer, resource‑kosten, toegankelijkheid, privacy en beveiliging. Leg elke transformatie en drempel vast zodat een onafhankelijke reviewer het resultaat kan reproduceren en bewijs kan onderscheiden van een aantrekkelijk prototype.
Voor de lancering wijs autoriteit toe voor release, uitzonderingen, wijzigingen, rollback en pensionering. Gebruik een gefaseerde uitrol, behoud een veilige fallback, en verifieer monitoring met bewust geïnjecteerde fouten. Operationele telemetrie moet invoerkwaliteit, output‑gedrag, model‑ of regelversie, gezondheid van afhankelijkheden, menselijke overrides en bevestigde uitkomsten onthullen zonder onnodige gevoelige data te verzamelen. Definieer alarm‑drempels en een respons‑eigenaar, beoordeel vervolgens real‑world bewijs na implementatie in plaats van aan te nemen dat offline prestaties behouden blijven. Her‑evalueer telkens wanneer gegevensbronnen, gebruikers, modellen, leveranciers, beleid, hardware of doelstellingen veranderen. Een onderhouden systeem heeft ook gedocumenteerd herstel, incident‑leren, verwijder‑ en retentieprocedures nodig, en een duidelijk punt waarop het moet worden uitgeschakeld of vervangen.
Veelgestelde vragen
Verandert backpropagation de gewichten?
Backpropagation berekent gradiënten. De optimizer past een update toe met behulp van die gradiënten, zijn leersnelheid, en eventueel status zoals momentum of adaptieve momenten.
Is backpropagation biologisch realistisch?
Standaard backpropagation is een engineering‑algoritme en wordt niet geaccepteerd als een gedetailleerd model van leren in biologische hersenen. De historische neurale analogie mag niet worden behandeld als biologische equivalentie.
Primaire referenties