
AI-basisprincipes
Wat zijn RNN’s en LSTM’s in Deep Learning?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Recurrent neural networks (RNNs) verwerken sequenties door een verborgen toestand in de loop van de tijd bij te werken. Long short-term memory (LSTM)-netwerken zijn gegateerde RNN’s die zijn ontworpen om informatie effectiever te behouden en te beheersen dan een basale recursieve eenheid.
RNN’s en LSTM’s domineerden ooit veel taaltoepassingen, maar moderne grote chatbots zijn voornamelijk gebaseerd op transformers. Recursieve modellen blijven nuttig voor streaming, tijdreeksen, spraak, besturing en systemen met beperkte middelen waar incrementele toestand en lage latentie belangrijk zijn.
Belangrijkste punten
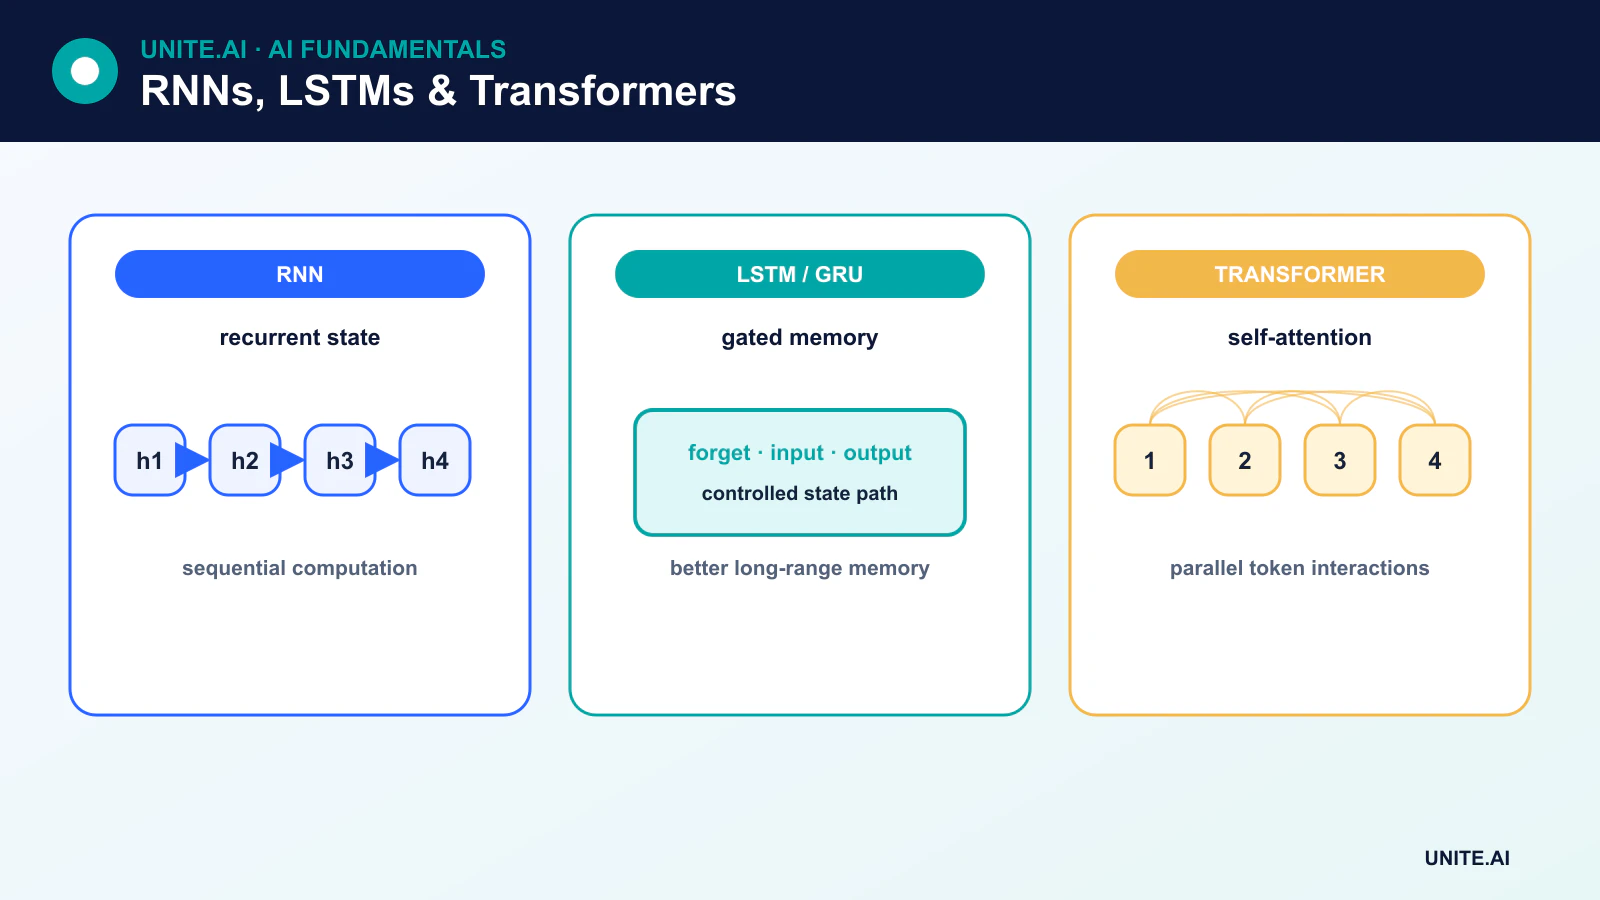
- Een RNN hergebruikt dezelfde parameters bij elke stap van de sequentie en draagt een verborgen toestand voort.
- Training door de tijd heen kan verdwijnende of exploderende gradiënten veroorzaken.
- Een LSTM voegt een celtoestand en invoer-, vergeet- en uitvoergaten toe.
- Transformers behandelen langafstandrelaties en parallelle training op een andere manier; geen van beide architecturen is voor elke implementatie de beste.
Hoe een eenvoudige RNN werkt
Bij stap t combineert een eenvoudige recursieve eenheid de huidige invoer xₜ met de vorige verborgen toestand hₜ₋₁:
hₜ = activation(Wₓxₜ + Wₕhₜ₋₁ + b)
De verborgen toestand is een geleerde samenvatting die wordt gebruikt voor de volgende stap en, afhankelijk van de taak, als output. Een “uitgerolde” diagram tekent één kopie per tijdstap, maar alle kopieën delen dezelfde parameters. De output wordt niet simpelweg teruggekopieerd als een nieuwe ruwe invoer; de recursie geeft de verborgen toestand door een gedefinieerde transformatie.
Backpropagation door de tijd
RNN’s worden getraind met backpropagation door de tijd (BPTT). De uitgerolde sequentie vormt een diep computationeel grafiek, en backpropagation berekent hoe de verliesfunctie afhankelijk is van gedeelde recursieve parameters.
Herhaalde vermenigvuldiging kan ervoor zorgen dat gradiënten naar nul krimpen of onbeperkt groeien. Verdwijnde gradiënten verhinderen het leren van lange afhankelijkheden; exploderende gradiënten veroorzaken onstabiele updates. Gradient clipping beperkt exploderende gradiënten, terwijl gating, initialisatie, normalisatie en kortere trainingsvensters kunnen helpen.
Binnen een LSTM-cel
Een LSTM behoudt een celtoestand cₜ naast de verborgen toestand hₜ. De gates zijn geleerde, data-afhankelijke controles:
- De forget gate bepaalt hoeveel van de vorige celtoestand wordt behouden.
- De input gate bepaalt hoeveel kandidaat‑informatie wordt geschreven.
- De output gate bepaalt hoeveel celinformatie bijdraagt aan de verborgen toestand.
Sigmoid‑uitgangen tussen nul en één fungeren als zachte gates, terwijl een tanh‑getransformeerde kandidaat nieuwe inhoud levert. Het additieve pad van de celtoestand helpt gradiënten te behouden, maar LSTM’s garanderen geen onbeperkt geheugen en elimineren niet alle optimalisatieproblemen.
GRU’s en bidirectionele recursie
Een gated recurrent unit (GRU) combineert gating‑mechanismen in een eenvoudigere recursieve cel zonder een aparte LSTM‑achtige celtoestand. GRU’s kunnen sneller trainen en presteren vergelijkbaar bij sommige taken.
Een bidirectionele RNN verwerkt een volledige sequentie in beide richtingen en combineert de toestanden. Het kan toekomstige context gebruiken voor tagging of codering, maar is ongeschikt voor causale streaming wanneer toekomstige invoer nog niet beschikbaar is.
Sequence-to-sequence-modellen
Encoder-decoder RNN’s koppelen de ene sequentie aan de andere. Aandacht (attention) werd geïntroduceerd om een decoder verschillende encoder‑toestanden te laten raadplegen in plaats van te vertrouwen op één vaste vector. Deze ontwikkeling leidde tot de transformer‑architectuur, die recursie verving door op aandacht gebaseerde blokken.
RNN’s versus transformers
Transformers verwerken trainingsposities parallel en creëren korte aandachtspaden tussen verre tokens. RNN’s verwerken de toestand sequentieel, wat parallelisme beperkt maar een constante‑grootte recursieve toestand tijdens streaming biedt. Transformer‑inferentie kan een groeiende sleutel‑waarde‑cache vereisen, terwijl een RNN de geschiedenis comprimeert in zijn verborgen toestand en details kan verliezen.
Kies op basis van sequentielengte, datavolume, hardware, latentie, geheugen en of de taak offline of streaming is. Hybride en state‑space‑architecturen bieden extra afwegingen.
Huidige toepassingsgevallen
RNN’s en LSTM’s blijven relevant voor voorspelling, anomaliedetectie, sensorgegevensverwerking, spraakcomponenten, handschrift, embedded besturing en low‑latency sequentiemodellering. Ze vormen niet de standaarduitleg voor huidige grote taalmodellen of AI‑chatbots.
Recursie, gates en sequentie‑geheugen
Een recurrent neuraal netwerk verwerkt een sequentie door de huidige invoer te combineren met een verborgen toestand die van eerdere stappen wordt meegenomen. Gedeelde gewichten maken variabele sequentielengtes mogelijk, en uitrollen maakt de berekening door de tijd heen zichtbaar voor training. Basis‑RNN’s kunnen temporele afhankelijkheid representeren, maar gradiënten die herhaaldelijk over lange sequenties worden vermenigvuldigd, neigen te verdwijnen of te exploderen. Afgekorte backpropagation beperkt geheugen en rekencapaciteit, terwijl gradient clipping extreme updates beheerst. De verborgen toestand is een geleerde samenvatting, geen getrouwe opslag van elk eerder token.
Long short-term memory‑netwerken voegen een celtoestand en invoer‑, vergeet‑ en uitvoergates toe die schrijven, behouden en blootleggen van informatie reguleren. Gated recurrent units gebruiken een eenvoudigere reset‑ en update‑structuur. Bidirectionele varianten gebruiken toekomstige context en kunnen daarom niet causaal streamen zonder vertraging. Gestapelde, residuele en met aandacht verrijkte recursieve modellen vergroten de capaciteit. Padding en masks moeten voorkomen dat kunstmatige sequentie‑elementen de toestand of verlies beïnvloeden, en de toestand moet worden gereset bij echte sequentie‑grenzen om lekken tussen voorbeelden te vermijden.
Training, vergelijking en stateful serving
RNN’s en LSTM’s blijven nuttig voor streaming, compacte on‑device modellen, tijdreeksen en workloads waarbij een sequentiële toestand efficiënt is. Transformers paralleliseren training en modelleren langafstandinteracties anders, maar kunnen meer geheugen en cache vereisen. Vergelijk architecturen op nauwkeurigheid, latentie, doorvoer, geheugen, energie en prestaties naarmate de sequentielengte verandert. Evalueer voorspelling met rollende tijdsplitsingen, taal met sequentie‑bewuste metrics, en anomaliedetectie met gebeurtenis‑niveau metingen. Inspecteer falen na lange onderbrekingen, regime‑veranderingen, ontbrekende monsters en abrupte sequentie‑grenzen.
Stateful implementatie moet de verborgen toestand koppelen aan de juiste sessie, deze laten verlopen, versleutelen indien gevoelig, en resetten na fouten of modelwijzigingen. Out‑of‑order of gedupliceerde gebeurtenissen kunnen de toestand corrumperen; voeg tijdstempels, sequentienummers en idempotentie toe. Monitor de leeftijd van de toestand, sequentielengte, ontbrekende waarden, output‑drift en latentie. Kwantisatie vereist gate‑gevoelige validatie omdat kleine numerieke wijzigingen zich in de loop van de tijd kunnen opstapelen. RNN‑geheugen maakt context mogelijk, maar kan ook privé‑ of verouderde informatie behouden, dus retentie‑ en gebruikerscontrole behoren tot het ontwerp.
Voorbeeld: een LSTM voor streaming sensor‑sequenties
Een toepassing gebruikt een LSTM om de kortetermijnbelasting te voorspellen op basis van recente metingen, kalender en weer. Sequenties worden opgebouwd met strikte tijdsvolgorde; de verborgen toestand wordt gereset bij voedersgrenzen, en padding wordt gemaskeerd. Seizoens‑naïeve en gradient‑boosted baselines worden vergeleken met de LSTM over rollende vensters. Tests omvatten ontbrekende intervallen, vertraagd weer, feestdagen, storingen en sequentielengtes die buiten de gebruikelijke training vallen.
De streaming‑service koppelt de toestand aan één feeder, wijst out‑of‑order duplicaten af en laat de toestand verlopen na lange onderbrekingen of modelupdates. Een veilige statistische voorspelling vervangt de output wanneer sensoren of de toestand ongeldig zijn. Kwantiseerde inferentie wordt gecontroleerd over lange sequenties op opgestapelde drift. Monitoring volgt de leeftijd van de toestand, ontbrekende waarden, latentie, bias en interval‑fout. Het model wordt alleen opnieuw getraind na netwijzigingen en beoordeelde resultaten tonen aan dat de geleerde temporele relaties niet langer generaliseren.
Implementatie‑bewijs en operationele gereedheid
Een productiebeslissing vereist meer dan een succesvolle demonstratie. Definieer de beoogde gebruikers, operationele omgeving, invoer, uitvoer, afhankelijkheden, eigenaar en de consequentie van elke belangrijke fout. Stel een reproduceerbare basislijn en een versie‑gebaseerde evaluatieset vast vóór afstemming. Test gewone gevallen, randvoorwaarden, misvormde of ontbrekende invoer, distributieverandering, afhankelijkheidsuitval, misbruik, en de groepen of omgevingen die waarschijnlijk onderbediend zijn. Meet taakkwaliteit samen met calibratie of onzekerheid, latentie, doorvoer, resource‑kosten, toegankelijkheid, privacy en beveiliging. Leg elke transformatie en drempel vast zodat een onafhankelijke reviewer het resultaat kan reproduceren en bewijs kan onderscheiden van een aantrekkelijk prototype.
Voor de lancering moet autoriteit worden toegewezen voor release, uitzonderingen, wijzigingen, rollback en pensionering. Gebruik een gefaseerde uitrol, behoud een veilige fallback, en verifieer monitoring met opzettelijk geïnjecteerde fouten. Operationele telemetrie moet de kwaliteit van invoer, gedrag van uitvoer, model‑ of regelversie, gezondheid van afhankelijkheden, menselijke overrides en bevestigde uitkomsten onthullen zonder onnodige gevoelige gegevens te verzamelen. Definieer alarmdrempels en een verantwoordelijke voor de respons, en beoordeel vervolgens bewijsmateriaal uit de praktijk na implementatie in plaats van aan te nemen dat offline prestaties aanhouden. Herzie telkens wanneer gegevensbronnen, gebruikers, modellen, leveranciers, beleid, hardware of doelstellingen veranderen. Een onderhouden systeem heeft ook gedocumenteerd herstel, incident‑leren, verwijder‑ en retentieprocedures, en een duidelijk punt waarop het moet worden uitgeschakeld of vervangen nodig.
Veelgestelde vragen
Is een LSTM altijd beter dan een eenvoudige RNN?
Nee. Gating helpt bij veel problemen met lange afhankelijkheden, maar voegt berekening en parameters toe. Een eenvoudige RNN kan voldoende zijn voor korte, eenvoudige sequenties, en een andere architectuur kan beter zijn voor zeer lange context.
Kan een LSTM een onbeperkte geschiedenis verwerken?
Nee. De toestand heeft een eindige capaciteit, gradiënten en trainingsdata leggen limieten op, en relevante details kunnen worden overschreven. De prestaties bij lange context moeten worden gemeten in plaats van afgeleid van de naam van de architectuur.
Primaire referenties












