
AI-basisprincipes
Hoe werkt tekstclassificatie?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Tekstclassificatie kent één of meer labels toe aan een document, bericht of tekstgedeelte. Voorbeelden zijn spamdetectie, intent‑routing, sentimentanalyse, onderwerp‑tagging, moderatie en prioritering van support‑tickets.
Een productie‑classifier is meer dan een model. Het hangt af van een nauwkeurige labeltaxonomie, representatieve annotaties, lekvrije splits, een gekalibreerde beslissingsregel en monitoring van veranderende taal en klasse‑prevalentie.
Belangrijkste conclusies
- Definieer labels en ambiguïteitsgevallen voordat een architectuur wordt gekozen.
- Eenvoudige bag‑of‑words‑baselines blijven waardevol; voorgetrainde encoders voegen context en transfer‑learning toe.
- Nauwkeurigheid kan een slechte prestatie van minderheidsklassen verbergen, dus gebruik klassen‑bewuste metriek en foutenanalyse.
- Probabiliteits‑kalibratie, onthouding en menselijke beoordeling maken scores tot veiligere beslissingen.
Definieer de taxonomie en annotatiebeleid
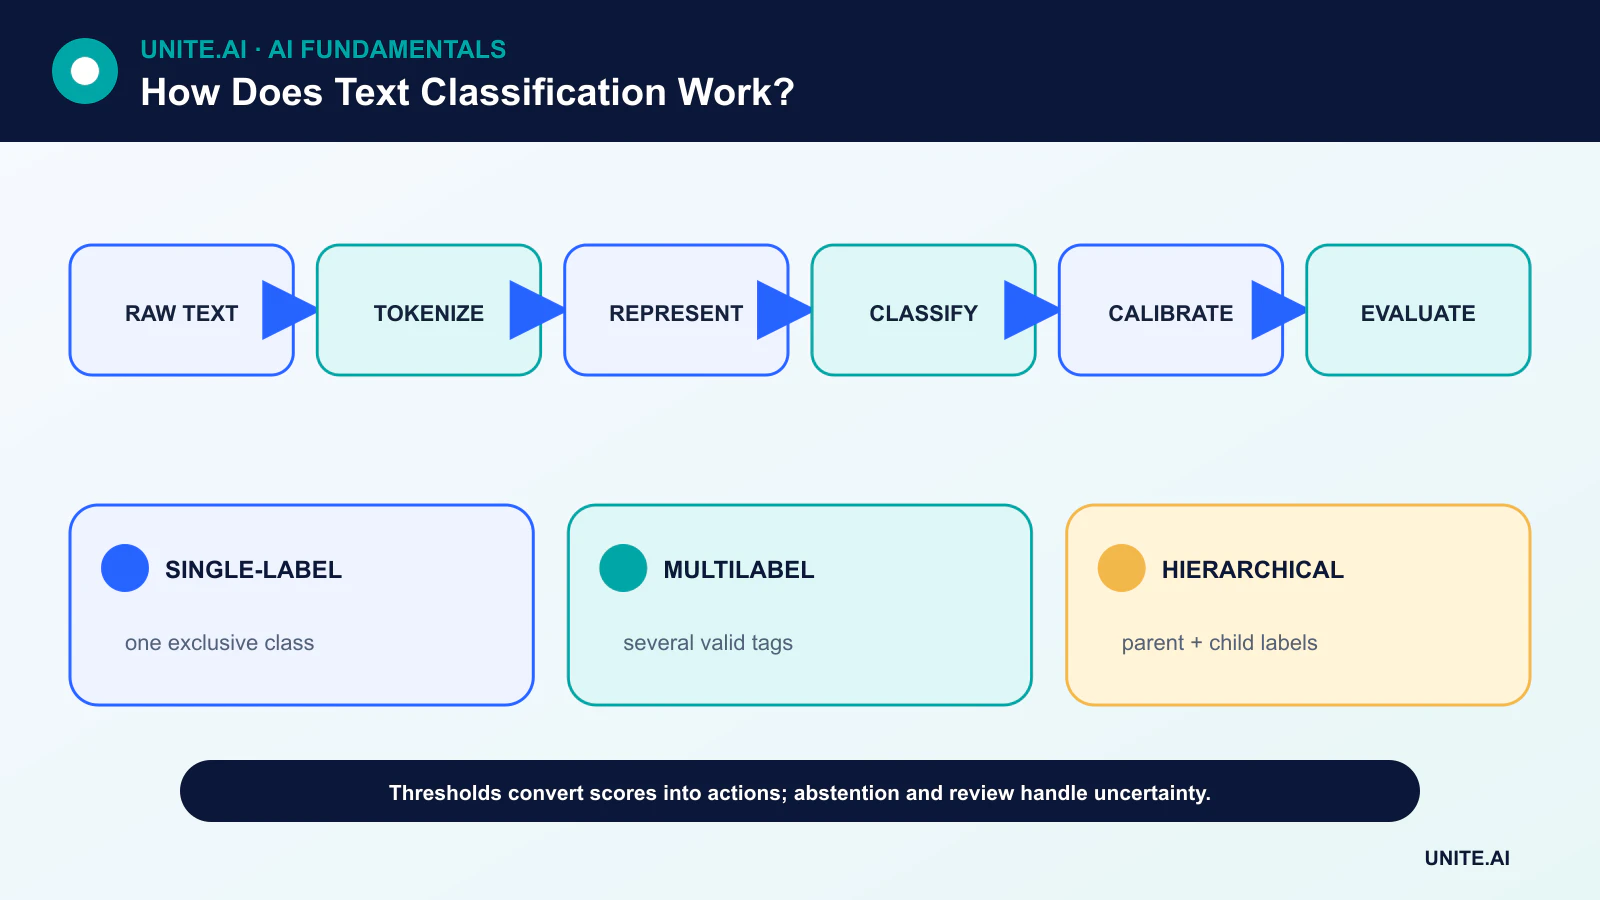
Een taak met één label kiest één onderling exclusieve klasse. Een multilabel‑taak kan meerdere onafhankelijke tags toewijzen. Hiërarchische taxonomieën bevatten boven‑ en onderliggende labels. Dit zijn verschillende leervraagstukken en vereisen verschillende outputs en metriek.
Annotators hebben definities, positieve en negatieve voorbeelden, regels voor ontbrekende context en een escalatieroute nodig. Overeenstemmingsstatistieken kunnen een onduidelijke taak blootleggen, maar onenigheid kan ook echte ambiguïteit weergeven die het systeem moet behouden.
Representatie van tekst
Traditionele pijplijnen gebruiken token‑telling, n‑grams en TF‑IDF met lineaire classifiers of support‑vector‑machines. Ze trainen snel, onthullen invloedrijke termen en bieden een sterke basislijn.
Neurale systemen mappen tokens naar embeddings. Voorgetrainde transformer‑encoders gebruiken attention om contextuele representaties te produceren en kunnen worden gefinetuned met gelabelde voorbeelden. Prompt‑ of zero‑shot‑classifiers kunnen de initiële labeling verminderen, maar hun labelformulering, modelversie en kalibratie moeten worden geëvalueerd op het specifieke domein.
Training zonder lekken
De dataset wordt gesplitst in trainings‑, validatie‑ en definitieve testdata. Bijna‑dubbele documenten, berichten uit dezelfde conversatie of sjablonen uit dezelfde bron moeten in dezelfde split blijven. Voor tijd‑afhankelijke toepassingen geeft een chronologische split een betere weergave van de inzet.
Klassen‑imbalance kan worden aangepakt via weging, hersampling, drempelkeuze of extra data. Synthetische voorbeelden mogen geen vervanging zijn voor de beoordeling van echte minderheids‑klas‑fouten en kunnen artefacten introduceren die het model te gemakkelijk leert.
Metrieken en gekalibreerde beslissingen
Een verwarringsmatrix toont welke labels met elkaar worden verward. Precisie meet hoeveel voorspelde positieven correct zijn; recall meet hoeveel ware positieven worden gevonden. Macro‑gemiddelden wegen klassen gelijk, terwijl micro‑gemiddelden individuele voorbeelden wegen.
Een ruwe softmax‑score is niet automatisch een betrouwbare waarschijnlijkheid. Kalibratie vergelijkt het vertrouwen met de waargenomen juistheid. Teams kunnen klassen‑specifieke drempels instellen, zich onthouden wanneer het vertrouwen laag is en gevoelige gevallen naar een reviewer doorsturen.
Implementatie, meertalige inzet en drift
Tekst verandert door producten, gebeurtenissen, slang en vijandig gedrag. Monitoring moet de invoertaal, lengte, out‑of‑vocabulary‑patronen, klasse‑percentages, vertrouwen en vertraagde uitkomsten bijhouden. Hertraining vereist versie‑beheer van data en een regressietestset met belangrijke voorbeelden.
Meertalige prestaties moeten per taal en dialect worden getest. Alles naar één taal vertalen kan sentiment of entiteiten wijzigen; een meertalige encoder kan nog steeds ongelijk presteren omdat de pre‑training en labels niet even representatief zijn.
Representaties en classifierfamilies
Tekstclassificatie brengt een document, zin of tokenreeks in kaart naar één of meer labels. Definieer of labels onderling exclusief, multilabel, hiërarchisch, geordend of open‑set zijn. Traditionele pijplijnen tokeniseren tekst, bouwen bag‑of‑words‑ of TF‑IDF‑features en trainen logistieke regressie, naïeve Bayes of een lineaire SVM. Neurale systemen leren embeddings via convolutie, recursie of transformers. Gepromptte taalmodellen kunnen classificeren zonder taak‑specifieke training, maar output‑beperkingen, kosten, drift en bewijs moeten nog worden geëvalueerd ten opzichte van eenvoudigere baselines.
Pre‑processing hangt af van de representatie. Alles naar kleine letters omzetten of interpunctie verwijderen kan signalen voor namen, sentiment, code of taal vernietigen; stemming kan verschillende betekenissen samenvoegen. Transformer‑tokenizers werken op subwoorden en hebben lengtelimieten, dus de afkappstrategie is belangrijk. Lange documenten kunnen chunking en aggregatie vereisen. Bewaar de ruwe tekst en transformatie‑versie, en split op auteur, conversatie, bron of tijd om bijna‑dubbele en terugkerende sjablonen te voorkomen dat ze van training naar test overlopen.
Labels, metriek en foutenanalyse
Een annotatie‑gids moet scope, voorbeelden, ambiguïteitsgevallen en een onbekende‑of‑onthoudingsoptie definiëren. Meet overeenstemming en adjudiceer onenigheid in plaats van deze te verbergen met een meerderheidsstem. Voor ongebalanceerde klassen is nauwkeurigheid ontoereikend; rapporteer precisie, recall, F1, verwarring, kalibratie en drempel‑specifieke werklast per klasse. Multilabel‑taken hebben micro‑, macro‑ en label‑niveau metriek nodig. Evalueer talen, dialecten, domeinen, berichtlengte en tijd. Een willekeurige split kan de kwaliteit overschatten wanneer vocabulaire of sjablonen driften.
Foutenanalyse moet representatiefouten, onvoldoende context, label‑ambiguïteit, zeldzame vocabulaire, negatie, sarcasme en valse aanwijzingen scheiden. Gebruik contrafactuele tests die namen, dialect‑markers of irrelevante metadata wijzigen terwijl de betekenis behouden blijft. Inspecteer fouten met hoog vertrouwen en afgewezen gevallen. Een model kan leren dat een klantkanaal of handtekening een label voorspelt in plaats van de inhoud te interpreteren. Verwijder lekken en reviseer data voordat je simpelweg de modelcapaciteit vergroot.
Productieontwerp
Bied een vaste tokenizer en model aan met schema‑validatie, lengtelimieten, batchverwerking en een fallback voor niet‑ondersteunde taal of laag vertrouwen. Monitor de invoer‑distributie, label‑percentages, kalibratie, latentie en beoordeelde uitkomsten. Bescherm tekst omdat deze persoonlijke, vertrouwelijke of vijandige instructies kan bevatten. Voor geautomatiseerde moderatie, geschiktheid of routing, zorg voor een beroepsmogelijkheid en meet ongelijke fouten. Versie‑beheer van labels en drempels volgens bedrijfsbeleid. Tekstclassificatie is alleen betrouwbaar binnen het gedefinieerde label‑systeem en de data‑distributie; vloeiende modeluitleg bewijst niet dat een classificatie correct is.
Praktijkvoorbeeld: inkomende ondersteuningsverzoeken classificeren
Een supportteam definieert onderling exclusieve routerings‑labels plus urgente, meertalige en onbekende vlaggen. Annotators labelen geanonimiseerde berichten met richtlijnen voor gemengde issues en meten overeenstemming. Een TF‑IDF‑logistieke basislijn, gefinetunede encoder en geprompt model gebruiken dezelfde tijd‑gebaseerde testset. Evaluatie rapporteert klasse‑precisie en recall, urgente false‑negatives, kalibratie, schema‑validiteit, latentie en kosten, waarbij bijna‑dubbele sjablonen worden gegroepeerd om lekken te voorkomen.
De uitgerolde classifier valideert taal en lengte, onthoudt zich bij zwak bewijs en laat agenten routes corrigeren. Prompts en berichten worden als onbetrouwbaar beschouwd; toegang tot tools ontbreekt. Monitoring volgt label‑prevalentie, vertrouwen, correcties, responstijd en opkomende onderwerpen. Een beleids‑ of productwijziging werkt de taxonomie en hertraining‑data bij via review. Het systeem verbetert de wachtrij‑plaatsing, maar het inferreert nooit klant‑emotie of -entitlement buiten de gevalideerde labels.
Bewijs van implementatie en operationele gereedheid
Een productie‑beslissing vereist meer dan een succesvolle demonstratie. Definieer de beoogde gebruikers, operationele omgeving, inputs, outputs, afhankelijkheden, eigenaar en de consequentie van elke belangrijke fout. Stel een reproduceerbare basislijn en een versie‑beheer evaluatieset vast vóór afstemming. Test gewone gevallen, randvoorwaarden, misvormde of ontbrekende invoer, distributie‑shift, afhankelijkheids‑uitval, misbruik en de groepen of omgevingen die waarschijnlijk onderbediend zijn. Meet taakkwaliteit samen met kalibratie of onzekerheid, latentie, doorvoersnelheid, resource‑kosten, toegankelijkheid, privacy en beveiliging. Leg elke transformatie en drempel vast zodat een onafhankelijke reviewer het resultaat kan reproduceren en bewijs kan scheiden van een aantrekkelijk prototype.
Voor de lancering moet autoriteit voor release, uitzonderingen, wijzigingen, rollback en pensionering worden toegewezen. Gebruik een gefaseerde uitrol, behoud een veilige fallback en verifieer monitoring met opzettelijk geïnjecteerde fouten. Operationele telemetrie moet invoer‑kwaliteit, output‑gedrag, model‑ of regelversie, afhankelijkheids‑gezondheid, menselijke overrides en bevestigde uitkomsten onthullen zonder onnodige gevoelige data te verzamelen. Definieer alarm‑drempels en een verantwoordelijke, en beoordeel vervolgens real‑world bewijs na de uitrol in plaats van aan te nemen dat offline prestaties aanhouden. Her‑evalueer telkens wanneer gegevensbronnen, gebruikers, modellen, leveranciers, beleid, hardware of doelstellingen veranderen. Een onderhouden systeem heeft ook gedocumenteerde herstel‑, incident‑leer‑, verwijder‑ en retentieprocedures nodig, en een duidelijk moment waarop het moet worden uitgeschakeld of vervangen.
Veelgestelde vragen
Is sentimentanalyse een tekstclassificatietaak?
Meestal ja, maar sentiment kan multilabel, aspect‑gebaseerd of continu zijn in plaats van één enkel positief/neutraal/negatief label.
Wanneer moet een tekstclassifier zich onthouden?
Wanneer het vertrouwen laag is, de tekst buiten de scope valt, de benodigde context ontbreekt of de kosten van een onjuiste automatische actie hoger zijn dan de kosten van review.
Primaire referenties












