
AI-basisprincipes
Wat is Conversational Speech Recognition (CSR)?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Conversational speech recognition (CSR) breidt automatische spraakherkenning uit voorbij geïsoleerde transcriptie door dialoogcontext, beurt‑nemingssignalen, sprekerinformatie en verwerking met lage latentie te gebruiken. Het doel is een live interactie te ondersteunen waarin woorden, timing, onderbrekingen en eerdere beurten allemaal van belang zijn.
CSR is een opkomend product‑ en onderzoekslabel, geen enkele gestandaardiseerde modelklasse. Een krachtig systeem combineert streaming‑ASR met endpoint‑detectie, sprekerafhandeling, contextueel taalmodelleren, dialoogstatus en een responsbeleid, en evalueert vervolgens de ervaring van begin tot eind.
Belangrijkste conclusies
- Streaming‑herkenning geeft voorlopige hypothesen uit en herziet deze naarmate meer audio binnenkomt.
- Endpoint‑detectie en beurtvoorspelling staan los van de transcriptienauwkeurigheid.
- Gespreksgeschiedenis en hotwords kunnen de herkenning verbeteren, maar ook eerdere fouten doorgeven.
- Evalueer latentie, onderbrekingen, sprekers, accenten, ruis, privacy en taakvoltooiing — niet alleen de woordfoutpercentage.
Van ASR naar live dialoog
Traditionele ASR zet audio om in tekst. Een conversatiesysteem moet bepalen wanneer het moet luisteren, wanneer een beurt voltooid is, of spraak gericht is aan het systeem, en hoe het moet herstellen wanneer zijn transcript of reactie fout is.
Streaming‑modellen verwerken frames incrementeel en leveren gedeeltelijke transcripties. Lage latentie verbetert de responsiviteit, maar voortijdige commitment kan revisies of fouten verhogen. De toepassing heeft een beleid nodig voor stabiele versus voorlopige tekst.
Beurtwisseling, overlapping en sprekers
Alleen de duur van stilte is een zwak endpoint‑signaal. Lexicale voltooiing, prosodie, timing, blik en dialoogstatus kunnen helpen voorspellen of iemand de beurt vasthoudt of opgeeft. Barge‑in stelt een gebruiker in staat om gesynthetiseerde spraak te onderbreken zonder de context te verliezen.
Overlappende stemmen en diarizatie blijven lastig. Systemen moeten sprekeronzekerheid behouden, voorkomen dat een uitspraak aan de verkeerde persoon wordt toegeschreven, en een correctiepad bieden — vooral voor dossiers die in de gezondheidszorg, financiën of juridische sector worden gebruikt.
Contextuele herkenning
Eerdere beurten kunnen namen en verwijzingen verduidelijken; hotword‑lijsten kunnen de herkenning sturen naar domeintermen. Spraak‑taalmodellen kunnen audio‑ en tekstcontext coderen in een gedeelde prompting‑ of attentie‑structuur.
Context kan ook een foutief eerder transcript versterken of informatie tussen sessies lekken. Beperk de geschiedenis tot het huidige doel, scheid vertrouwde metadata van gebruikersspraak, en gebruik transformer‑context met expliciete retentie‑ en toegangsregels.
Evaluatie en verantwoordelijke inzet
Rapporteer streaming‑woordfoutpercentage, latency van het eerste token en finalisatie, revisieratio, endpoint‑fouten, barge‑in‑succes, spreker‑toewijzing en taakvoltooiing. Test met echte microfoons, ruis, accenten, code‑switching, beperkingen en emotioneel beladen spraak.
Spraakgegevens kunnen gevoelige informatie identificeren of onthullen. Pas toestemming, minimalisatie, versleuteling, retentielimieten en menselijke beoordeling toe. Koppel gegenereerde antwoorden aan chatbot‑veiligheidscontroles, want een nauwkeurige transcriptie maakt een reactie niet per se correct of geautoriseerd.
Van akoestische invoer naar conversatiestatus
Een conversatiesysteem voor spraak legt audio vast, past signaalconditioning toe, detecteert spraak, herkent woorden of semantische eenheden, identificeert sprekers wanneer nodig, en werkt de dialoogstatus bij. Streaming‑systemen leveren gedeeltelijke hypothesen vóór het einde van een uiting. Deze hypothesen kunnen veranderen, dus downstream‑componenten moeten voorlopige van definitieve resultaten onderscheiden.
Spraakactiviteitsdetectie en endpoint‑detectie bepalen wanneer spraak begint en wanneer de gebruiker klaar is. Vaste stilte‑drempels falen bij trage sprekers, achtergrondgeluid en denkpauzes. Beurtwisselingsmodellen kunnen woorden, prosodie, blik en dialoogcontext gebruiken, maar moeten een snelle respons afwegen tegen het onderbreken van de spreker.
Diarizatie beantwoordt wie wanneer sprak; sprekerherkenning schat identiteit; bronseparatie isoleert overlappende stemmen. Dit zijn verschillende taken met verschillende risico’s. In vergaderingen, de gezondheidszorg en klantenservice kan het toewijzen van de juiste woorden aan de juiste persoon net zo belangrijk zijn als het woordfoutpercentage van het transcript.
Context, overlapping, emotie en interactieherstel
Conversatie‑context lost pronomen, ellipsen, correcties, domeintermen en verwijzingen naar eerdere beurten op. Een systeem kan akoestisch bewijs combineren met dialooggeschiedenis en opgehaalde kennis, maar eerdere context kan de herkenning ook sturen naar een onjuiste verwachting. Bewaar audio‑bewijs en vertrouwen zodat context niet stilzwijgend onzekerheid overschrijft.
Natuurlijke dialoog omvat backchannels, onderbrekingen, valse beginnen, lachen, code‑switching en gelijktijdige spraak. Een responsieve agent heeft barge‑in‑afhandeling nodig: stop of verlaag de output, vang de nieuwe spraak van de gebruiker op, bepaal of de onderbreking de intentie wijzigt, en herstel zonder een actie te dupliceren of te verliezen.
Prosodie en paralinguïstische signalen kunnen nadruk of onzekerheid aangeven, maar het afleiden van emotie, gezondheid of intentie uit stem is foutgevoelig en cultureel afhankelijk. Gebruik dergelijke schattingen terughoudend, maak ze waar nodig bekend, en neem geen belangrijke beslissingen op basis van een niet‑geverifieerd emotielabel.
Evaluatie, privacy en productiedesign
Woordfoutpercentage blijft nuttig, maar conversatie‑evaluatie moet ook spreker‑toewijzing, entiteitsnauwkeurigheid, semantisch taakresultaat, stabiliteit van gedeeltelijke hypothesen, endpoint‑latentie, onderbrekingssucces, herstel en gebruikers‑correctieratio meten. Segmenteer op accent, taal, apparaat, ruis, overlapping, spreekstijl en netwerkomstandigheden.
Streaming‑architectuur vereist begrensde buffers, back‑pressure, herverbinding, sequencenummers en expliciete finalisatie. Houd model‑ en dialoog‑latentiebudgetten gescheiden, traceer elke fase, en test verslechterde netwerken. Wanneer een systeem acties activeert, bevestig intenties met hoge impact en maak herpogingen idempotent zodat herhaalde audio of herverbindingen transacties niet dupliceren.
Spraak bevat identiteit, inhoud, omgeving en omstandersinformatie. Minimaliseer retentie, versleutel transport en opslag, beheer toegang, definieer verwijdering, en onderscheid audio van afgeleide transcripties en embeddings. Bied zichtbare opname‑indicatoren en alternatieven wanneer toestemming ontbreekt. Een lokaal model kan overdracht verminderen, maar vereist nog steeds toestemming en levenscyclus‑controles.
Voorbeeld: een spraakagent die onderbreking en correctie afhandelt
Een beller zegt: ‘Plan dinsdag—nee, woensdagmiddag,’ terwijl de agent begint te antwoorden na ‘dinsdag.’ Streaming‑herkenning geeft veranderende gedeeltelijke transcripties, endpoint‑detectie merkt voortgezette spraak op, en barge‑in stopt de output. De dialoogstatus markeert de eerdere datum als overbodig in plaats van twee verzoeken te creëren. Entiteit‑bevestiging richt zich op de gecorrigeerde datum en tijd, terwijl het systeem vertrouwen en bewijs voor de uiteindelijke interpretatie behoudt.
De architectuur scheidt audio‑captatie, spraakdetectie, streaming‑herkenning, sprekerafhandeling, dialoogbeleid, tool‑uitvoering en synthese. Sequencenummers en finalisatie voorkomen dat late gedeeltelijke resultaten het definitieve transcript overschrijven. De boekingstool accepteert een gestructureerd verzoek, controleert autorisatie en beschikbaarheid, en gebruikt een idempotentie‑sleutel. Een consequentiale boeking wordt teruggelezen en bevestigd vóór uitvoering; een herverbinding kan dit niet stilzwijgend herhalen.
Testen combineert woord‑ en entiteitsnauwkeurigheid met endpoint‑latentie, onderbrekingssucces, correctie‑afhandeling, spreker‑toewijzing, taakvoltooiing en duplicaat‑actieratio. Scenario’s omvatten ruis, overlapping, accenten, code‑switching, trage spraak, hulpmiddelen, zwakke netwerken en synthetische aanvallen. Audio‑retentie wordt geminimaliseerd en bekendgemaakt, omstandersdata wordt expliciet behandeld, en gebruikers kunnen overschakelen naar tekst of een mens. Conversatie‑intelligentie wordt gemeten aan de hand van veilig herstel en resultaat, niet alleen transcriptnauwkeurigheid.
Praktische implementatie‑checklist
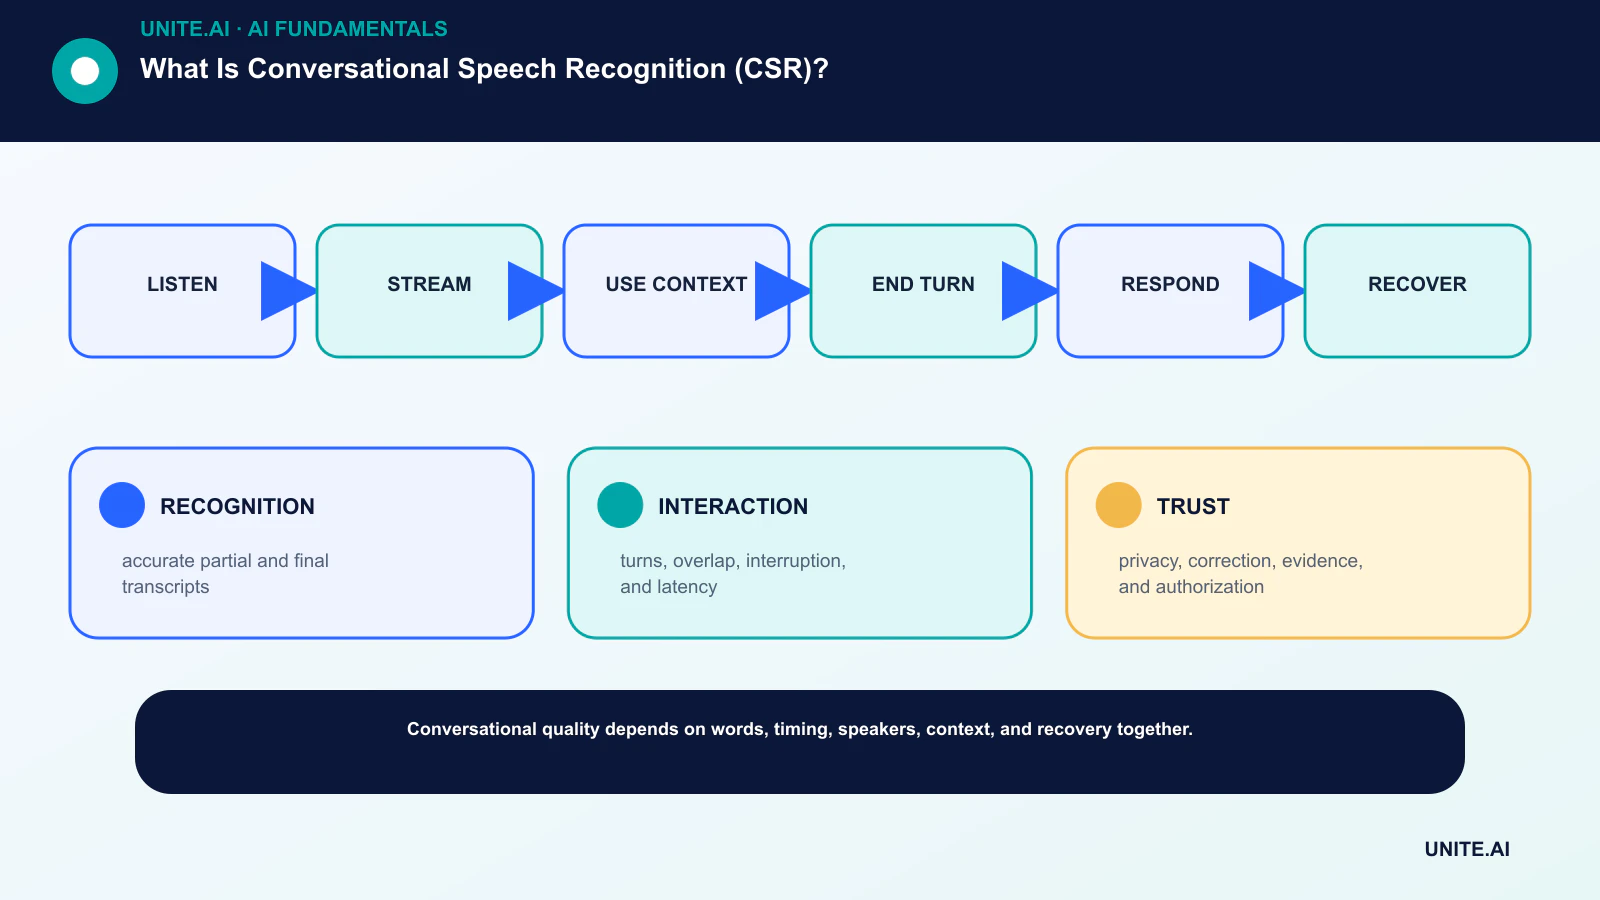
Zet het concept om in een begrensde, testbare workflow: luisteren → streamen → context gebruiken → beurt beëindigen → reageren → herstellen. Benoem een verantwoordelijke eigenaar, documenteer de gegevens en afhankelijkheden, stel een eenvoudige basislijn op, definieer acceptatie‑ en stopcriteria, test representatieve fouten, en bepaal monitoring, rollback en beoordeling voordat de reikwijdte wordt uitgebreid. Leg versies en aannames vast zodat een ander team het resultaat kan reproduceren en begrijpen wat er is veranderd.
Voor de lancering voer een gedocumenteerde gereedheids‑review uit met de mensen die het systeem bouwen, exploiteren, beveiligen en erdoor worden beïnvloed. Test normale gevallen, grensvoorwaarden, afhankelijkheidsfouten en misbruik; bewaar het bewijs en onopgeloste risico’s. Definieer wie de release mag goedkeuren, een drempel mag wijzigen, een output mag overschrijven of de werking kan stoppen. Herzie de beslissing zodra real‑world data beschikbaar is, want een technisch geslaagde pilot garandeert geen betrouwbare prestaties op grotere schaal.
- HERKENNING: nauwkeurige gedeeltelijke en definitieve transcripties.
- INTERACTIE: beurten, overlapping, onderbreking en latentie.
- VERTROUWEN: privacy, correctie, bewijs en autorisatie.
Veelgestelde vragen
Is CSR anders dan ASR?
ASR is de spraak‑naar‑tekst‑component. CSR gebruikt ASR plus dialoogcontext, timing, spreker‑ en endpoint‑afhandeling, en interactie‑beleid voor live conversaties.
Garandeert een lager woordfoutpercentage een betere spraakagent?
Nee. Een systeem kan nauwkeurig transcriberen maar toch gebruikers onderbreken, traag reageren, sprekers verkeerd toewijzen of de verkeerde actie ondernemen. End‑to‑end interactiemetrics zijn vereist.
Primaire referenties












