
AI-basisprincipes
Hoe bouw je een chatbot: Architectuur, gegevens, veiligheid en evaluatie

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Een chatbot is een applicatie die een bericht ontvangt, bepaalt wat de gebruiker nodig heeft, en een reactie terugstuurt via tekst of spraak. Moderne systemen kunnen regels, opvragen, classifiers, transformers, tools en grote taalmodellen combineren in plaats van op één model te vertrouwen.
Het bouwen van een bruikbare chatbot is daarom een product‑ en systeemprobleem. De dialooglaag moet verbinden met betrouwbare kennis en bedrijfsacties, terwijl identiteit, permissies, logging, evaluatie, fallback en menselijke escalatie bepalen wat de bot mag doen.
Belangrijkste punten
- Begin met een smalle gebruikerstask en een meetbaar succescriterium.
- Scheid taalgeneratie van opvragen, tools, permissies en bedrijfsregels.
- Test volledige gesprekken, inclusief ambiguïteit, onderbreking, weigering en herstel.
- Behandel prompts en modeluitvoer als onbetrouwbare data; monitor productie en behoud escalatieroutes.
Definieer de taak voordat je een model kiest
Noteer wie de gebruiker is, wat hij of zij probeert te bereiken, welke gegevens het systeem mag benaderen en welke acties bevestiging vereisen. Een veelgestelde‑vragen‑bot, een order‑statusassistent en een account‑beheerder hebben zeer verschillende risicoprofielen.
Creëer een niet‑AI‑baseline en een acceptatieset van representatieve gesprekken. Meet taakvoltooiing, antwoordondersteuning, latentie, afhaken, escalatie en de kosten van schadelijke fouten. Een vloeiende demo is geen bewijs dat de workflow betrouwbaar werkt.
Gebruik een gelaagde architectuur
Een typische pijplijn omvat een kanaaladapter, sessietoestand, invoervalidatie, intent‑ of routeringslogica, opvragen, een respons‑ of beleidsmodel, tool‑adapters en observability. Opvragen kan antwoorden verankeren in goedgekeurde documenten; tools voeren gecontroleerde acties uit via expliciete schema’s.
Houd deterministische controles buiten het taalmodel. Authenticatie, autorisatie, voorraadlimieten, terugbetalingen en onomkeerbare acties moeten worden afgedwongen door applicatiecode. Prompt engineering kan gedrag vormen, maar is geen toegangscontrolesysteem.
Ontwerp dialoog, kennis en herstel samen
Goede gesprekken gaan om onvolledige verzoeken, correcties, meerdere intenties en verwijzingen naar eerdere beurten. Sla alleen de context op die nodig is voor de taak, maak retentie zichtbaar en onderscheid een gebruikersstatement van een vertrouwd feit dat door een goedgekeurd systeem wordt geretourneerd.
Wanneer vertrouwen of bewijs onvoldoende is, moet de bot een gerichte vraag stellen, een veilig alternatief bieden of doorverwijzen naar een persoon met een beknopte samenvatting. Herstel is onderdeel van de kernervaring – geen randgeval dat pas na de lancering wordt toegevoegd.
Evalueer en beheer het volledige systeem
Test de kwaliteit van opvragen, tool‑selectie, argumentnauwkeurigheid, beleidsnaleving, weerstand tegen prompt‑injectie, privacy‑lekken en end‑to‑end resultaten. Voer red‑team‑adversariële invoer uit en verifieer dat een kwaadaardig document de systeem‑instructies niet stilletjes kan overschrijven.
Versie prompts, indexen, modellen, beleidsregels en tools. Beoordeel steekproefgesprekken met privacy‑controles, houd drift en foutclusters in de gaten en behoud rollback‑mogelijkheden. Deze operationele discipline verbindt chatbot‑ontwikkeling met AIOps en incidentrespons.
Kerncomponenten van een chatbot in meer detail
De kanaallaag normaliseert invoer van web‑chat, mobiele apps, berichtplatforms of spraak. Een sessielaag koppelt berichten aan een geauthenticeerd of anoniem gesprek, handhaaft expiratie en slaat alleen de staat op die nodig is voor de taak. Invoervelden beperken grootte en bestandstypen, detecteren onveilige payloads en verwijderen markup die downstream‑systemen niet mogen uitvoeren.
Een router beslist vervolgens of het verzoek behoort tot een deterministische flow, zoekopdracht, generatie of een menselijke wachtrij. Klassieke intent‑classifiers blijven nuttig wanneer de labelset stabiel is; taalmodellen zijn flexibeler maar moeilijker te kalibreren. Hybride routers kunnen gereguleerde of hoge‑volume taken reserveren voor geteste workflows en een algemeen model gebruiken voor open‑ended uitleg.
De responslaag moet bewijs en staat gescheiden dragen. Een gegenereerde zin kan een opgehaald fragment citeren, maar de applicatie moet behouden welke bron en versie het ondersteunde. Gespreksgeheugen moet gebruikersvoorkeuren onderscheiden van geverifieerde accountgegevens, en mag nooit toestaan dat een eerder gebruikersbericht nieuwe permissies verleent.
Opvragen, tools en transacties
De kwaliteit van opvragen begint vóór vector‑search. Documenten hebben eigenaarschap, toegangslabels, canonieke versies, bruikbare fragmenten en verwijderingsdatums nodig. Query‑rewriting, trefwoord‑search, embeddings, filters en reranking kunnen gecombineerd worden. Evaluatie moet meten of het benodigde bewijs werd opgehaald, of irrelevante passages werden uitgesloten en of het antwoord daadwerkelijk het bewijs volgt.
Tools vertalen een modelsuggestie naar een getypte aanvraag aan de applicatiecode. Elke tool heeft een smal doel, een expliciet schema, server‑side validatie, least‑privilege‑referenties, time‑outs, idempotentie waar mogelijk en een duidelijk resultaat. Het model mag geen ruwe database‑queries of willekeurige URL’s construeren wanneer een begrensde bedrijfsoperatie in plaats daarvan kan worden blootgesteld.
Transacties vereisen bevestiging op het moment van commitment. Toon de gebruiker de materiële velden – ontvanger, bedrag, adres, datum of toegangsverandering – en behandel een oud ‘ja’ niet als goedkeuring voor een nieuwe actie. Voor meer‑stapswerkzaamheden houd een state‑machine buiten het model zodat een retry of herordende boodschap een vereiste poort niet kan overslaan.
Een praktisch bouw‑ en evaluatieplan
Begin met twintig tot vijftig representatieve taken en neem onsuccesvolle, ambiguë en out‑of‑scope verzoeken op. Markeer de verwachte actie, bewijs, escalatie en verboden gedrag. Implementeer de eenvoudigste levensvatbare flow, voeg daarna opvragen of generatie alleen toe waar het een gemeten resultaat verbetert. Dit levert een herbruikbare regressiesuite op voordat de interface complex wordt.
Evalueer componenten en gesprekken afzonderlijk. Opvraag‑metrics, nauwkeurigheid van tool‑calls, beleidscontroles en respons‑ondersteuning diagnosticeren specifieke fouten; taakvoltooiing en gebruikersinspanning onthullen kwaliteit op systeemniveau. Gebruik multi‑turn tests die eerdere details corrigeren, een flow onderbreken, van onderwerp wisselen, vereiste informatie onthouden en afhankelijkheidsfouten triggeren.
Productierolout moet gefaseerd worden per gebruikersgroep, taak en permissie. Monitor niet‑ondersteunde claims, herhaalde verduidelijkingen, tool‑afwijzingen, escalaties, latentie en afhaken. Beoordeel privacy‑veilige monsters, onderhoud een nood‑disable‑pad voor elke tool, en gebruik incident‑bevindingen om prompts, data, code en de testset gezamenlijk bij te werken.
Voorbeeld in de praktijk: een ondersteunings‑chatbot van prototype tot productie
Stel je een retailer voor die een chatbot wil die vragen over bestellingen en retouren beantwoordt. Definieer eerst ondersteunde intenties, escalatie‑condities, goedgekeurde kennis, authenticatieregels en verboden acties. Bouw een testset uit geanonimiseerde historische vragen, inclusief vage verzoeken, spelfouten, meertalige invoer, boze gebruikers, prompt‑injectie en vragen zonder antwoord. Een opvraag‑baseline moet bewijs leveren voordat een generatief antwoord mag beweren beleid of orderstatus te kennen.
De runtime kan intentie classificeren, beleids‑passages ophalen, identiteitsverificatie aanvragen alleen wanneer accountgegevens nodig zijn, een nauwkeurig omschreven order‑API aanroepen, een antwoord samenstellen en citaten toevoegen. Elke tool‑call vereist een expliciet schema, autorisatie‑check, time‑out, retry‑policy en idempotentie‑sleutel. Het model mag nooit ruwe database‑queries construeren of eigen permissies bepalen. Acties met hoge impact, zoals annulering of terugbetalingen, vereisen bevestiging en, boven de gedefinieerde limieten, menselijke goedkeuring.
Evalueer intentienauwkeurigheid, antwoordcorrectheid, bewijsondersteuning, weigering‑kwaliteit, succesvolle containment, escalatie‑precisie, latentie en kosten per opgeloste conversatie. Beoordeel resultaten per intentie en gebruikersgroep in plaats van één gemiddelde. In productie log je consent‑bewuste traces, tool‑resultaten, opgehaalde documentversies en gebruikerscorrecties. Rol geleidelijk uit, vergelijk met het bestaande kanaal en schakel functionaliteit uit wanneer fouten, misbruik of afhankelijkheidsdrempels worden overschreden.
Praktische implementatie‑checklist
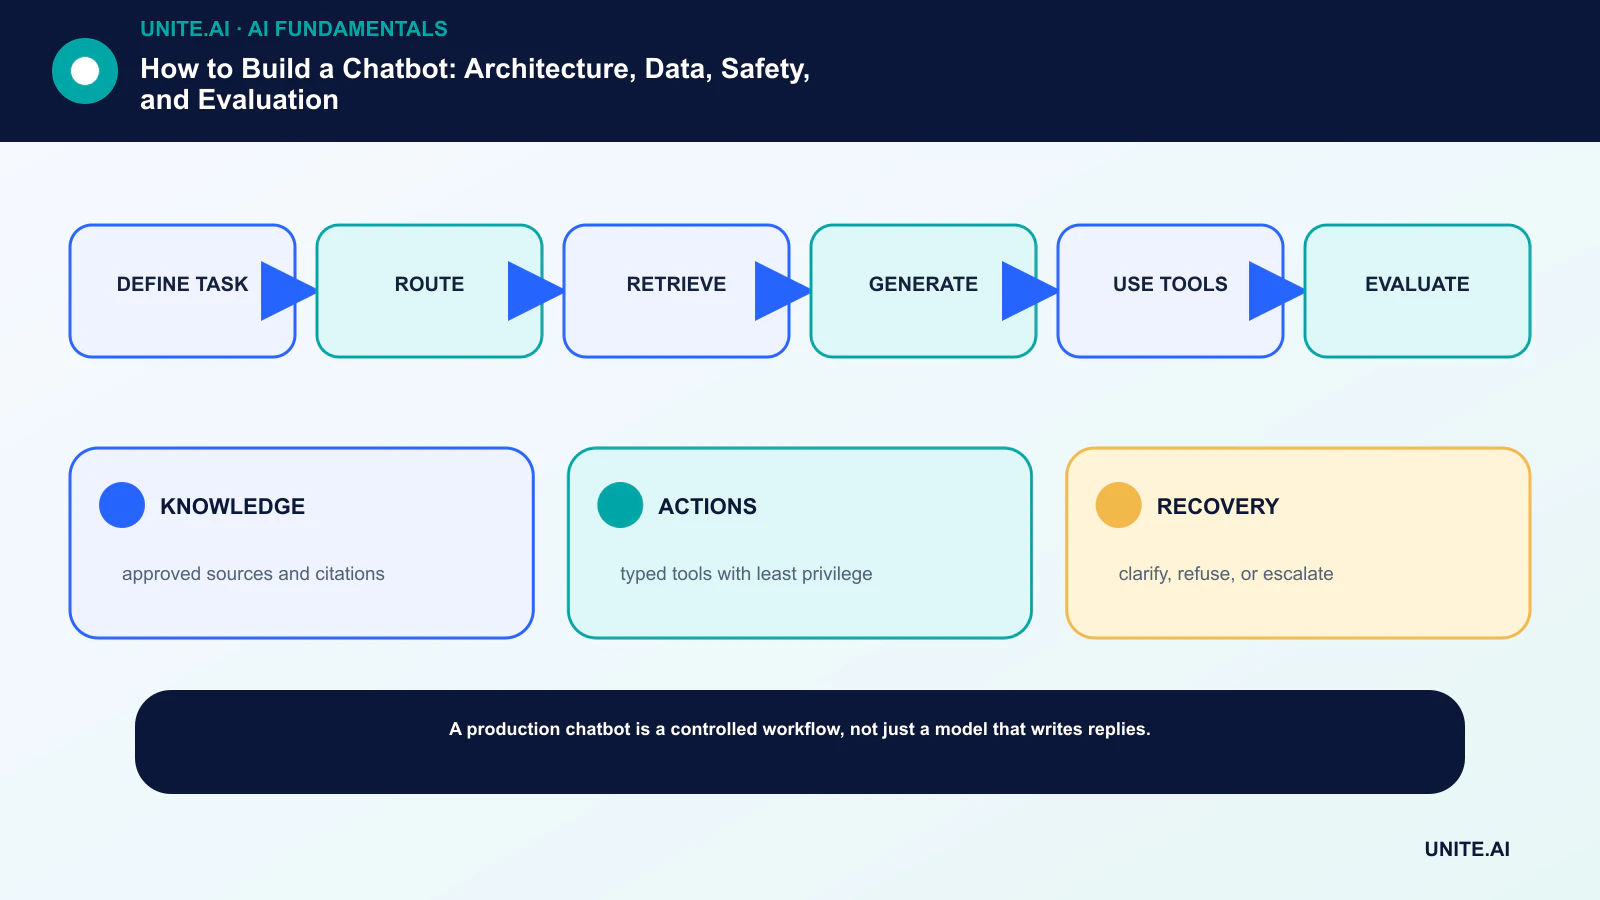
Transformeer het concept in een begrensde, testbare workflow: definieer taak → route → opvragen → genereren → tools gebruiken → evalueren. Benoem een verantwoordelijke eigenaar, documenteer de data en afhankelijkheden, stel een eenvoudige baseline vast, bepaal acceptatie‑ en stopcriteria, test representatieve fouten, en definieer monitoring, rollback en review vóór het uitbreiden van de scope. Leg versies en aannames vast zodat een ander team het resultaat kan reproduceren en begrijpen wat er is veranderd.
Voor de lancering voer je een gedocumenteerde gereedheidsreview uit met de mensen die bouwen, beheren, beveiligen en door het systeem worden beïnvloed. Test normale gevallen, grensvoorwaarden, afhankelijkheidsfouten en misbruik; bewaar het bewijs en onopgeloste risico’s. Definieer wie vrijgave kan goedkeuren, een drempel kan wijzigen, een output kan overschrijven of de werking kan stoppen. Herzie de beslissing na ontvangst van real‑world data, want een technisch geslaagde pilot garandeert geen betrouwbare prestatie op grotere schaal.
- KNOWLEDGE: goedgekeurde bronnen en citaten.
- ACTIONS: getypeerde tools met least privilege.
- RECOVERY: verduidelijken, weigeren of escaleren.
Veelgestelde vragen
Heeft een chatbot een groot taalmodel nodig?
Nee. Regels, zoekopdrachten, formulieren en kleine classifiers kunnen veiliger en goedkoper zijn voor smalle taken. Een LLM is nuttig wanneer flexibele taalbegrip of generatie meetbare waarde oplevert.
Wat moet er vóór de lancering worden getest?
Representatieve taken, niet‑ondersteunde verzoeken, ambiguë taal, tool‑fouten, privacy‑grenzen, adversariële prompts, menselijke overdracht, latentie en de nauwkeurigheid van elke gevolgde actie.
Primaire referenties












