
AI-basisprincipes
Wat is meta‑learning?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Meta-learning traint een systeem over een distributie van taken zodat het zich kan aanpassen aan een nieuwe, verwante taak met beperkte data of rekenkracht. Het wordt vaak samengevat als “leren te leren”, maar het technische doel is preciezer: de leerder optimaliseren zodat ervaring met eerdere taken de aanpassing aan een latere taak verbetert.
Meta-learning overlapt met few-shot learning en transfer learning, maar de termen zijn niet uitwisselbaar. Few-shot beschrijft de hoeveelheid doeldata; transfer beschrijft hergebruik; meta-learning maakt expliciet dat aanpassing over taken deel uitmaakt van de training.
Belangrijkste punten
- Meta-training gebruikt veel taken, niet alleen veel onafhankelijke voorbeelden.
- Een N-way K-shot‑episode bevat N klassen en K gelabelde ondersteuningsvoorbeelden per klasse.
- Gradient‑gebaseerde, metriek‑gebaseerde, geheugen‑gebaseerde en geleerde‑optimizer‑methoden passen zich op verschillende manieren aan.
- De prestaties hangen sterk af van of meta‑trainingstaken lijken op de doeltaak.
Taken, ondersteuningssets en query‑sets
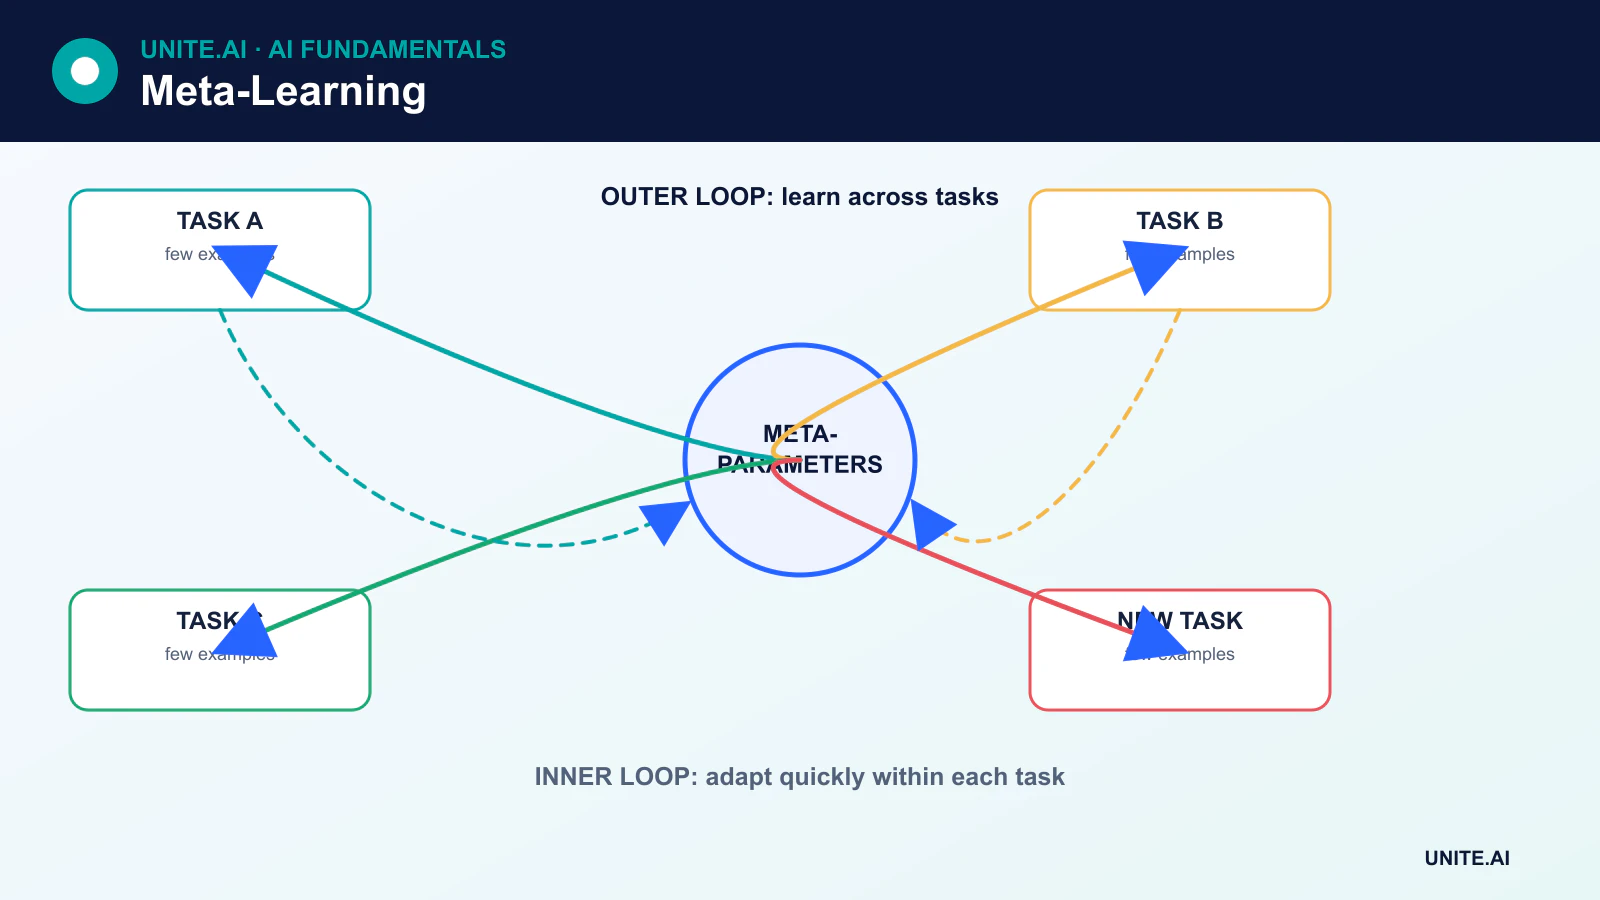
Een meta‑learning‑dataset is georganiseerd als taken. Bij few‑shot‑classificatie kan een episode 5-way 1-shot zijn: vijf klassen, één gelabeld ondersteuningsvoorbeeld per klasse, en extra query‑voorbeelden die worden gebruikt om de aanpassing te evalueren. Een 5-way 5-shot‑taak heeft vijf ondersteuningsvoorbeelden voor elk van de vijf klassen — niet vijf voorbeelden in totaal.
Tijdens meta‑training past de leerder zich herhaaldelijk aan op een ondersteuningsset en wordt geëvalueerd op een query‑set. Het buitenste doel verbetert de toekomstige query‑prestaties over taken heen. Meta‑validatie stemt keuzes af op afzonderlijke taken, en meta‑testing evalueert werkelijk ongeziene taken of klassen.
Gradient‑gebaseerd meta‑leren
Model‑Agnostic Meta‑Learning (MAML) leert een initialisatie waaruit een klein aantal gradient-stappen goede prestaties op een nieuwe taak opleveren. De inner‑loop past modelparameters aan met behulp van ondersteuningsdata. De outer‑loop werkt de gedeelde initialisatie bij met de query‑loss over gesamplede taken.
MAML is niet beperkt tot classificatie; het kan worden toegepast op regressie en reinforcement learning wanneer het model en de taak differentieerbaar zijn. Reptile biedt een eenvoudigere first‑order benadering die parameters richting taak‑aangepaste oplossingen verplaatst zonder de volledige MAML meta‑gradient te berekenen.
Metriek‑gebaseerd meta‑leren
Metriek‑gebaseerde methoden leren een embedding waarin voorbeelden van dezelfde klasse dicht bij elkaar liggen en verschillende klassen gescheiden zijn. Een prototypisch netwerk neemt het gemiddelde van ondersteunings‑embeddings om één prototype per klasse te vormen, en classificeert vervolgens queries op basis van de afstand tot die prototypes.
Matching‑ en Siamese‑achtige netwerken gebruiken verwante similariteitsmechanismen. Deze methoden controleren niet alleen of een model een ‘doel‑metriek’ raakt; de geleerde afstand of representatie maakt zelf deel uit van de voorspellingsprocedure.
Geheugen‑gebaseerde methoden en geleerde optimalisatoren
Geheugen‑gebaseerde systemen gebruiken recurrente of op aandacht gebaseerde toestanden om informatie over de huidige taak op te slaan. Geleerde optimalisatoren nemen gradients of trainingssignalen als invoer en leren hoe een ander model moet worden bijgewerkt. Deze methoden kunnen aanpassingsregels ontdekken, maar ze voegen parameters, rekenkracht en een extra niveau van potentieel overfitting toe.
Meta‑learning en in‑context leren
Grote transformers kunnen hun output aanpassen op basis van voorbeelden die in een prompt worden gegeven zonder de gewichten bij te werken. Dit wordt in‑context leren genoemd. Het lijkt op meta‑learning gedrag, en trainingsdata kunnen taak‑inference stimuleren, maar een in‑context leerder wordt niet automatisch getraind met een klassiek episodisch meta‑learning‑doel.
Waar meta‑learning nuttig is
Potentiële toepassingen omvatten personalisatie, robotica, herkenning met weinig bronnen, wetenschappelijke taken met weinig metingen, en snelle aanpassing aan nieuwe omgevingen. Meta‑learning is het aantrekkelijkst wanneer veel verwante bron‑taken beschikbaar zijn, maar data voor de doeltaak schaars is.
Beperkingen
Meta‑learning kan computationeel duur zijn omdat training adaptatie binnen optimalisatie nestelt. Resultaten zijn gevoelig voor taakconstructie, support‑/query‑lekkage, architectuur en domein‑shift. Een model dat is getraind op smalle, homogene taken kan slecht aanpassen buiten die distributie.
Vergelijkingen moeten gewone transfer‑learning en multitask‑baselines omvatten. Een sterke voorgetrainde representatie gevolgd door standaard fine‑tuning kan eenvoudiger en effectiever zijn dan een toegewijde meta‑learning‑algoritme.
Taken, adaptatie en de inner–outer optimalisatiestructuur
Meta‑learning traint over een distributie van taken zodat een leerder zich kan aanpassen aan een nieuwe taak met beperkte data of updates. Elke episode samplet een taak, verdeelt voorbeelden in een ondersteuningsset die wordt gebruikt voor adaptatie en een query‑set die wordt gebruikt voor evaluatie, en werkt gedeelde kennis bij over episodes. Metriek‑gebaseerde methoden leren een embedding en vergelijkingsregel; optimalisatie‑gebaseerde methoden leren initialisatie of update‑gedrag; geheugen‑ en model‑gebaseerde methoden conditioneren op taakvoorbeelden. De taak‑distributie is de echte trainingsdata en moet lijken op toekomstige adaptatieproblemen.
In model‑agnostic meta‑learning past een inner‑loop parameters aan op ondersteuningsvoorbeelden en optimaliseert een outer‑loop de prestaties op query‑voorbeelden na adaptatie. Higher‑order gradients kunnen duur zijn; first‑order benaderingen ruilen nauwkeurigheid in voor kosten. Prototypische netwerken representeren elke klasse door een centroid van de ondersteuningsset en classificeren op afstand. Deze methoden gaan ervan uit dat klasse‑geometrie, adaptatiestappen en episode‑constructie de inzet weerspiegelen. Een methode kan lijken snel te leren terwijl deze vaste labels, acquisitie‑artefacten of overlap tussen bron‑datasets exploiteert.
Evaluatie, baselines en beperkingen in de praktijk
Gebruik afzonderlijke trainings‑, validatie‑ en test‑taken — niet alleen voorbeelden — om adaptatie aan werkelijk ongeziene taken te meten. Rapporteer nauwkeurigheid of verlies als functie van shots en adaptatiestappen, betrouwbaarheidsintervallen over taken, rekenkracht, geheugen en gevoeligheid voor de samenstelling van de ondersteuningsset. Vergelijk met transfer‑learning, fine‑tuning van een voorgetraind model, nearest‑neighbors, en een model dat gezamenlijk op alle bron‑data is getraind. Veel schijnbare meta‑learning‑winsten krimpen wanneer baselines equivalente backbones, augmentatie en afstemming krijgen.
Echte implementaties hebben een manier nodig om te herkennen wanneer een nieuwe taak buiten de meta‑training‑distributie valt. Slechte of verkeerd gelabelde ondersteuningsvoorbeelden kunnen snelle, zelfverzekerde fouten veroorzaken. Beperk de magnitude van updates, valideer aangepaste modellen, behoud een fallback, en bescherm adaptatiedata tegen vergiftiging. Houd het basismodel, taak‑sampler, episode‑seeds en adaptatiecode bij. Meta‑learning is nuttig voor herhaalde families van klein‑dataproblemen, maar het creëert geen algemene leer‑capaciteit uit willekeurige voorbeelden en verwijdert niet de noodzaak voor domeinspecifieke evaluatie.
Voorbeeld: few‑shot adaptatie over machines
Een fabrikant beschouwt elk machinetype als een taak en meta‑traint een anomalie‑representatie over vele machines met geverifieerde onderhoudsresultaten. Testmachines worden volledig uitgesloten van taak‑training. Voor een nieuwe machine dekt een kleine ondersteuningsset normale bedrijfsmodi in plaats van willekeurige minuten data. Meta‑learning wordt vergeleken met een voorgetrainde bevroren encoder, nearest‑neighbors en gewone fine‑tuning met dezelfde ondersteuningsvoorbeelden en rekenkracht.
Evaluatie herhaalt vele ondersteuningsselecties en rapporteert event‑recall, false‑alarms, adaptatietijd en variantie. Het systeem onthoudt zich wanneer de sensorset of dynamiek van de nieuwe machine buiten de taak‑distributie valt. Adaptatie‑updates zijn begrensd en worden beoordeeld voordat ze onderhoud beïnvloeden. Ondersteuningslabels en machine‑identiteit worden beschermd tegen vergiftiging, en elk aangepast model behoudt zijn basisversie en voorbeelden. Snelle adaptatie wordt alleen geaccepteerd als deze consequent eenvoudigere transfer overtreft onder realistische taak‑shift.
Implementatie‑bewijs en operationele gereedheid
Een productie‑beslissing vereist meer dan een succesvolle demonstratie. Definieer de beoogde gebruikers, operationele omgeving, invoer, uitvoer, afhankelijkheden, eigenaar en de consequentie van elke belangrijke fout. Stel een reproduceerbare baseline en een versie‑gebaseerde evaluatieset vast vóór afstemming. Test gewone gevallen, randvoorwaarden, misvormde of ontbrekende invoer, distributie‑shift, afhankelijkheids‑uitval, misbruik, en de groepen of omgevingen die waarschijnlijk onderbediend zijn. Meet taak‑kwaliteit samen met calibratie of onzekerheid, latentie, doorvoersnelheid, resource‑kosten, toegankelijkheid, privacy en beveiliging. Leg elke transformatie en drempel vast zodat een onafhankelijke reviewer het resultaat kan reproduceren en bewijs kan onderscheiden van een aantrekkelijk prototype.
Voor de lancering moet autoriteit worden toegewezen voor release, uitzonderingen, wijzigingen, rollback en pensionering. Gebruik een gefaseerde uitrol, behoud een veilige fallback, en verifieer monitoring met opzettelijk geïnjecteerde fouten. Operationele telemetrie moet de invoer‑kwaliteit, uitvoer‑gedrag, model‑ of regelversie, afhankelijkheids‑gezondheid, menselijke overrides en bevestigde uitkomsten onthullen zonder onnodige gevoelige data te verzamelen. Definieer alarm‑drempels en een verantwoordelijke voor de respons, en beoordeel vervolgens bewijs uit de praktijk na implementatie in plaats van aan te nemen dat offline prestaties blijven bestaan. Evalueer opnieuw wanneer gegevensbronnen, gebruikers, modellen, leveranciers, beleid, hardware of doelstellingen veranderen. Een onderhouden systeem heeft ook gedocumenteerd herstel, incident‑leren, verwijder‑ en retentieprocedures nodig, en een duidelijk moment waarop het moet worden uitgeschakeld of vervangen.
Veelgestelde vragen
Is few‑shot prompting meta‑learning?
Few‑shot prompting is een in‑context adaptatietechniek. Het kan gedrag vertonen dat geassocieerd wordt met leren over taken, maar het wordt niet automatisch getraind met support‑/query‑episodes of een expliciete meta‑optimalisatielus.
Wat is het grootste risico van meta‑learning?
Een mismatch tussen meta‑trainingstaken en de doeltaak kan snelle adaptatie sterk laten lijken in een benchmark, maar falen in de praktijk. Taaksplitsingen en bron‑herkomst moeten net zo zorgvuldig worden geaudit als gewone train‑/test‑splitsingen.
Primaire referenties











