
AI-basisprincipes
Wat is een autoencoder?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Een autoencoder is een neuraal netwerk dat getraind is om zijn invoer te reconstrueren. Een encoder zet de invoer om in een latente representatie; een decoder zet die representatie terug om een reconstructie te maken. Training minimaliseert een reconstructieverlies, soms met extra beperkingen.
Het perfect kopiëren van de invoer is niet automatisch nuttig. De architectuur of het doel moet een knelpunt creëren, ruis toevoegen, sparsiteit opleggen of anderszins een triviale identiteitsmapping voorkomen, zodat de latente code nuttige structuur vastlegt.
Belangrijkste punten
- De encoder comprimeert of transformeert een invoer; de decoder reconstrueert deze vanuit een latente code.
- Een ondercomplete knelpunt, ruis of regularisatie moedigt het model aan om structuur te leren in plaats van te kopiëren.
- Reconstructiefout kan anomaliedetectie ondersteunen, maar anomalieën hebben niet gegarandeerd een hoge fout.
- Variationale autoencoders leren een probabilistisch latent model en verschillen van deterministische autoencoders.
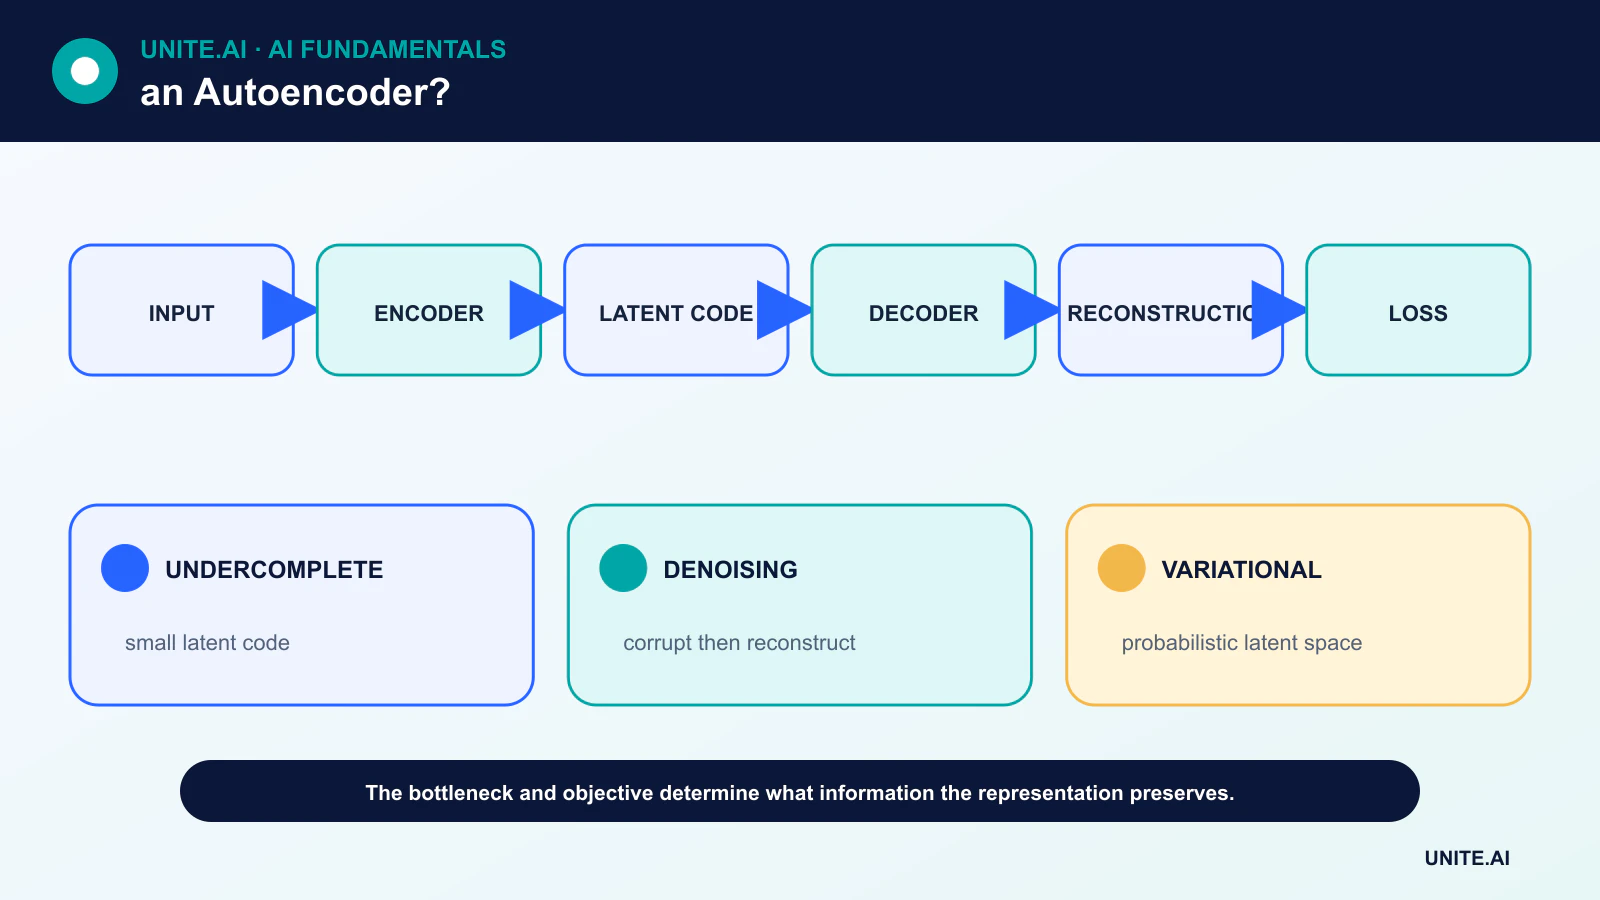
Encoder, latente ruimte en decoder
Voor invoer x produceert de encoder een latente code z = f(x) en de decoder een reconstructie x̂ = g(z). Het verlies vergelijkt x en x̂, bijvoorbeeld met de gemiddelde kwadratische fout voor continue waarden of een waarschijnlijkheid die geschikt is voor de data.
De latente dimensie kan kleiner zijn dan de invoer, waardoor een ondercomplete autoencoder ontstaat. Een diep netwerk kan ook niet‑lineaire representaties leren, waardoor het idee achter dimensionaliteitsreductie wordt uitgebreid.
Veelvoorkomende autoencoder-varianten
Een sparse autoencoder bestraft wijdverspreide activatie. Een denoising autoencoder ontvangt een beschadigde invoer en reconstrueert de schone versie. Een contractieve autoencoder bestraft de gevoeligheid van de code voor kleine invoerwijzigingen.
Een variationale autoencoder (VAE) codeert parameters van een waarschijnlijkheidsverdeling, neemt een latente waarde en balanceert reconstructie met een regularisatieterm die de latente ruimte vormgeeft. Dit ondersteunt sampling, maar verandert het doel en de interpretatie.
Training en het vermijden van triviale oplossingen
Autoencoders gebruiken backpropagation zoals andere neuraal netwerken. Een netwerk met te veel capaciteit kan trainingsvoorbeelden memoriseren of een bijna‑identiteitsfunctie leren. Knelpuntgrootte, corruptie, straffen en validatie op ongeziene data beperken dit.
De keuze van het verlies is belangrijk. Pixelgewijs verlies kan wazige afbeeldingsreconstructies opleveren, terwijl perceptuele verliezen aannames van een ander netwerk overnemen. De beste reconstructiemetric is niet per se de beste maat voor semantische gelijkenis.
Toepassingen en beperkingen
Autoencoders kunnen kenmerken leren, signalen ontgeluidden, data comprimeren, modellen initialiseren en latente variabelen voor visualisatie produceren. Voor anomaliedetectie kan een model dat getraind is op normale data een hogere reconstructiefout toewijzen aan ongebruikelijke invoer.
Die benadering kan falen wanneer de autoencoder anomalieën ook goed reconstrueert of wanneer onschadelijke variatie moeilijker te reconstrueren is dan de doelanomalie. Drempels hebben gelabelde of zorgvuldig beoordeelde validatiedata nodig, en de fout moet gemonitord worden per subgroep en operationele conditie.
Autoencoders versus andere generatieve modellen
Een deterministische autoencoder is niet automatisch een probabilistisch generatief model. VAE’s definiëren een gestructureerde latente verdeling; GAN’s trainen een generator tegen een discriminator; diffusiemodellen leren een denoising‑proces.
De keuze hangt af van of het doel reconstructie, representatie, waarschijnlijkheid, monsterfidelity, controleerbaarheid of anomaliescore is. Een kleiner taak‑specifiek model is vaak praktischer dan een grote afbeeldingsgenerator.
Encoder–decoder doelstellingen en latente representaties
Een autoencoder leert een encoder die invoer x naar een latente code z mappt en een decoder die x vanuit z reconstrueert. Als capaciteit onbeperkt is, kan hij een identiteitsmapping leren met weinig nuttige structuur. Knelpunten, regularisatie, corruptie, sparsiteit of architecturale beperkingen dwingen een representatie die geselecteerde informatie behoudt. Het reconstructieverlies definieert wat als gelijk wordt beschouwd: mean squared error bevoordeelt gemiddelde pixel‑fideliteit, terwijl perceptuele of modaliteit‑specifieke verliezen verschillende kenmerken benadrukken. Een lage verlieswaarde garandeert geen semantische betekenis.
Ondercomplete autoencoders beperken de latente dimensie. Denoising autoencoders reconstrueren schone data vanuit beschadigde invoer. Sparse varianten bestraffen activatie; contractieve varianten bestraffen gevoeligheid. Variationale autoencoders leren een probabilistische latente verdeling door reconstructie te combineren met een divergenterme, waardoor sampling mogelijk wordt maar het doel verandert. Convolutionele, sequentiële, graf‑ en transformer‑autoencoders coderen de modaliteitsstructuur. Kies de latente grootte en regularisatie via downstream validatie, niet alleen op aantrekkelijke tweedimensionale plotten.
Anomaliedetectie, compressie en evaluatie
Voor anomaliedetectie train je op representatieve normale data en beoordeel je de reconstructiefout of latente waarschijnlijkheid, maar anomalieën kunnen soms goed gereconstrueerd worden en zeldzame normale gevallen slecht. Selecteer drempels op gelabelde of beoordeelde validatiegevallen, rapporteer recall op gebeurtenisniveau en valse alarmen, en test veranderingen in operationele toestand. Vergelijk met eenvoudige statistische en één‑klasse baselines. Voor compressie tel je de volledige codec — inclusief modelgrootte, kwantisatie, metadata en decodeercomputatie — en vergelijk je de kwaliteit bij gelijkwaardige bitrate met gevestigde codecs.
Representatiekwaliteit kan geëvalueerd worden via lineaire probes, clusteringstabiliteit, retrieval, reconstructie en downstream taken, elk beantwoordend een andere vraag. Vermijd lekken bij het leren van de encoder en het selecteren van drempels. Inspecteer welke kenmerken het verlies negeert en of gevoelige attributen gecodeerd blijven. Een gecomprimeerde latente is niet automatisch geanonimiseerd; inversie en attribuutinfernce kunnen privé‑informatie herstellen. Gegenereerde reconstructies kunnen plausibel lijken terwijl kritieke details worden gewijzigd.
Implementatie en monitoring
Versie encoder en decoder samen, valideer numerieke wijzigingen na export, en behoud de schaal van de invoer. Monitor de reconstructieverdeling, latente drift, drempelwaarschuwingen en bevestigde uitkomsten. Bij industriële monitoring moet het model worden geconditioneerd op operationele modus zodat normale overgangen niet als fouten worden behandeld. Voor medische of wetenschappelijke reconstructie mag een gegenereerd detail nooit als gemeten bewijs worden gepresenteerd zonder validatie en herkomst. Autoencoders zijn flexibele representatie‑leerders, maar de beperkingen en het verlies — niet de architectuurnaam — bepalen welke informatie wordt behouden, weggegooid of verzonnen.
Voorbeeld: een autoencoder voor pomp‑anomalieën
Een ondercomplete autoencoder leert trillingsvensters van geverifieerde gezonde pompwerking over belasting en temperatuur. Het wordt vergeleken met statistische drempels en één‑klasse methoden, en de reconstructiedrempel wordt geselecteerd op beoordeelde normale overgangen en bekende storingen. Evaluatie gebruikt gebeurtenis‑recall, waarschuwing‑lead‑time, valse alarmen per operationeel uur, en resultaten per pomp, niet willekeurige vensters die aangrenzende monsters in training en test plaatsen.
Het productie‑model conditioneert op operationele staat en toont residuele patronen aan ingenieurs. Een hoge fout vraagt om inspectie; het diagnosticeert het onderdeel niet en stopt de pomp niet automatisch. Sensorontkoppeling, clipping en ongeziene belasting veroorzaken expliciete ongeldige toestanden. Monitoring volgt de reconstructieverdeling, alarmbevestiging en sensorgezondheid. Wanneer onderhoud of hardware de basislijn verandert, blijft het oude model beschikbaar terwijl een kandidaat wordt getraind op beoordeelde data en wordt afgespeeld tegen historische incidenten.
Implementatie‑bewijs en operationele gereedheid
Een productie‑beslissing vereist meer dan een succesvolle demonstratie. Definieer de beoogde gebruikers, operationele omgeving, invoer, uitvoer, afhankelijkheden, eigenaar, en de consequentie van elke belangrijke storing. Stel een reproduceerbare basislijn en een versie‑gecontroleerde evaluatieset vast vóór afstemming. Test gewone gevallen, randvoorwaarden, misvormde of ontbrekende invoer, distributieverandering, afhankelijkheidsuitval, misbruik, en de groepen of omgevingen die waarschijnlijk onderbediend worden. Meet taakkwaliteit samen met calibratie of onzekerheid, latency, doorvoer, resource‑kosten, toegankelijkheid, privacy en beveiliging. Leg elke transformatie en drempel vast zodat een onafhankelijke reviewer het resultaat kan reproduceren en bewijs kan onderscheiden van een aantrekkelijk prototype.
Voor de lancering moet autoriteit worden toegewezen voor release, uitzonderingen, wijzigingen, rollback en pensionering. Gebruik een gefaseerde uitrol, behoud een veilige fallback, en verifieer monitoring met opzettelijk geïnjecteerde storingen. Operationele telemetrie moet de kwaliteit van de invoer, het gedrag van de uitvoer, model‑ of regelversie, afhankelijkheidsgezondheid, menselijke overrides en bevestigde uitkomsten onthullen zonder onnodige gevoelige data te verzamelen. Definieer alarmdrempels en een verantwoordelijke voor respons, en beoordeel vervolgens bewijsmateriaal uit de praktijk na implementatie in plaats van aan te nemen dat offline prestaties aanhouden. Evalueer opnieuw wanneer gegevensbronnen, gebruikers, modellen, leveranciers, beleid, hardware of doelstellingen veranderen. Een onderhouden systeem heeft ook gedocumenteerd herstel, incident‑leren, verwijder‑ en retentieprocedures nodig, en een duidelijk punt waarop het moet worden uitgeschakeld of vervangen.
Veelgestelde vragen
Zijn autoencoders verliesloze compressie?
Niet algemeen. Ze leren meestal taak‑ en distributiespecifieke verliesgevende representaties en vereisen de getrainde decoder om data te reconstrueren.
Is elk knelpunt interpreteerbaar?
Nee. Een compacte code kan nuttig zijn zonder dat elke dimensie overeenkomt met een menselijk leesbaar concept.
Primaire referenties












