Andersons hoek
Hoe weet je of beeldsynthesesystemen werkelijk origineel materiaal produceren?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google

Belangrijkste puntenKAIST en NAVER's Rarity Score meet de originaliteit van afbeeldingen via afstanden tot…
Meer weergeven
- KAIST en NAVER's Rarity Score meet de originaliteit van afbeeldingen via afstanden tot de dichtstbijzijnde buren.
- Bestaande metrieken zoals de Truncation Trick geven de voorkeur aan authenticiteit boven nieuwigheid bij gegenereerde afbeeldingen.
- De Rarity Score zou werkelijk inventieve uitkomsten kunnen identificeren van systemen zoals DALL-E 2.
Een nieuwe studie uit Zuid-Korea heeft een methode voorgesteld om te bepalen of beeldsynthesesystemen echt nieuwe en originele beelden produceren, of slechts ‘kleine’ varianten op de trainingsdata, wat potentieel het doel van dergelijke architecturen (zoals de productie van nieuwe en originele beelden) kan ondermijnen.
Meestal, zoals het artikel suggereert, is het laatste waar. Omdat de bestaande metrics die dergelijke systemen gebruiken om hun generatieve capaciteiten te verbeteren tijdens de training, gedwongen worden om beelden te bevoordelen die relatief dicht bij de (niet-neppe) bronbeelden in de dataset liggen.
Als een gegenereerd beeld ‘visueel dichtbij’ de brondata is, is het onvermijdelijk waarschijnlijk dat het beter scoort voor ‘authenticiteit’ dan ‘originaliteit’, omdat het ‘getrouw’ is – als het niet inspirerend is.
In een sector die te nieuw en ongetest is voor zijn juridische implicaties om nog bekend te zijn, kan dit een belangrijk juridisch probleem worden, als het blijkt dat commerciële synthetische beeldinhoud niet genoeg verschilt van de (vaak) auteursrechtelijk beschermde bronmateriaal dat momenteel toegestaan wordt om de onderzoekssector te doordringen in de vorm van populaire van het web verzamelde datasets (de mogelijkheid voor toekomstige inbreukclaims van dit type is onlangs prominent geworden met betrekking tot Microsoft’s GitHub Co-Pilot AI).
In termen van de steeds coherentere en semantisch robuustere output van systemen zoals OpenAI’s DALL-E 2, Google’s Imagen en China’s CogView-releases (evenals de lager gespecificeerde DALL-E mini), zijn er heel weinig post facto manieren om de originaliteit van een gegenereerd beeld betrouwbaar te testen.
Feitelijk, het zoeken naar enkele van de meest populaire nieuwe DALL-E 2-beelden leidt vaak alleen tot meer instanties van dezelfde beelden, afhankelijk van de zoekmachine.

Het uploaden van een complete reeks van negen DALL-E 2-beelden leidt alleen naar meer DALL-E 2-reeksen, omdat het raster de sterkste eigenschap is. Het afzonderlijk uploaden van het eerste beeld uit dit Twitter-bericht van 8 juni 2022, van het account Weird Dall-E Generations, laat Google zich richten op de basketbal. Daardoor belandt de beeldzoekopdracht in een semantische doodlopende straat. Voor hetzelfde beeld lijkt Yandex ten minste werkelijke analyse op pixelniveau en vergelijking van kenmerken te doen.
Hoewel Yandex meer geneigd is dan Google Search om de daadwerkelijke kenmerken (d.w.z. een beelds afgeleide/berekende kenmerken, niet noodzakelijkerwijs gezichtskenmerken van mensen) en visuele (in plaats van semantische) kenmerken van een ingediend beeld te gebruiken om soortgelijke beelden te vinden, hebben alle beeldgebaseerde zoekmachines ofwel een soort agenda of praktijk die het moeilijk kan maken om voorbeelden van bron>gegenereerde plagiaat via webzoekopdrachten te identificeren.
Bovendien kan de trainingsdata voor een generatief model niet openbaar beschikbaar zijn in zijn geheel, waardoor forensische onderzoeken naar de originaliteit van gegenereerde beelden worden gehinderd.
Interessant, het uitvoeren van een beeldgebaseerde webzoekopdracht op een van de synthetische beelden die worden weergegeven door Google op zijn dedicated Imagen-site vindt absoluut niets vergelijkbaars met het onderwerp van het beeld, in termen van het daadwerkelijk kijken naar het beeld en onpartijdig zoeken naar soortgelijke beelden. In plaats daarvan, semantisch gefixeerd als altijd, zullen de Google Image-zoekresultaten voor deze Imagen-afbeelding geen pure beeldgebaseerde webzoekopdracht van de afbeelding toelaten zonder de zoektermen ‘imagen google’ als extra (en beperkende) parameter toe te voegen:

Yandex, daarentegen, vindt een veelheid van soortgelijke (of tenminste visueel verwante) echte wereldbeelden uit de amateurkunstgemeenschap:

Over het algemeen zou het beter zijn als de noviteit of originaliteit van de output van beeldsynthesesystemen op de een of andere manier kon worden gemeten, zonder dat het nodig is om kenmerken uit elk mogelijk web-georiënteerd beeld op internet te extraheren op het moment dat het model werd getraind, of in niet-openbare datasets die mogelijk auteursrechtelijk beschermde materialen gebruiken.
Gerelateerd aan dit probleem hebben onderzoekers van de Kim Jaechul Graduate School of AI aan het Korea Advanced Institute of Science and Technology (KAIST AI) samengewerkt met de mondiale ICT- en zoekmachine NAVER Corp om een Zeldzaamheidsscore te ontwikkelen die kan helpen om de meest originele creaties van beeldsynthesesystemen te identificeren.

Beelden hier zijn gegenereerd via StyleGAN-FFHQ. Van links naar rechts geven de kolommen de slechtste tot de beste resultaten weer. We kunnen zien dat de ‘Truncation trick’-metric (zie hieronder) en de Realism-metric hun eigen agenda’s hebben, terwijl de nieuwe ‘Zeldzaamheidsscore’ (bovenste rij) coherente maar originele beelden zoekt (in plaats van alleen coherente beelden). Aangezien er beeldgroottebeperkingen zijn in dit artikel, zie de bronpaper voor betere details en resolutie. Bron: https://arxiv.org/pdf/2206.08549.pdf
De nieuwe paper heeft de titel Zeldzaamheidsscore: een nieuwe metric om de ongebruikelijkheid van gesynthesiseerde beelden te evalueren en komt van drie onderzoekers van KAIST en drie van NAVER Corp.
Verder dan de goedkope truc
Onder de eerdere metrics die de nieuwe paper probeert te verbeteren, is de ‘Truncation trick’ voorgesteld in 2019 in een samenwerking tussen de UK’s Heriot-Watt University en Google’s DeepMind.
De Truncation Trick gebruikt in wezen een andere latente verdeling voor sampling dan die werd gebruikt voor het trainen van het generatieve model.
De onderzoekers die deze methode ontwikkelden, waren verbaasd dat het werkte, maar geven in het oorspronkelijke paper toe dat het de variëteit van gegenereerde output vermindert. Niettemin is de Truncation Trick effectief en populair geworden, in de context van wat mogelijk opnieuw kan worden beschreven als een ‘goedkope truc’ voor het verkrijgen van authentieke resultaten die niet echt alle mogelijkheden in de data assimileren en meer op de brondata kunnen lijken dan gewenst.
Met betrekking tot de Truncation Trick merken de auteurs van de nieuwe paper op:
‘[Het] is niet bedoeld om zeldzame monsters in de trainingsdatasets te genereren, maar om typische beelden meer stabiel te synthetiseren. We vermoeden dat bestaande generatieve modellen in staat zullen zijn om monsters te produceren die rijker zijn in de echte datadistributie als de generator kan worden geïnduceerd om effectief zeldzame monsters te produceren.’
Van de algemene neiging om traditionele metrics zoals Frechet Inception Distance (FID, die onder intense kritiek kwam te staan in december 2021), inception score (IS) en Kernel Inception Distance (KID) als ‘progressie-indicatoren’ tijdens de training van een generatief model, merken de auteurs verder op*:
‘Deze leerregel leidt de generator ertoe om niet veel zeldzame monsters te synthetiseren die uniek en sterke kenmerken hebben die geen groot deel van de echte beelddistributie uitmaken. Voorbeelden van zeldzame monsters uit openbare datasets zijn mensen met verschillende accessoires in FFHQ, witte dieren in AFHQ en ongewone standbeelden in Metfaces.
‘De mogelijkheid om zeldzame monsters te genereren is belangrijk, niet alleen omdat het gerelateerd is aan de grenzen van wat de generatieve modellen kunnen produceren, maar ook omdat uniciteit een belangrijke rol speelt in creatieve toepassingen zoals virtuele mensen.
‘De kwalitatieve resultaten van verschillende recente studies bevatten zelden deze zeldzame voorbeelden. We vermoeden dat de aard van de adversarial learning-regel de gegenereerde beelddistributie doet lijken op die van een trainingsdataset. Dus beelden met duidelijke individualiteit of zeldzaamheid nemen slechts een klein deel van de door de modellen gegenereerde beelden in.
Techniek
De onderzoekers’ nieuwe Zeldzaamheidsscore past een idee aan dat eerder is gepresenteerd in eerder werk – het gebruik van K-Nearest Neighbors (KNN’s) om de arrays van echte (trainings-) en synthetische (uitvoer-) data in een beeldsynthesesysteem te representeren.
Met betrekking tot deze nieuwe methode van analyse, beweren de auteurs:
‘We vermoeden dat gewone monsters dichter bij elkaar zullen liggen, terwijl unieke en zeldzame monsters spaarzaam in de kenmerkenruimte zullen liggen.’
De resultatenafbeelding hierboven toont de kleinste dichtstbijzijnde buurafstanden (NND’s) tot de grootste, in een StyleGAN-architectuur getraind op FFHQ.
‘Voor alle datasets laten monsters met de kleinste NND’s representatieve en typische beelden zien. Aan de andere kant hebben monsters met de grootste NND’s een sterke individualiteit en zijn ze significant verschillend van de typische beelden met de kleinste NND’s.’
In theorie, door deze nieuwe metric te gebruiken als een discriminator, of door het op te nemen in een complexere discriminator-architectuur, kan een generatief systeem worden afgeleid van pure imitatie naar een inventiever algoritme, terwijl het essentiële cohesie van concepten behoudt die kritisch kunnen zijn voor authentieke beeldproductie (d.w.z. ‘man’, ‘vrouw’, ‘auto’, ‘kerk’, enz.).
Vergelijkingen en experimenten
In tests, voerden de onderzoekers een vergelijking uit van de prestaties van de Zeldzaamheidsscore tegen zowel de Truncation Trick als NVIDIA’s 2019 Realism Score, en vonden dat de benadering in staat was om ‘unieke’ resultaten te identificeren.
Hoewel de resultaten in het paper te uitgebreid zijn om hier te worden weergegeven, lijken de onderzoekers te hebben aangetoond dat de nieuwe methode in staat is om zeldzaamheid te identificeren in zowel bron- (echte) als gegenereerde (neppe) beelden in een generatief procedé:
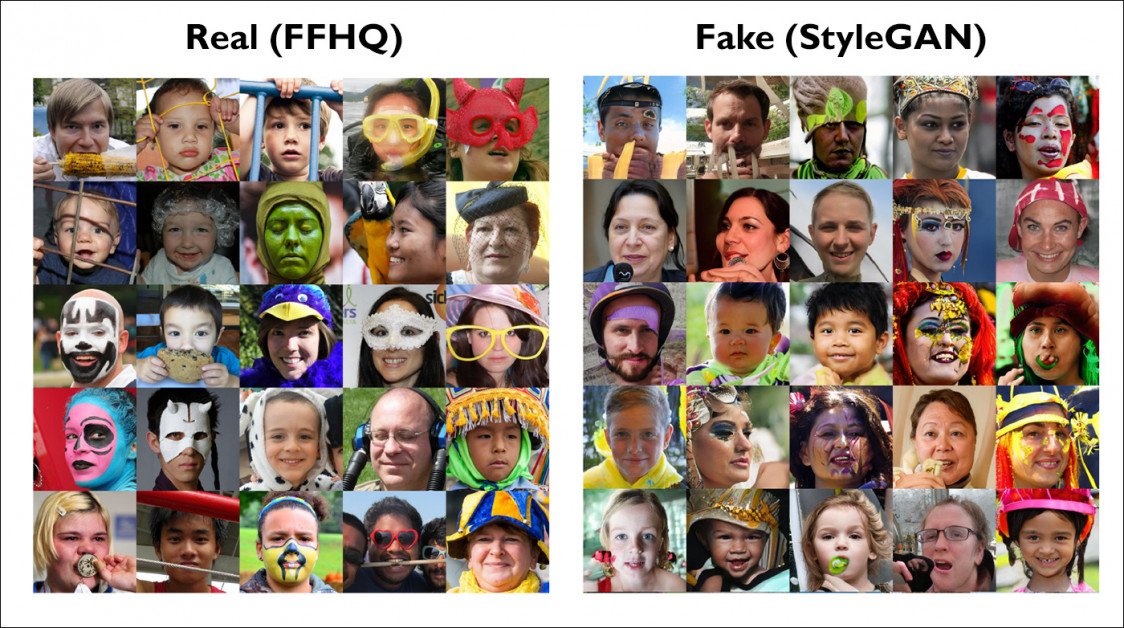
Geselecteerde voorbeelden uit de uitgebreide visuele resultaten van het artikel; zie de bron hierboven voor details. Links staan echte FFHQ-voorbeelden die in de oorspronkelijke dataset weinig nabije buren hebben en dus nieuw en ongebruikelijk zijn. Rechts staan door StyleGAN gegenereerde beelden die het nieuwe meetinstrument als werkelijk nieuw herkent. Vanwege de beperkte afbeeldingsgrootte in dit artikel biedt de oorspronkelijke studie meer details en een hogere resolutie.
De nieuwe Zeldzaamheidsscore-metric maakt niet alleen de mogelijkheid om ‘nieuwe’ generatieve output in een enkele architectuur te identificeren, maar stelt ook, volgens de onderzoekers, vergelijkingen tussen generatieve modellen van verschillende en variabele architecturen (d.w.z. autoencoder, VAE, GAN, enz.) mogelijk.
De paper merkt op dat de Zeldzaamheidsscore zich onderscheidt van eerdere metrics door te focussen op de mogelijkheid van een generatief kader om unieke en zeldzame beelden te creëren, in tegenstelling tot ‘traditionele’ metrics, die (meer myopisch) de diversiteit tussen generaties tijdens de training van het model onderzoeken.
Verder dan beperkte taken
Hoewel de onderzoekers van de nieuwe paper tests hebben uitgevoerd op beperkte domeinframeworks (zoals generator/dataset-combinaties die specifiek zijn ontworpen om beelden van mensen of katten te produceren, bijvoorbeeld), kan de Zeldzaamheidsscore potentieel worden toegepast op elke willekeurige beeldsyntheseprocedure waarbij het gewenst is om gegenereerde voorbeelden te identificeren die de distributies gebruiken die zijn afgeleid van de getrainde data, in plaats van authenticiteit te verhogen (en diversiteit te verlagen) door vreemde latente verdelingen te introduceren, of te vertrouwen op andere sluiproutes die noviteit inruilen voor authenticiteit.
In feite, een dergelijke metric kan potentieel echt nieuwe output-exemplaren in systemen zoals de DALL-E-serie onderscheiden, door de geïdentificeerde afstand tussen een schijnbare ‘outlier’-resultaat, de trainingsdata en resultaten van soortgelijke prompts of invoer (d.w.z. beeldgebaseerde prompts) te gebruiken.
In de praktijk, en in het gebrek aan een duidelijk begrip van de mate waarin het systeem de visuele en semantische concepten echt heeft geassimileerd (vaak gehinderd door beperkte kennis over de trainingsdata), kan dit een haalbare methode zijn om een echt inspiratiemoment in een generatief systeem te identificeren – het punt waarop een adequate hoeveelheid invoerconcepten en data hebben geresulteerd in iets echt inventiefs, in plaats van iets te veel afgeleid of dicht bij de brondata.
* Mijn conversies van de auteurs’ inline citaten naar hyperlinks.
Voor het eerst gepubliceerd op 20 juni 2022.