
AI-basisprincipes
Wat is een NPU? Neural Processing Units uitgelegd

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Een neural processing unit (NPU) is een gespecialiseerde accelerator die is ontworpen om veelvoorkomende neurale‑netwerkbewerkingen efficiënt uit te voeren. In telefoons, pc’s, voertuigen, camera’s en embedded systemen kan hij ondersteunde AI‑werkbelastingen draaien met minder energie of de CPU en GPU vrijmaken voor andere taken.
NPU is een brede industrieterm in plaats van één universele architectuur. De prestaties hangen af van ondersteunde operatoren, numerieke formaten, geheugen, compiler en runtime, thermische limieten, en hoeveel van een toepassing op de accelerator kan blijven.
Belangrijkste punten
- NPUs leggen de nadruk op matrix-, vector- en tensorbewerkingen met hoge gegevenshergebruik en laag stroomverbruik.
- Piek‑TOPS is geen end‑to‑end toepassingsbenchmark en kan een specifieke precisie of sparsiteit veronderstellen.
- Een model kan conversie, kwantisatie, grafpartitionering en fallback nodig hebben voor niet‑ondersteunde bewerkingen.
- Vergelijk latentie, doorvoer, energie, geheugen, kwaliteit, privacy en draagbaarheid op de werkelijke belasting.
CPU-, GPU- en NPU‑rollen
CPU’s blinken uit in algemene controle‑stroom en brede compatibiliteit. GPU’s bieden programmeerbare parallelle doorvoer en een groot software‑ecosysteem. NPU’s zijn gespecialiseerd in herhaalde tensorbewerkingen en kunnen lokaal geheugen, vermenigvuldig‑en‑accumuleer‑arrays en data‑flow geoptimaliseerd voor inferentie bevatten.
Heterogene systemen plannen verschillende delen op de plek waar ze het best passen. Dit is relevant voor edge AI, waar een constant stroomverbruik en responsiviteit belangrijker kunnen zijn dan piek‑doorvoer van datacenters.
Modelcompilatie en uitvoering
Een framework‑grafiek wordt omgezet naar een tussenrepresentatie, geoptimaliseerd, waar nodig gekwantiseerd en gecompileerd voor ondersteunde operatoren. De runtime kan de grafiek partitioneren zodat niet‑ondersteunde lagen op de CPU of GPU worden uitgevoerd.
Overdrachten tussen processoren kunnen de voordelen van de accelerator tenietdoen. Statische vormen, lay‑out, precisie, batch‑groottes en geheugenhergebruik beïnvloeden de prestaties. Test het gecompileerde artefact omdat de kwaliteit van een deep‑learning model kan veranderen na conversie.
Begrijp TOPS en efficiëntieclaims
TOPS geeft triljoenen bewerkingen per seconde weer onder gedefinieerde aannames. Leveranciers kunnen vermenigvuldigen en optellen afzonderlijk tellen, lage‑bit integer‑precisie gebruiken, of sparsiteit veronderstellen. Een hoger getal garandeert geen lagere latentie voor een specifiek model.
Meet koude en warme start, per‑query latentie, doorvoer, energie, piek‑geheugen, thermische throttling, ondersteunde context‑ of afbeeldingsgrootte, en het deel van de grafiek dat wordt versneld. Gebruik gelijkwaardige nauwkeurigheid en software‑versies.
AI‑trade‑offs op apparaat
Lokaal uitvoeren kan de afhankelijkheid van het netwerk verminderen en ruwe invoer op het apparaat houden, maar gedownloade modellen, logs, back‑ups en cloud‑fallbacks blijven gegevensstromen veroorzaken. Veilige modellevering en platformupdates blijven noodzakelijk.
NPUs kunnen vision‑, audio‑, taal- en sensortoepassingen ondersteunen, inclusief workloads die gerelateerd zijn aan TinyML. Ontwikkelaars moeten een elegante fallback ontwerpen en communiceren wanneer verwerking het apparaat verlaat.
NPU‑architectuur en ondersteunde bewerkingen
Een NPU versnelt tensorbewerkingen door arrays van multiply‑accumulate‑eenheden, lokaal geheugen, data‑flow planning en gespecialiseerde numerieke formaten te gebruiken. Het dicht bij de berekening houden van gewichten en activaties vermindert dure gegevensverplaatsing. Werkelijke apparaten verschillen in ondersteuning van operatoren, geheugenhierarchie, precisie, sparsiteit, programmeerbaarheid en hoe werk wordt gedeeld met CPU en GPU.
Piekprestaties worden vaak geadverteerd in TOPS, maar TOPS specificeert geen precisie, benutting, geheugenlimieten, operator‑dekking of end‑to‑end latentie. Twee processoren met hetzelfde kopcij‑cijfer kunnen verschillend presteren op hetzelfde model. Benchmark het gecompileerde model, realistische batch‑ en sequentiegroottes, preprocessing, overdrachten en stroom‑modus.
NPUs zijn effectief voor ondersteunde neurale werkbelastingen zoals vision, spraak, ruisonderdrukking, achtergrond‑effecten en compacte taalmodellen. Niet‑ondersteunde operatoren kunnen terugvallen op CPU of GPU, waardoor overdrachten en onvoorspelbare latentie ontstaan. Inspecteer compiler‑rapporten en runtime‑traces om de plaatsing te bevestigen in plaats van aan te nemen dat de volledige grafiek de accelerator gebruikt.
Modelconversie, kwantisatie en implementatie
Implementatie verloopt meestal van een trainingsframework via export, grafiekoptimalisatie, kwantisatie, vendor‑compilatie en runtime‑integratie. Statische vormen en gangbare operatoren zijn het gemakkelijkst te versnellen. Dynamische control‑flow, aangepaste kernels, grote tussen‑tensoren en niet‑ondersteunde normalisatie‑ of aandachtspatronen kunnen grafiek‑wijzigingen of hybride uitvoering vereisen.
Integer‑ en lagere‑precisie formaten verkleinen modelgrootte, bandbreedte, energie en latentie, maar kalibratie‑data moeten echte invoer representeren. Vergelijk post‑training kwantisatie met kwantisatie‑bewuste training wanneer kwaliteit gevoelig is. Evalueer per‑klasse en worst‑case gedrag omdat gemiddelde nauwkeurigheid degradatie in zeldzame of veiligheidsrelevante gevallen kan verbergen.
In‑device inferentie verbetert latentie, offline werking en privacy door gegevensoverdracht te beperken, maar het apparaat heeft nog steeds veilige modellen, toestemming‑bewuste gegevens‑toegang en update‑mechanismen nodig. Bescherm modelbestanden waar nodig, onderteken updates, maak cloud‑fallback duidelijk, en zorg ervoor dat telemetrie de privacy‑exposure die de lokale architectuur moest verminderen niet opnieuw introduceert.
Prestatie‑evaluatie en systeem‑level trade‑offs
Meet koude‑start en steady‑state latentie, doorvoer, energie per inferentie, geheugen, thermisch gedrag, nauwkeurigheid en batterij‑impact. Lange tests onthullen throttling die korte benchmarks missen. Neem preprocessing en postprocessing op omdat herschalen, tokenisatie, decodering of gegevenskopieën een anderszins snelle accelerator kunnen domineren.
Planning is een systeemprobleem. De CPU beheert applicatielogica, de GPU kan renderen of niet‑ondersteunde lagen uitvoeren, en de NPU draait compatibele grafieken. Gelijktijdige camera‑, audio‑, display‑ en AI‑werkbelastingen concurreren om geheugen‑bandbreedte en stroom. Test het volledige gebruiksscenario in plaats van een geïsoleerd model in een vendor‑tool.
Draagbaarheid blijft beperkt over compilers en runtimes. Geef de voorkeur aan standaard modelrepresentaties waar ze werken, isoleer vendor‑specifieke code achter interfaces, bewaar referentie‑outputs, en onderhoud test‑dekking op apparaten. Kies hardware op basis van gevalideerde werkbelastingen, software‑ondersteuning, update‑horizon en totale systeemkosten — niet op basis van één accelerator‑specificatie.
Voorbeeld: een vision‑model implementeren op een NPU‑laptop
Een team traint een segmentatiemodel voor achtergrond‑effecten, exporteert het naar een ondersteund uitwisselingsformaat, vervangt niet‑ondersteunde operatoren, en kalibreert integer‑kwantisatie met representatieve camera’s, verlichting, huidtinten, kleding en achtergronden. De vendor‑compiler meldt welke knooppunten op de NPU draaien en welke fallbacken. Het team beschouwt elke fallback‑overgang als een systeemkost, omdat tensor‑overdrachten een snelle individuele kernel kunnen domineren.
Benchmarken meet camera‑preprocessing, modeluitvoering, compositing, geheugen, koude start, steady‑state latentie, frame‑stabiliteit, stroom en thermische throttling tijdens een echte videogesprek. Resultaten worden vergeleken met CPU‑ en GPU‑paden bij gelijke uitvoerkwaliteit. De applicatie gebruikt capaciteitsdetectie en een geteste fallback in plaats van aan te nemen dat de accelerator bestaat of dezelfde grafiek ondersteunt na een driver‑update.
Release‑testen omvatten apparaatmodellen, besturingssysteem‑ en driver‑versies, gelijktijdige werkbelastingen, batterij‑modi en misvormde invoer. Modelpakketten worden ondertekend en geversioneerd; telemetrie registreert prestaties en fouten zonder onnodige video te verzamelen. Het product legt uit wanneer verwerking op het apparaat blijft en wanneer cloud‑functies worden gebruikt. De NPU verdient zijn plaats door de volledige ervaring te verbeteren onder realistische beperkingen, niet door een geïsoleerde TOPS‑ of kernel‑benchmark te behalen.
Praktische implementatie‑checklist
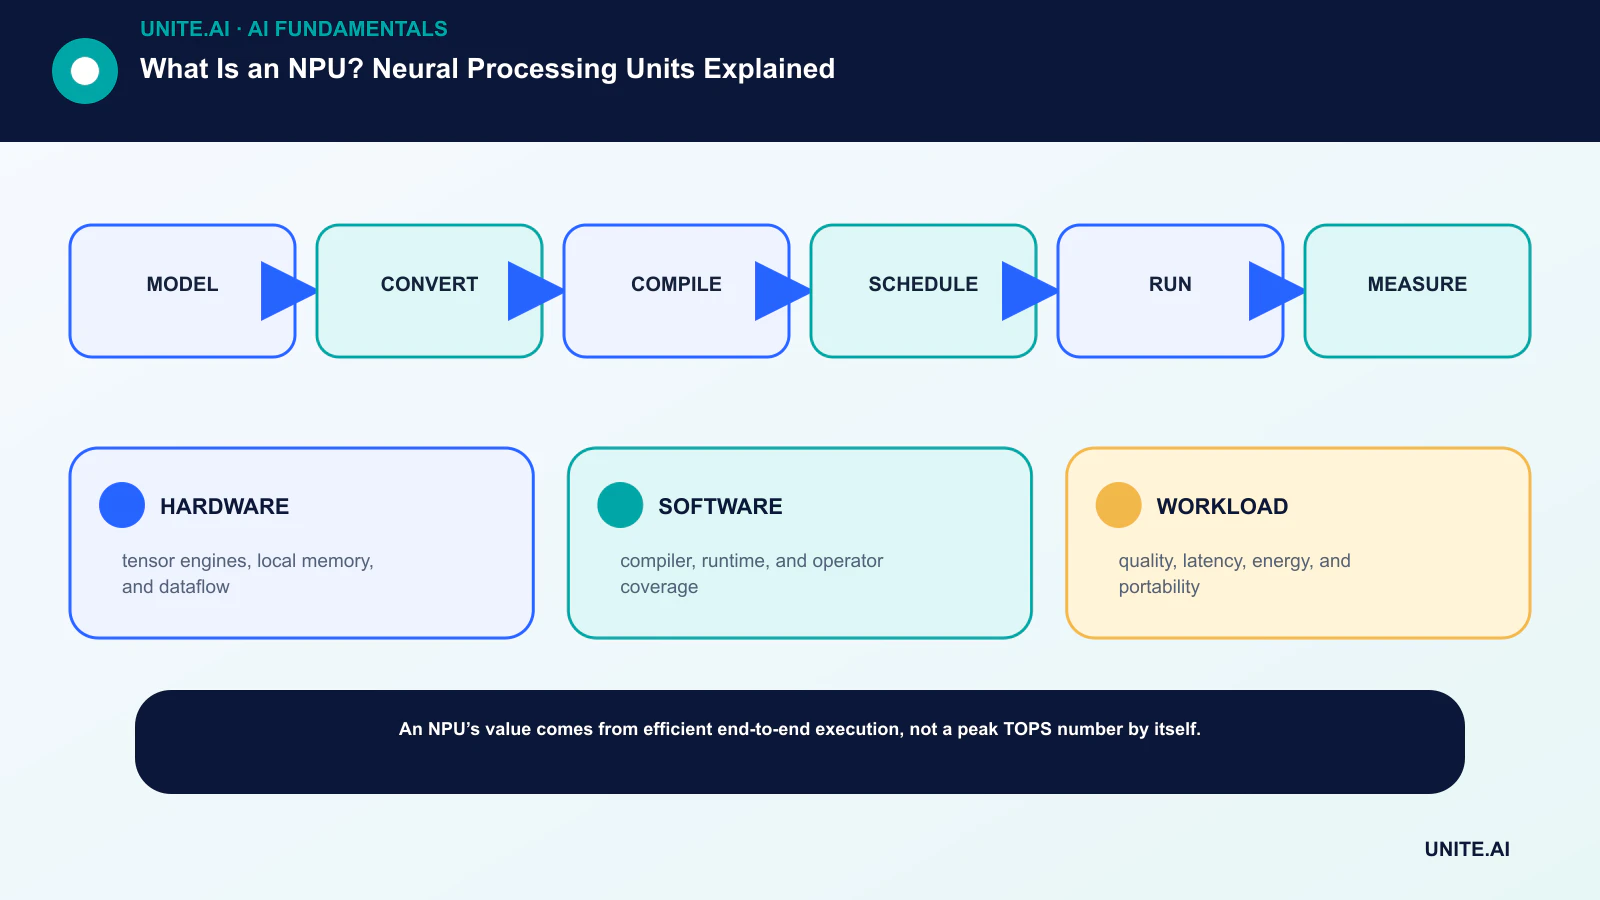
Zet het concept om in een begrensde, testbare workflow: model → converteren → compileren → plannen → uitvoeren → meten. Benoem een verantwoordelijke eigenaar, documenteer de data en afhankelijkheden, stel een eenvoudige basislijn vast, definieer acceptatie‑ en stopcriteria, test representatieve fouten, en bepaal monitoring, rollback en review voordat de scope wordt uitgebreid. Leg versies en aannames vast zodat een ander team het resultaat kan reproduceren en begrijpt wat er is veranderd.
Voor de lancering voert u een gedocumenteerde gereedheids‑review uit met de mensen die het systeem bouwen, exploiteren, beveiligen en erdoor worden beïnvloed. Test normale gevallen, grensvoorwaarden, afhankelijkheids‑fouten en misbruik; bewaar het bewijs en onopgeloste risico’s. Definieer wie een release kan goedkeuren, een drempel kan wijzigen, een output kan overschrijven of de werking kan stoppen. Herzie de beslissing zodra real‑world data beschikbaar is, want een technisch geslaagde pilot garandeert geen betrouwbare prestaties op grotere schaal.
- HARDWARE: tensor‑engines, lokaal geheugen en data‑flow.
- SOFTWARE: compiler, runtime en operator‑dekking.
- WORKLOAD: kwaliteit, latentie, energie en draagbaarheid.
Veelgestelde vragen
Is een NPU sneller dan een GPU?
Het hangt af van het model, de precisie, de operatorondersteuning, batch‑grootte, stroomlimiet en software. Een NPU kan efficiënter zijn voor een ondersteunde on‑device werkbelasting, terwijl een GPU elders sneller of flexibeler is.
Houdt een NPU alle AI‑gegevens privé?
Nee. Het maakt lokale verwerking mogelijk, maar de applicatie kan nog steeds gegevens of output naar cloud‑services sturen. Privacy hangt af van de volledige architectuur en het beleid.
Primaire referenties












