
Dasar-dasar AI
Pembelajaran Terawasi vs Pembelajaran Tak Terawasi

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
Pembelajaran terawasi belajar dari contoh yang dipasangkan dengan jawaban target. Pembelajaran tak terawasi mencari struktur dalam data tanpa label target. Perbedaannya bukan tentang pendekatan mana yang lebih cerdas atau akurat; melainkan jenis sinyal pembelajaran yang tersedia dan pertanyaan yang dirancang untuk dijawab oleh sistem.
Ini adalah dua paradigma utama dalam pembelajaran mesin, namun sistem modern juga menggunakan pembelajaran semi-terawasi, pembelajaran swaterawasi, dan pembelajaran penguatan.
Poin-poin Penting
- Pembelajaran terawasi memprediksi target yang diketahui; pembelajaran tak terawasi menemukan pola atau representasi.
- Klasifikasi dan regresi adalah tugas terawasi; clustering, estimasi kepadatan, dan banyak metode reduksi dimensi adalah tak terawasi.
- Output tak terawasi tidak otomatis menjadi kelas dunia nyata dan dapat lebih sulit dievaluasi.
- Biaya komputasi dan akurasi bergantung pada algoritma, data, tugas, dan evaluasi—bukan semata pada paradigma.
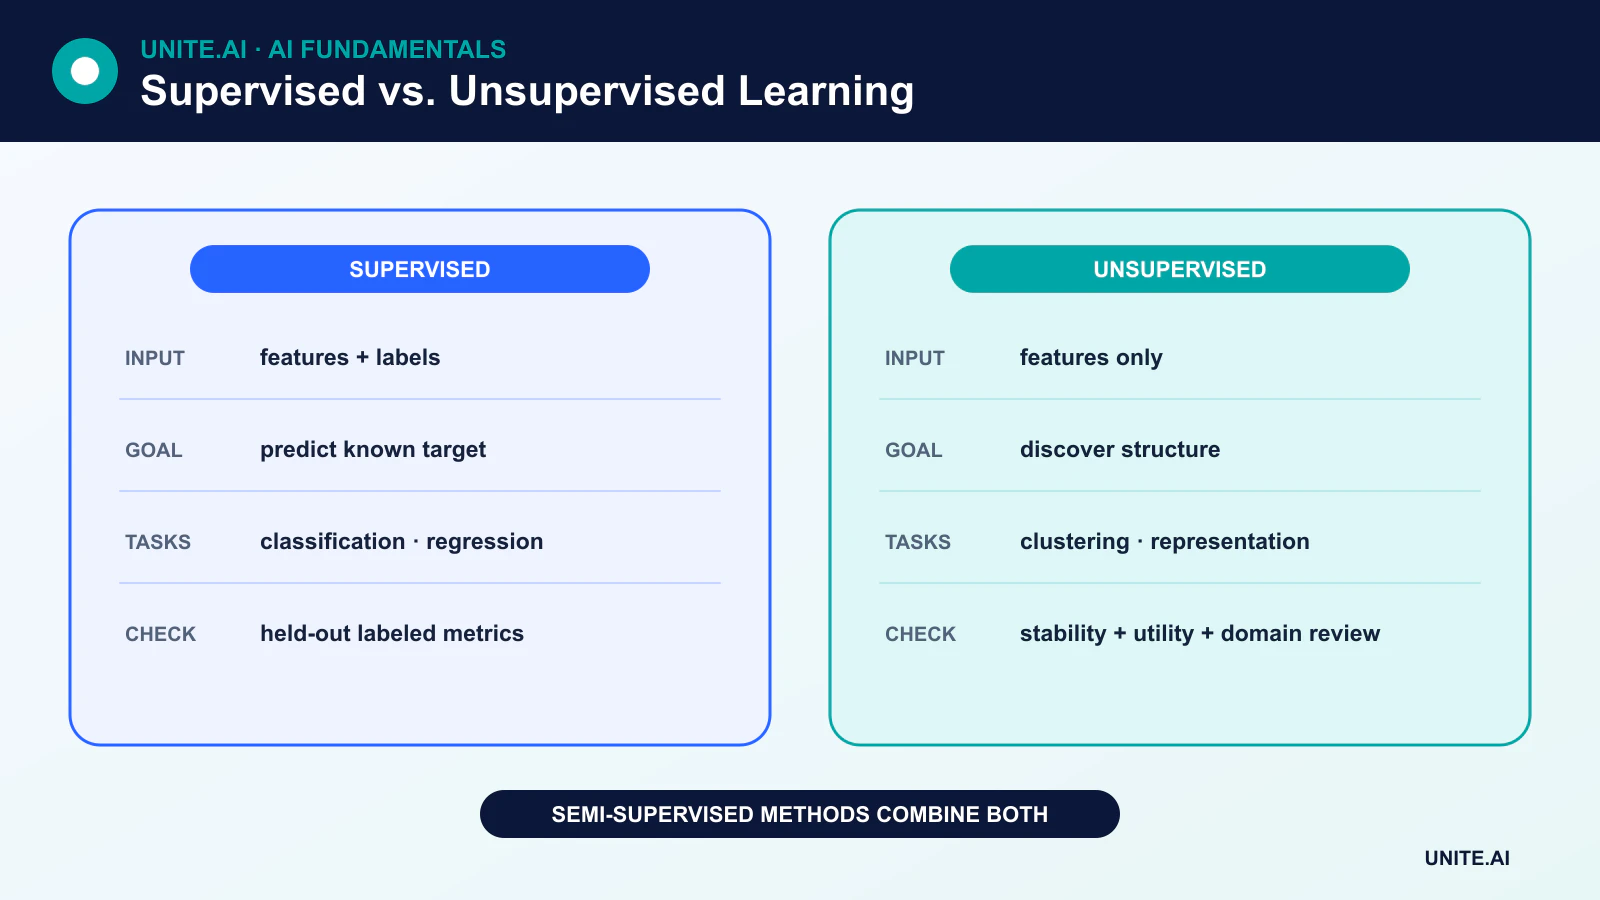
Bagaimana Pembelajaran Terawasi Bekerja
Dataset terawasi berisi fitur X dan target y. Proses pelatihan menyesuaikan model sehingga prediksinya mendekati target. Evaluasi menggunakan contoh berlabel yang dipisahkan untuk memperkirakan seberapa baik model tersebut menggeneralisasi.
Klasifikasi
Klasifikasi memprediksi sebuah kategori: spam atau bukan spam, satu topik dokumen di antara beberapa, atau satu atau lebih objek dalam sebuah gambar. Metrik yang relevan meliputi presisi, recall, F1, kalibrasi, dan ukuran sensitif biaya. Akurasi dapat menyesatkan ketika satu kelas jarang; sebuah matriks kebingungan mengungkap kelas mana yang tertukar.
Regresi
Regresi memprediksi nilai kontinu, seperti permintaan, durasi, atau suhu. Regresi linear dapat menggunakan satu atau banyak fitur; tidak terbatas pada hubungan antara dua variabel. Metrik regresi meliputi rata‑rata kesalahan absolut, akar kuadrat rata‑rata kuadrat, dan biaya khusus tugas.
Algoritma Terawasi Umum
Metode terawasi mencakup model linier dan logistik, pohon keputusan, hutan acak, gradient boosting, mesin vektor pendukung, K-nearest neighbors, dan jaringan saraf.
Regresi logistik menghasilkan skor atau probabilitas yang dapat dikonversi menjadi kelas menggunakan ambang yang dipilih. Daun pohon keputusan berisi prediksi berdasarkan wilayah ruang fitur, tidak harus berasal dari satu contoh pelatihan. KNN memprediksi dari contoh pelatihan berlabel yang berdekatan dan tetap memerlukan desain pelatihan/validasi/pengujian yang baik.
Bagaimana Pembelajaran Tak Terawasi Bekerja
Pembelajaran tak terawasi menerima fitur tanpa kolom target. Tujuannya didefinisikan secara tidak langsung—misalnya, meminimalkan jarak dalam klaster, merekonstruksi input, memperkirakan kepadatan data, atau mempertahankan sebanyak mungkin varians dalam dimensi yang lebih sedikit.
Pengelompokan
K-means menugaskan titik ke sejumlah klaster yang dipilih dan memperbarui pusat klaster untuk mengurangi jarak kuadrat dalam klaster. Algoritma ini menemukan pengelompokan geometris berdasarkan jarak dan representasi fitur tertentu. Kelompok tersebut tidak otomatis berkorespondensi dengan tipe pelanggan, diagnosis, atau label domain yang bermakna.
Reduksi Dimensi
Reduksi dimensi merepresentasikan data dengan menggunakan lebih sedikit variabel. Analisis komponen utama menemukan arah ortogonal yang mempertahankan sebanyak mungkin varians dalam proyeksi linier. Metode lain mempertahankan konsep struktur yang berbeda dan dapat menghasilkan visualisasi yang sangat berbeda.
Deteksi Anomali dan Estimasi Kepadatan
Metode tak terawasi dapat memperkirakan daerah data yang padat dan menandai observasi yang tidak biasa. Skor anomali tidak membuktikan adanya penipuan, kegagalan, atau perilaku berbahaya; ia mengidentifikasi penyimpangan berdasarkan representasi dan model yang dipilih.
Bagaimana Pembelajaran Tak Terawasi Dievaluasi
Tidak ada konsep universal tentang “akurasi” pada pembelajaran tak terawasi. Praktisi dapat menggunakan metrik internal seperti skor siluet, membandingkan stabilitas antar sampel, menguji kegunaan dalam tugas hilir, atau menanyakan kepada pakar domain apakah struktur yang ditemukan bermakna. Jika label kebenaran dasar tersedia untuk evaluasi, metrik clustering eksternal dapat digunakan tanpa mengubah proses pelatihan menjadi pembelajaran terawasi.
Melebihi Perbandingan Dua Arah
Pembelajaran Semi‑Terawasi
Pembelajaran semi‑terawasi menggabungkan set berlabel yang lebih kecil dengan set tak berlabel yang lebih besar. Contohnya meliputi pseudo‑labeling, regularisasi konsistensi, dan metode berbasis graf. Data tak berlabel tetap harus menyerupai distribusi target dengan cukup dekat agar dapat membantu.
Pembelajaran Swaterawasi
Pembelajaran swaterawasi menghasilkan target dari input itu sendiri, seperti memprediksi token yang disembunyikan atau mencocokkan tampilan yang diubah. Ini menjadi dasar bagi model bahasa, visi, dan multimodal modern, termasuk transformer.
Pembelajaran Penguatan
Pembelajaran penguatan mengoptimalkan keputusan melalui hadiah yang dihasilkan dari interaksi. Ia berbeda dari prediksi berlabel maupun penemuan pola statis.
Memilih Pendekatan yang Tepat
Mulailah dengan keputusan atau wawasan yang harus dihasilkan sistem. Jika target yang dapat diandalkan ada dan tujuan utama adalah prediksi, pembelajaran terawasi adalah pilihan alami. Jika tujuan adalah eksplorasi, representasi, atau pengelompokan, metode tak terawasi mungkin cocok. Ketika label langka, pra‑pelatihan swaterawasi atau semi‑terawasi yang diikuti dengan evaluasi terawasi dapat lebih efektif.
Dalam setiap kasus, kebocoran data, sampel bias, proksi lemah, dan pergeseran distribusi dapat mendominasi pemilihan algoritma. Model yang secara teknis benar namun dilatih dengan tujuan yang salah tetap dapat gagal.
Sinyal Pembelajaran, Tujuan, dan Metode Representatif
Pembelajaran terawasi menggunakan contoh yang dipasangkan dengan label atau nilai target dan mengoptimalkan kesalahan prediksi. Klasifikasi, regresi, perankingan, dan prediksi terstruktur berbeda dalam output dan fungsi kerugian. Pembelajaran tak terawasi mencari struktur tanpa label target melalui clustering, estimasi kepadatan, reduksi dimensi, pembelajaran representasi, atau pemodelan generatif. Pembelajaran swaterawasi menciptakan target prediksi dari data itu sendiri, sementara pembelajaran semi‑terawasi menggabungkan set berlabel kecil dengan data tak berlabel yang lebih besar. Kategori ini menggambarkan sinyal pembelajaran; arsitektur neural yang sama dapat dilatih di bawah beberapa paradigma.
Label menjadikan tujuan eksplisit namun menambah biaya anotasi, kebisingan, asumsi kebijakan, dan keterlambatan temporal. Data tak berlabel lebih mudah dikumpulkan tetapi tidak memberi tahu algoritma struktur mana yang berguna. Sebuah klaster dapat mencerminkan pencahayaan, panjang dokumen, atau sumber akuisisi alih‑alih kategori yang bermakna. Definisikan evaluasi secara independen: model terawasi menggunakan hasil berlabel yang dipisahkan, sementara model tak terawasi memerlukan stabilitas, rekonstruksi, likelihood, penarikan, kegunaan hilir, atau validasi pakar. Pemisahan visual saja bukan bukti struktur yang sah.
Memilih Paradigma dan Mencegah Kesalahan Umum
Gunakan pembelajaran terawasi ketika target yang stabil dan label representatif tersedia. Gunakan eksplorasi tak terawasi untuk merangkum, mendeteksi kebaruan, mengompresi, atau menghasilkan hipotesis, namun perlakukan outputnya sebagai sementara. Pra‑pelatihan swaterawasi berharga ketika data mentah melimpah dan tugas hilir berbagi representasi. Metode semi‑terawasi membantu hanya bila asumsi tentang data tak berlabel dan struktur kelas terpenuhi. Bandingkan dengan baseline sederhana dan pertimbangkan total biaya pengumpulan, pelabelan, peninjauan, komputasi, dan kesalahan alih‑alih mengasumsikan data tak berlabel otomatis murah.
Cegah kebocoran dengan memisahkan entitas terkait sebelum menghasilkan label, augmentasi, atau pseudo‑label. Pantau keseimbangan kelas, kesepakatan anotasi, stabilitas klaster, keruntuhan, dan drift. Pseudo‑label dapat memperkuat kesalahan awal; clustering dapat menyandikan atribut sensitif; representasi pra‑latih dapat mentransfer bias sumber. Peninjauan manusia harus fokus pada kasus batas dan konsekuensinya. Dalam produksi, dokumentasikan bagaimana sinyal pembelajaran dibuat dan kapan ia menjadi usang. Paradigma menentukan di mana supervisi masuk ke sistem, bukan apakah pilihan dan nilai manusia hadir.
Contoh Praktis: Menemukan dan Menandai Topik Dukungan
Sebuah perusahaan pertama kali menggunakan embedding tak terawasi dan clustering untuk mengeksplorasi tema dalam pesan dukungan yang dihilangkan identitasnya. Analis memeriksa contoh representatif dan batas serta menemukan bahwa beberapa klaster mencerminkan panjang pesan dan saluran alih‑alih masalah. Mereka mengembangkan taksonomi terawasi dengan kelas tak dikenal, panduan anotasi, dan kesepakatan terukur. Sebuah classifier kemudian dievaluasi pada periode waktu, bahasa, dan produk berikutnya dibandingkan dengan baseline berbasis kata kunci dan tetangga terdekat.
Pesan baru yang tidak berlabel mendukung penemuan drift tetapi tidak melatih ulang classifier secara otomatis. Peninjau menandai kasus tidak pasti dan yang muncul melalui pembelajaran aktif, dengan pemeriksaan kualitas dan set evaluasi tertutup. Pemantauan melacak prevalensi topik, kepercayaan, ketidaksepakatan, dan hasil routing. Ketika produk baru diluncurkan, taksonomi dan kapasitas tim hilir diperbarui secara bersamaan. Alur kerja menggunakan metode tak terawasi untuk menghasilkan hipotesis dan bukti terawasi untuk routing operasional.
Bukti Implementasi dan Kesiapan Operasional
Keputusan produksi membutuhkan lebih dari sekadar demonstrasi yang berhasil. Definisikan pengguna yang dituju, lingkungan operasi, masukan, keluaran, ketergantungan, pemilik, dan konsekuensi setiap kegagalan penting. Bangun baseline yang dapat direproduksi dan set evaluasi berversi sebelum penyetelan. Uji kasus biasa, kondisi batas, input yang rusak atau hilang, pergeseran distribusi, kegagalan ketergantungan, penyalahgunaan, serta kelompok atau lingkungan yang paling mungkin kurang terlayani. Ukur kualitas tugas bersama dengan kalibrasi atau ketidakpastian, latensi, throughput, biaya sumber daya, aksesibilitas, privasi, dan keamanan. Catat setiap transformasi dan ambang sehingga peninjau independen dapat mereproduksi hasil dan membedakan bukti dari prototipe yang menarik.
Sebelum peluncuran, tetapkan otoritas untuk rilis, pengecualian, perubahan, rollback, dan pensiun. Gunakan peluncuran bertahap, pertahankan fallback yang aman, dan verifikasi pemantauan dengan kegagalan yang sengaja disuntikkan. Telemetri operasional harus mengungkap kualitas input, perilaku output, versi model atau aturan, kesehatan ketergantungan, intervensi manusia, dan hasil yang terkonfirmasi tanpa mengumpulkan data sensitif yang tidak diperlukan. Definisikan ambang peringatan dan pemilik respons, lalu tinjau bukti dunia nyata setelah implementasi alih‑alih mengasumsikan kinerja offline akan bertahan. Evaluasi kembali setiap kali sumber data, pengguna, model, vendor, kebijakan, perangkat keras, atau tujuan berubah. Sistem yang dipelihara juga memerlukan dokumentasi pemulihan, pembelajaran insiden, prosedur penghapusan dan retensi, serta titik yang jelas di mana sistem harus dinonaktifkan atau diganti.
Referensi Utama












