Dasar-dasar AI
Apa Itu Support Vector Machines?

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
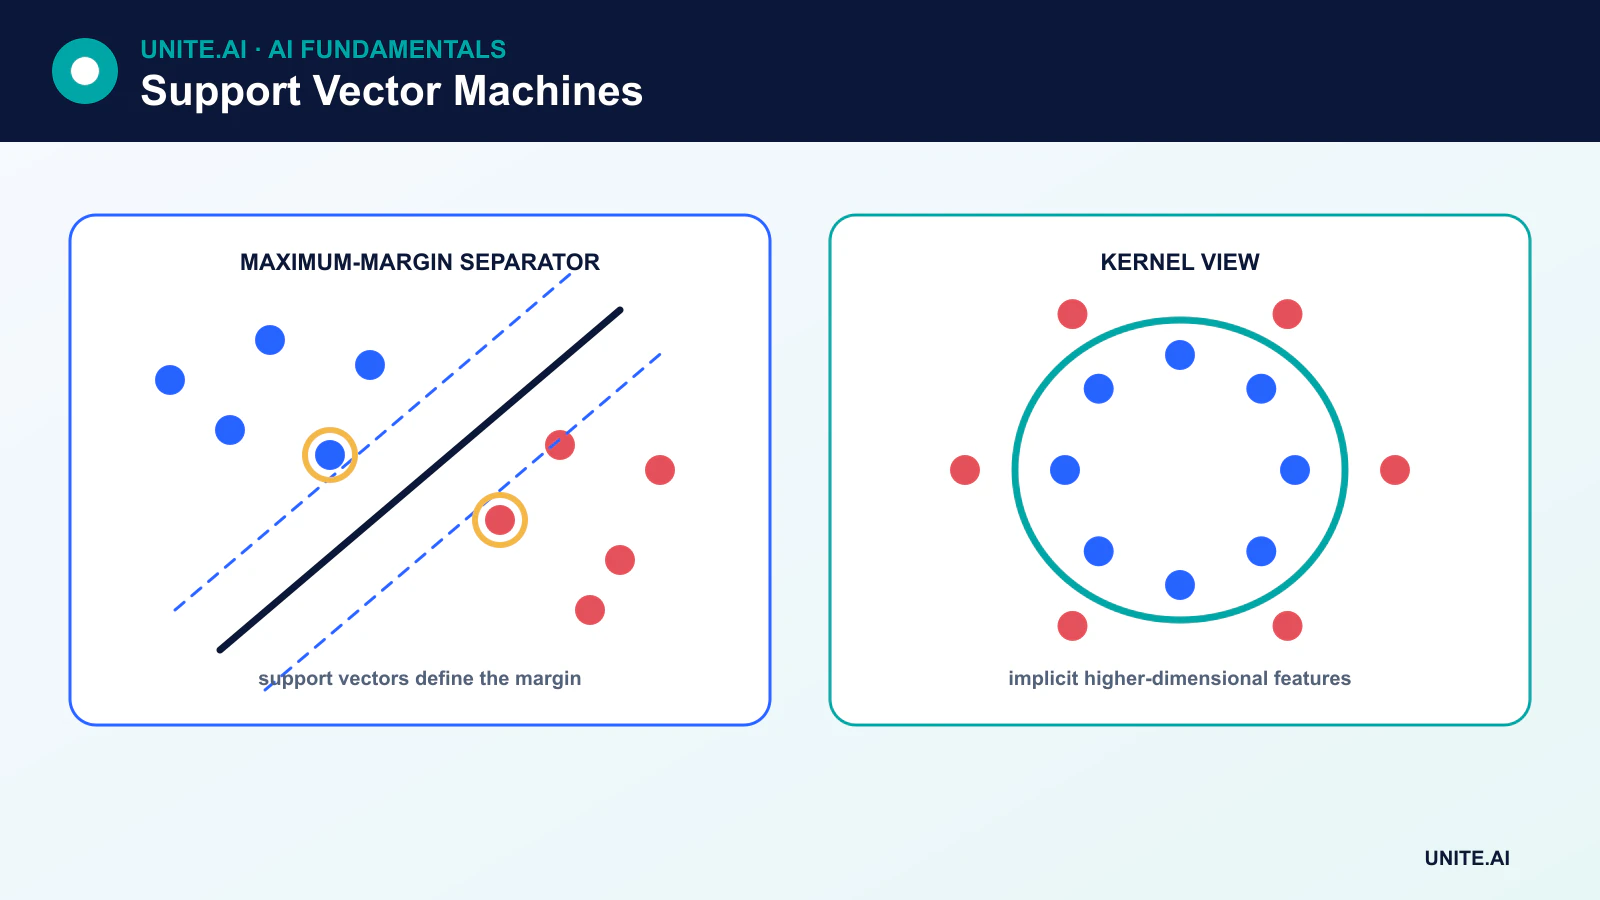
Suatu support vector machine (SVM) adalah metode pembelajaran terawasi yang menemukan batas keputusan dengan margin seluas‑luasnya antara kelas. Contoh pelatihan yang menentukan batas tersebut adalah support vectors.
SVM dapat melakukan klasifikasi linear atau non‑linear, regresi, dan deteksi kebaruan. Mereka sangat berguna untuk dataset kecil‑menengah dengan fitur informatif, termasuk data jarang berdimensi tinggi, namun biaya pelatihan dapat menjadi tidak praktis pada dataset yang sangat besar.
Poin Penting
- SVM memaksimalkan margin minimum antara batas dan titik pelatihan terdekat.
- Support vectors adalah titik data, bukan hyperplane tambahan.
- Parameter C menyeimbangkan lebar margin dengan penalti atas pelanggaran.
- Kernel menghitung kesamaan dalam ruang fitur implisit tanpa secara eksplisit mematerialisasi setiap fitur yang ditransformasi.
Ide Margin Maksimum
Untuk klasifier biner linear, batas keputusan adalah sebuah hyperplane:
w · x + b = 0
Vektor w menentukan orientasi dan b menentukan offset. Banyak hyperplane dapat memisahkan kelas pelatihan. SVM memilih yang memaksimalkan jarak ke contoh terdekat di kedua sisi. Contoh terdekat tersebut adalah support vectors dan memiliki pengaruh terbesar pada batas yang dipasang.
Tujuannya bukan memaksimalkan jarak dari batas ke setiap titik secara independen. Ia memaksimalkan margin minimum sambil memenuhi atau memberi penalti pada kendala kelas.
Margin Keras dan Lunak
SVM margin keras memerlukan pemisahan linear yang sempurna dan sensitif terhadap outlier. Dataset nyata biasanya memerlukan soft margin, yang memperkenalkan variabel slack untuk observasi di dalam margin atau di sisi yang salah dari batas.
Hiparameter C mengontrol penalti untuk pelanggaran ini:
- C yang lebih besar memberi penalti lebih kuat pada pelanggaran dan sering menghasilkan margin yang lebih sempit yang mengikuti contoh pelatihan lebih dekat.
- C yang lebih kecil memungkinkan lebih banyak pelanggaran dengan imbalan margin yang lebih lebar dan lebih teratur.
Jumlah support vectors merupakan hasil dari data dan solusi; meningkatkan C tidak menjamin jumlah support vector tertentu.
Trik Kernel
Beberapa kelas tidak dapat dipisahkan dengan hyperplane lurus di ruang fitur asli. Kernel mengevaluasi produk dalam yang sesuai dengan ruang fitur lain. Hal ini memungkinkan SVM menyesuaikan batas non‑linear tanpa menghitung secara eksplisit setiap koordinat yang ditransformasi.
Kernel umum meliputi:
- Linear: efisien untuk fitur jarang berdimensi tinggi seperti teks.
- Polynomial: memodelkan interaksi hingga derajat yang dipilih.
- Radial basis function (RBF): menciptakan batas lokal yang fleksibel berdasarkan jarak.
- Sigmoid: mirip aktivasi neural namun jarang menjadi pilihan default.
Untuk RBF SVM, gamma mengontrol seberapa lokal setiap contoh pelatihan memengaruhi batas. Gamma besar dapat menghasilkan wilayah yang sangat detail dan overfit; gamma kecil menghasilkan pengaruh yang lebih halus.
Klasifikasi Multikelas
Tujuan klasik SVM bersifat biner. Pustaka memperluasnya menggunakan strategi seperti one-vs-rest, yang melatih satu classifier per kelas, atau one-vs-one, yang melatih classifier untuk pasangan kelas dan menggabungkan keputusannya. SVM multikelas tidak sekadar menggambar satu garis kurang dari jumlah kelas.
Regresi Vektor Pendukung dan SVM Satu Kelas
Regresi vektor pendukung (SVR) menyesuaikan fungsi sambil mengabaikan kesalahan di dalam tabung seluas epsilon dan memberi penalti pada deviasi yang lebih besar. SVM satu kelas memperkirakan batas di sekitar data tipikal dan dapat mendukung deteksi kebaruan. Titik yang tidak biasa tidak otomatis berarti penipuan atau kegagalan; ia tidak biasa berdasarkan representasi yang dipasang.
Persyaratan Praktis
SVM bergantung pada jarak dan produk dalam, sehingga fitur numerik umumnya memerlukan skala. C, kernel, gamma, dan bobot kelas harus dipilih melalui validasi. Estimasi probabilitas tidak melekat pada margin dan sering memerlukan kalibrasi, yang menambah biaya dan harus dievaluasi secara terpisah.
Pelatihan Kernel SVM dapat skala antara waktu kuadratik hingga kubik tergantung pada jumlah sampel, tergantung pada data dan implementasi. Varian Linear SVM atau model linear stokastik lebih cocok untuk dataset yang sangat besar. Untuk gambar mentah, audio, atau bahasa, representasi yang dipelajari dari deep learning mungkin lebih efektif, sementara SVM masih dapat mengklasifikasikan embedding tetap.
Kekuatan dan Keterbatasan SVM
SVM dapat bekerja baik dengan banyak fitur, menawarkan tujuan terregularisasi yang jelas, dan bergantung terutama pada support vectors saat prediksi. Keterbatasannya meliputi sensitivitas terhadap skala dan hyperparameter, pelatihan yang berpotensi mahal, interpretabilitas yang berkurang pada kernel non‑linear, serta kebutuhan kalibrasi probabilitas.
Margin, kernel, dan tujuan optimasi
Support vector machine mencari hyperplane pemisah dengan margin besar antara kelas. Hanya support vectors yang berada pada atau di dalam margin yang menentukan batas. SVM soft‑margin memperkenalkan slack untuk tumpang tindih dan titik yang salah label; parameter C menukar margin yang lebih lebar dengan pelanggaran pelatihan. Input biasanya harus di‑scale karena jarak dan produk titik menggerakkan solusi. Bobot kelas atau resampling membantu ketika biaya kesalahan dan prevalensi tidak seimbang, namun ambang dan probabilitas tetap memerlukan validasi independen.
Trik kernel mengevaluasi kesamaan seolah‑olah input dipetakan ke ruang fitur berdimensi lebih tinggi. Kernel linear, polinomial, radial‑basis, dan khusus menyandikan asumsi yang berbeda. Untuk kernel RBF, gamma mengontrol seberapa lokal setiap titik memengaruhi batas: gamma tinggi dapat menciptakan wilayah rumit dan overfit, sementara gamma rendah dapat underfit. Matriks kernel tumbuh secara kuadratik dengan jumlah sampel, menjadikan SVM non‑linear mahal pada dataset besar. Solver linear atau peta fitur aproksimasi sering lebih disukai pada skala besar.
Penggunaan Multikelas, Kalibrasi, dan Batas Operasional
SVM biner diperluas ke multikelas melalui one-vs-rest, one-vs-one, atau formulasi terstruktur. Hyperparameter harus disetel dalam cross‑validation, dengan pembagian berkelompok atau temporal bila diperlukan. Evaluasi presisi dan recall spesifik kelas, distribusi margin, kalibrasi, dan kinerja di bawah pergeseran. Skor keputusan mentah bukan probabilitas; Platt scaling atau kalibrasi isotonic menggunakan data terpisah dan dapat menurun jika prevalensi berubah. Bandingkan dengan regresi logistik, pohon, dan metode berbasis representasi modern dengan upaya pra‑pemrosesan dan penyetelan yang seimbang.
Penyajian memerlukan scaler yang tepat, urutan fitur, parameter kernel, support vectors, dan pemetaan kelas. Biaya prediksi untuk kernel SVM meningkat seiring jumlah support vectors, sehingga ukur latensi dan memori pada batch realistis. Input yang jauh dari support pelatihan masih dapat menerima label dengan keyakinan; tambahkan pemeriksaan out‑of‑distribution atau kebijakan abstain bila tepat. Periksa kesalahan untuk proksi sensitif dan artefak dataset. SVM tetap kuat untuk masalah berdimensi tinggi berukuran menengah, namun margin geometris maksimal bukan bukti struktur kausal atau keamanan.
Contoh Praktis: SVM untuk Pengarahan Dokumen Langka
Tim operasi hukum mengklasifikasikan pengajuan singkat ke dalam kategori pengarah menggunakan fitur TF–IDF dan linear SVM. Mereka membagi data berdasarkan urusan dan waktu untuk mencegah kebocoran template, menyesuaikan bobot kelas berdasarkan biaya kesalahan yang ditinjau, dan menyetel C dalam validasi berlapis. Model linear dibandingkan dengan regresi logistik dan transformer. Presisi, recall, kalibrasi per kelas, dan beban kerja reviewer lebih penting daripada akurasi keseluruhan.
Skor keputusan dikalibrasi pada data terpisah, dan dokumen dengan margin rendah atau bahasa yang tidak didukung dialihkan ke penanganan manual. Artefak penyajian mencakup tokenizer, kosakata, bobot, model, kalibrasi, dan peta label. Pemantauan melacak istilah baru, prevalensi kategori, margin, dan rute yang dikoreksi. Dokumen dan support vectors dilindungi karena fitur teks dapat mengungkap informasi rahasia. Kernel non‑linear ditolak ketika peningkatan kualitas kecilnya tidak dapat membenarkan biaya latensi, memori, dan interpretabilitas.
Bukti Implementasi dan Kesiapan Operasional
Keputusan produksi memerlukan lebih dari sekadar demonstrasi yang berhasil. Tentukan pengguna yang ditargetkan, lingkungan operasional, input, output, ketergantungan, pemilik, dan konsekuensi setiap kegagalan penting. Bangun baseline yang dapat direproduksi dan set evaluasi berversi sebelum penyetelan. Uji kasus biasa, kondisi batas, input yang rusak atau hilang, pergeseran distribusi, kegagalan ketergantungan, penyalahgunaan, serta grup atau lingkungan yang paling mungkin kurang terlayani. Ukur kualitas tugas bersama kalibrasi atau ketidakpastian, latensi, throughput, biaya sumber daya, aksesibilitas, privasi, dan keamanan. Catat setiap transformasi dan ambang sehingga peninjau independen dapat mereproduksi hasil dan membedakan bukti dari prototipe yang menarik.
Sebelum peluncuran, tetapkan otoritas untuk rilis, pengecualian, perubahan, rollback, dan pensiun. Gunakan rollout bertahap, pertahankan fallback yang aman, dan verifikasi pemantauan dengan kegagalan yang disuntikkan secara sengaja. Telemetri operasional harus mengungkap kualitas input, perilaku output, versi model atau aturan, kesehatan ketergantungan, intervensi manusia, dan hasil yang dikonfirmasi tanpa mengumpulkan data sensitif yang tidak diperlukan. Tentukan ambang peringatan dan pemilik respons, kemudian tinjau bukti dunia nyata setelah penerapan alih‑alih mengasumsikan kinerja offline akan bertahan. Evaluasi kembali setiap kali sumber data, pengguna, model, vendor, kebijakan, perangkat keras, atau tujuan berubah. Sistem yang dipelihara juga memerlukan dokumentasi pemulihan, pembelajaran insiden, prosedur penghapusan dan retensi, serta titik yang jelas kapan harus dinonaktifkan atau diganti.
Pertanyaan yang Sering Diajukan
Apakah SVM hanya melakukan klasifikasi?
Tidak. Regresi vektor pendukung memprediksi target kontinu, sementara SVM satu kelas dapat memperkirakan batas kebaruan. Setiap varian memiliki tujuan dan kumpulan hyperparameter yang berbeda.
Kapan Linear SVM menjadi pilihan yang kuat?
Linear SVM sering efektif untuk fitur jarang berdimensi tinggi, termasuk representasi teks tradisional, di mana kernel fleksibel akan menambah biaya tanpa manfaat yang jelas.
Referensi Utama