Dasar-dasar AI
Apa Itu Reduksi Dimensi?

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
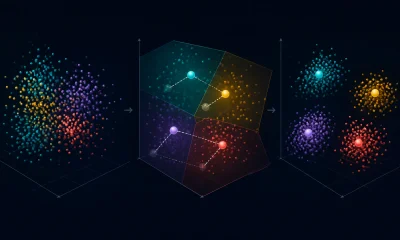
Reduksi dimensi merepresentasikan data dengan lebih sedikit variabel sambil mempertahankan informasi yang berguna untuk suatu tugas. Ini dapat mengurangi penyimpanan dan kebisingan, meningkatkan visualisasi, mengurangi fitur yang berulang, dan mempermudah pelatihan model selanjutnya.
Tidak ada metode yang dapat mempertahankan semua hubungan. Reduksi yang berguna dimulai dengan menentukan apa yang harus dipertahankan: varians, pemisahan kelas, lingkungan lokal, geometri global, kualitas rekonstruksi, atau interpretabilitas.
Poin-poin utama
- Seleksi fitur mempertahankan variabel asli; ekstraksi fitur menciptakan koordinat berdimensi lebih rendah yang baru.
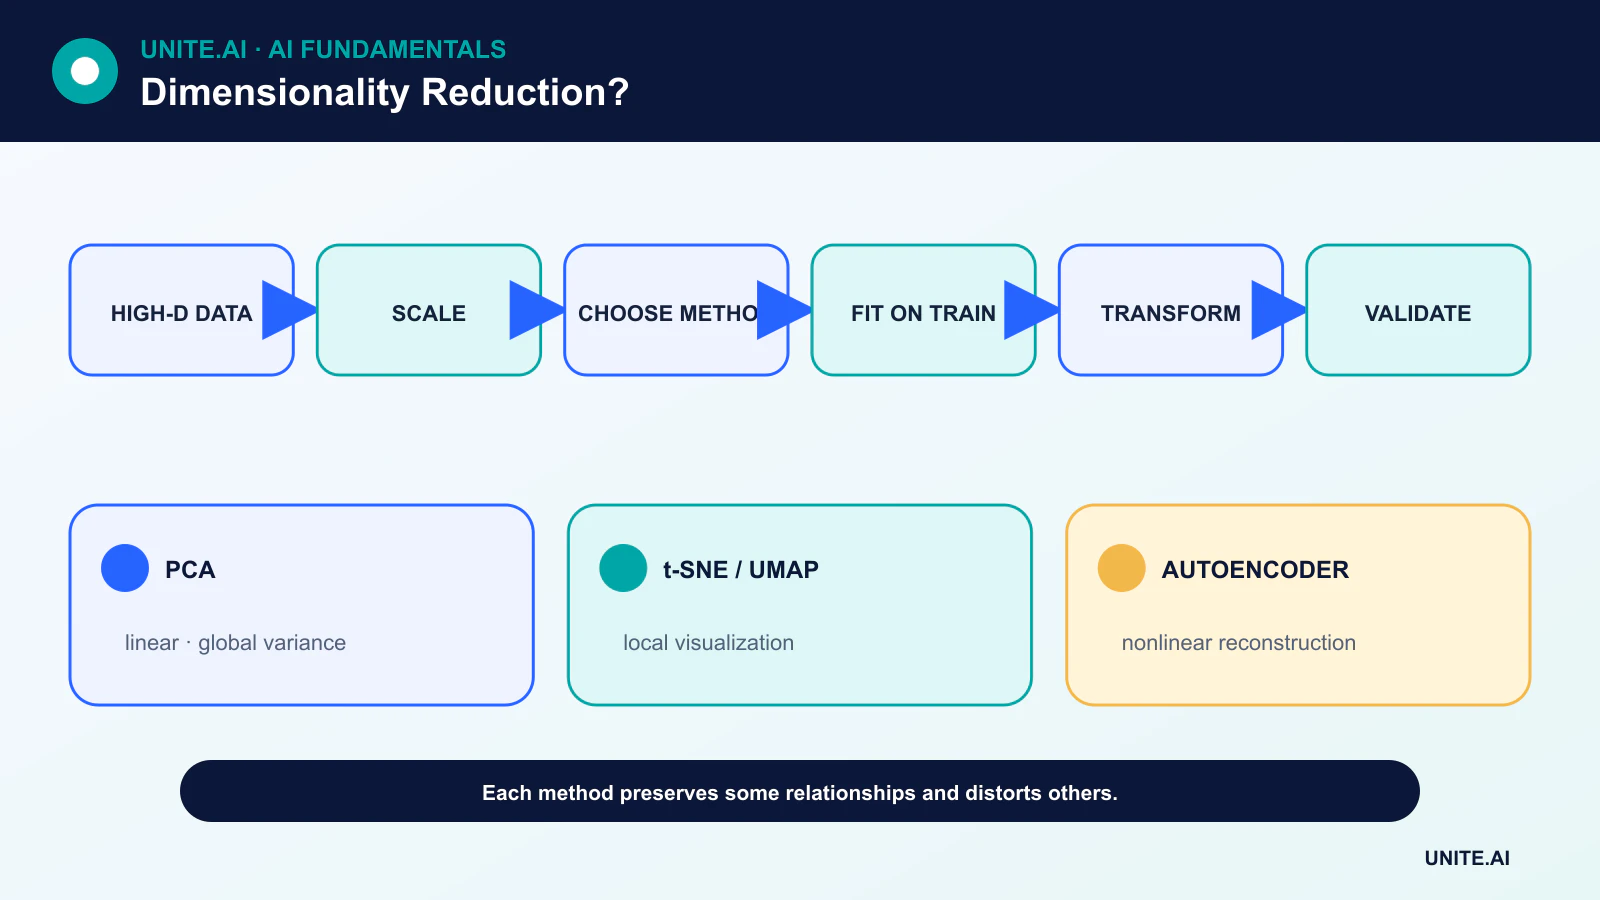
- PCA bersifat linear dan berfokus pada varians; t-SNE dan UMAP menekankan struktur lingkungan untuk visualisasi.
- Embedding visualisasi dapat mendistorsi jarak, ukuran klaster, dan pemisahan global.
- Lakukan reduksi hanya pada data pelatihan, kemudian terapkan transformasi yang dipelajari pada data validasi dan pengujian.
Seleksi fitur vs proyeksi
Seleksi fitur menghapus variabel menggunakan aturan domain, ketidakhadiran data, redundansi, uji prediktif, atau regularisasi. Ia mempertahankan makna asli, yang dapat membantu tata kelola dan penjelasan.
Metode proyeksi menggabungkan variabel menjadi koordinat baru. Mereka dapat menangkap struktur tersebar tetapi dapat membuat setiap koordinat lebih sulit diinterpretasikan. Sebuah autoencoder mempelajari proyeksi nonlinier melalui rekonstruksi.
PCA dan SVD
Analisis komponen utama mengidentifikasi arah ortogonal dengan varians menurun setelah memusatkan data. Singular value decomposition menyediakan jalur numerik umum. Skala penting: satuan pengukuran dengan varians tinggi dapat mendominasi komponen.
PCA bersifat deterministik hingga tanda dan nilai eigen yang berulang, mendukung transformasi di luar sampel, dan memberikan ringkasan varians yang dijelaskan. Varians tinggi tidak selalu relevan dengan tugas, dan komponen linear tidak dapat membuka setiap manifold melengkung.
t-SNE dan UMAP
t-SNE membangun distribusi probabilitas atas tetangga dan mengoptimalkan peta berdimensi rendah yang menekankan kemiripan lokal. UMAP membangun graf lingkungan berbobot dan mengoptimalkan representasi berdimensi lebih rendah dengan tujuan struktur lokal yang terkait.
Keduanya merupakan alat eksplorasi yang kuat namun sensitif terhadap pra‑pemrosesan, metrik jarak, dan hiperparameter. Ruang kosong, area klaster, dan jarak antar‑klaster dalam plot 2D tidak boleh secara otomatis diartikan secara dunia nyata.
Metode terawasi dan representasi sadar tugas
Analisis diskriminan linear menggunakan label kelas untuk mencari pemisahan, menjadikannya berbeda dari PCA tak terawasi. Pembelajaran representasi neural dapat mengoptimalkan prediksi atau tujuan kontras alih‑alih rekonstruksi.
Jika label memandu reduksi, semua proses fitting dan penyesuaian harus tetap berada dalam proses pelatihan. Jika tidak, informasi dari set pengujian dapat bocor ke pemilihan model dan menghasilkan hasil yang terlalu optimis.
Memilih dan memvalidasi metode
Mulailah dengan pra‑pemrosesan dan baseline sederhana. Untuk kompresi, ukur rekonstruksi atau kinerja downstream pada berbagai dimensi. Untuk visualisasi, uji stabilitas pada berbagai seed dan hiperparameter serta bandingkan pelestarian lingkungan dengan pengetahuan domain.
Untuk produksi, tanyakan apakah metode dapat mentransformasi catatan baru, bagaimana ia menangani nilai yang hilang, apakah ia berubah saat dilatih ulang, dan apakah pengguna memerlukan penjelasan fitur asli. Overfitting dapat terjadi pada langkah reduksi sama seperti pada model akhir.
Metode reduksi linear dan nonlinier
Reduksi dimensi memetakan data berdimensi tinggi ke koordinat lebih sedikit sambil mempertahankan struktur terpilih. Analisis komponen utama menemukan arah ortogonal dengan varians maksimum setelah memusatkan; skala diperlukan ketika satuan harus berkontribusi secara sebanding. Singular value decomposition menghitung struktur berperingkat rendah yang terkait dan mendukung matriks jarang. Analisis diskriminan linear menggunakan label untuk menemukan arah pemisahan kelas. Metode‑metode ini menghasilkan transformasi eksplisit, tetapi varians atau pemisahan kelas mungkin tidak mempertahankan informasi yang diperlukan untuk tugas downstream.
Metode manifold seperti t‑SNE dan UMAP membangun lingkungan dan mengoptimalkan tata letak berdimensi rendah. Mereka kuat untuk eksplorasi namun mendistorsi jarak global, kepadatan, ukuran klaster, dan kadang‑kadang pemisahan. Hasil bergantung pada pra‑pemrosesan, metrik, tetangga atau perplexity, inisialisasi, dan seed. Klaster yang menarik dalam dua dimensi dapat muncul meski tanpa grup diskrit. Gunakan banyak pengaturan, warnai hanya dengan metadata yang tidak dipakai dalam fitting, dan validasi struktur yang tampak di ruang asli atau dengan label independen.
Seleksi fitur, embedding, dan evaluasi
Seleksi fitur mempertahankan variabel asli melalui filter, wrapper, atau pentingnya berbasis model; pembelajaran representasi menciptakan fitur laten baru menggunakan autoencoder atau model terawasi. Proyeksi acak mempertahankan jarak secara perkiraan di bawah kondisi tertentu dan menawarkan baseline yang efisien. Pilih metode berdasarkan kompresi, visualisasi, pengurangan kebisingan, kecepatan, penyimpanan, atau kinerja model. Lakukan fitting reducer hanya pada data pelatihan, kemudian transformasi set validasi dan pengujian. Reduksi terawasi harus bersarang dalam cross‑validation untuk menghindari kebocoran label.
Evaluasi varians yang dijelaskan atau rekonstruksi untuk kompresi linear, kepercayaan dan pelestarian lingkungan untuk visualisasi, serta akurasi downstream, kalibrasi, latensi, dan ketahanan untuk prediksi. Ukur stabilitas pada sampel dan seed. Periksa apakah kelas langka atau grup sensitif terkompresi dan apakah pemetaan invers dapat dilakukan. Koordinat yang direduksi masih dapat berisi informasi pribadi; plot dua dimensi bukan anonimisasi. Dokumentasikan transformasi, scaler, urutan fitur, dan keterbatasannya.
Penggunaan produksi
Penyajian memerlukan transformasi terpasang yang tepat dan skema input. Pantau fitur yang hilang, pergeseran rentang, distribusi skor komponen, kesalahan rekonstruksi, dan hasil downstream. Jika kategori atau sensor baru muncul, latih ulang dan versi seluruh pipeline alih‑alih menambahkan kolom secara diam‑diam. Reduksi dapat meningkatkan komputasi dan mengurangi kebisingan model, tetapi juga dapat menghilangkan sinyal lemah yang penting bagi peristiwa langka. Perlakukan sebagai langkah pengukuran yang dipelajari di mana informasi yang dipertahankan dan yang hilang harus diuji terhadap keputusan.
Contoh kerja: mengurangi fitur perilaku pelanggan
Seorang analis menstandarkan 200 ukuran perilaku dan melakukan PCA hanya pada pelanggan pelatihan. Cross‑validation memilih jumlah komponen berdasarkan kinerja churn downstream dan stabilitas, bukan scatterplot dua dimensi. Loading diperiksa untuk sumber yang dominan dan ketidakhadiran data. PCA, seleksi fitur, proyeksi acak, dan model reguler yang tidak direduksi dibandingkan pada kalibrasi, latensi, dan hasil untuk segmen pelanggan langka. Sampel berulang juga menguji apakah komponen utama dan kesimpulan downstream tetap stabil.
Pipeline yang diterapkan memperbaiki urutan fitur, scaler, dan komponen serta menolak versi skema yang hilang. Pemantauan melacak distribusi komponen, kesalahan rekonstruksi, dan hasil downstream. Visualisasi dengan klaster yang tampak digunakan untuk menghasilkan pertanyaan, bukan untuk menetapkan persona pelanggan. Karena komponen laten masih mengkode perilaku, akses dan retensi tetap terkendali. Jika definisi sumber berubah, transformasi dan model lengkap dibangun ulang dan divalidasi alih‑alih memproyeksikan data yang tidak cocok ke komponen lama.
Bukti implementasi dan kesiapan operasional
Keputusan produksi membutuhkan lebih dari demonstrasi yang berhasil. Tentukan pengguna yang dituju, lingkungan operasi, masukan, keluaran, ketergantungan, pemilik, dan konsekuensi dari setiap kegagalan penting. Bangun baseline yang dapat direproduksi dan set evaluasi berversi sebelum penyetelan. Uji kasus biasa, kondisi batas, input yang rusak atau hilang, pergeseran distribusi, kegagalan ketergantungan, penyalahgunaan, dan grup atau lingkungan yang paling mungkin kurang terlayani. Ukur kualitas tugas bersama dengan kalibrasi atau ketidakpastian, latensi, throughput, biaya sumber daya, aksesibilitas, privasi, dan keamanan. Catat setiap transformasi dan ambang batas sehingga peninjau independen dapat mereproduksi hasil dan membedakan bukti dari prototipe yang menarik.
Sebelum peluncuran, tetapkan otoritas untuk rilis, pengecualian, perubahan, rollback, dan pensiun. Gunakan peluncuran bertahap, pertahankan fallback yang aman, dan verifikasi pemantauan dengan kegagalan yang disuntikkan secara sengaja. Telemetri operasional harus mengungkap kualitas masukan, perilaku keluaran, versi model atau aturan, kesehatan ketergantungan, intervensi manusia, dan hasil yang dikonfirmasi tanpa mengumpulkan data sensitif yang tidak diperlukan. Tentukan ambang batas peringatan dan pemilik respons, lalu tinjau bukti dunia nyata setelah deployment alih‑alih mengasumsikan kinerja offline akan bertahan. Evaluasi kembali setiap kali sumber data, pengguna, model, vendor, kebijakan, perangkat keras, atau tujuan berubah. Sistem yang dipelihara juga memerlukan dokumentasi pemulihan, pembelajaran insiden, prosedur penghapusan dan retensi, serta titik yang jelas di mana ia harus dinonaktifkan atau diganti.
Pertanyaan yang sering diajukan
Apakah reduksi dimensi selalu meningkatkan model?
Tidak. Itu dapat menghilangkan informasi prediktif atau mempersulit interpretasi. Bandingkan dengan baseline tanpa reduksi pada data yang dipisahkan.
Apakah klaster t-SNE yang terpisah membuktikan keberadaan kelas nyata?
Tidak. Peta tersebut merupakan visualisasi teroptimasi dari hubungan lingkungan dan dapat menciptakan pemisahan yang tampak. Validasi klaster dengan bukti independen.
Referensi utama