
Dasar-dasar AI
Apa Itu Pembelajaran Few-Shot?

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
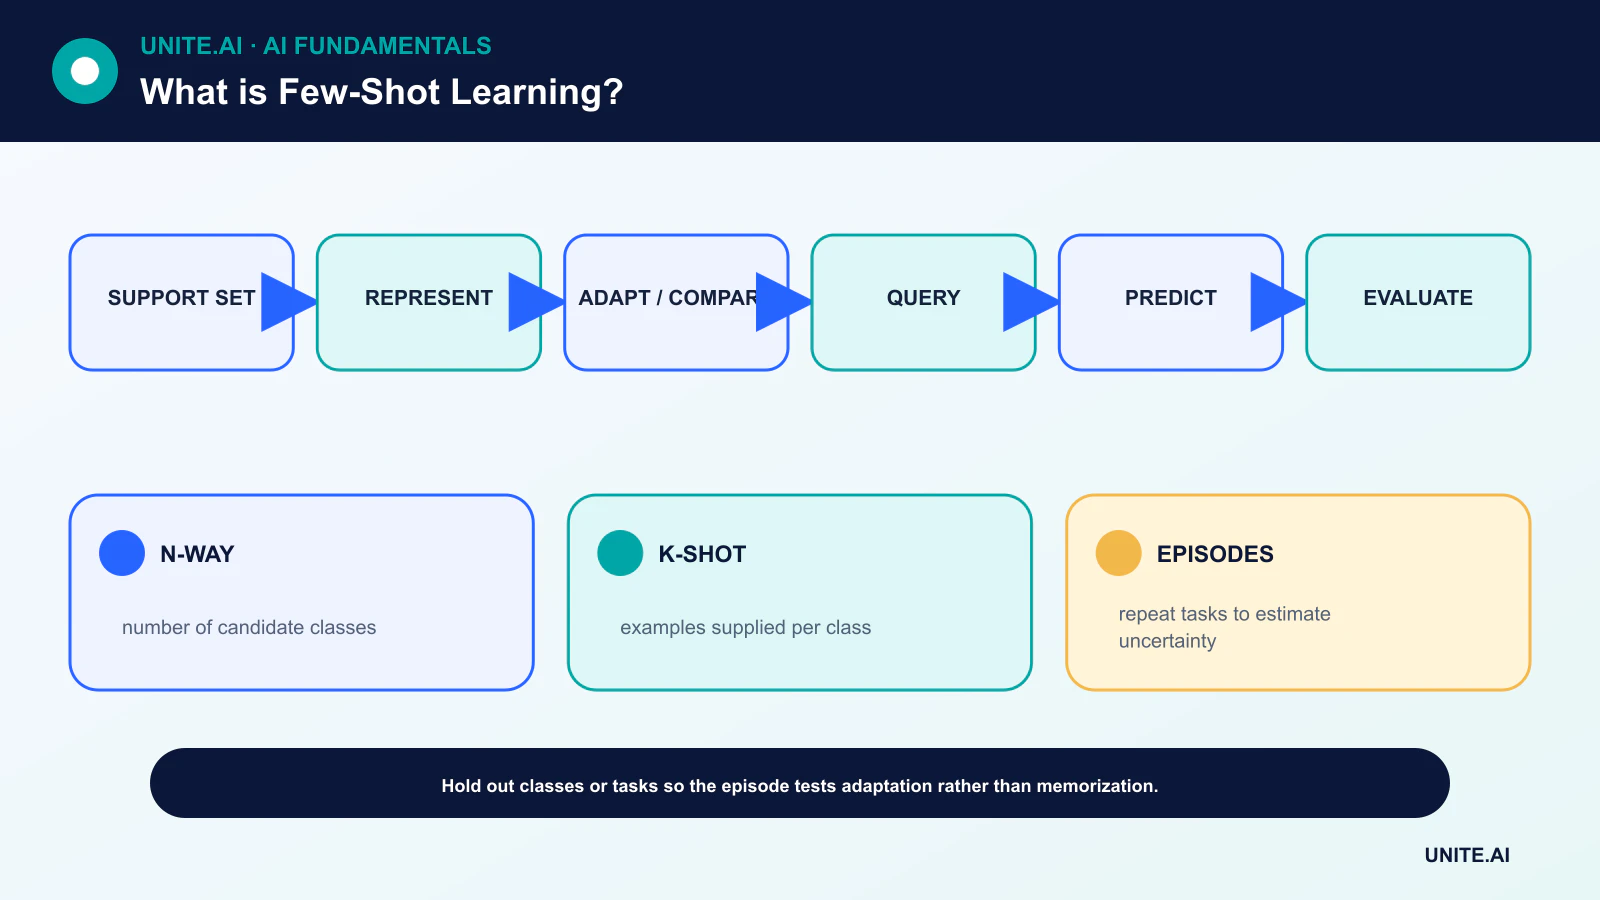
Few-shot learning mempelajari bagaimana sebuah model dapat beradaptasi ke tugas atau kelas baru hanya dengan sejumlah kecil contoh berlabel. Pada benchmark klasik, sebuah episode menyediakan set dukungan—misalnya lima kelas dengan satu atau lima contoh per kelas—dan meminta model mengklasifikasikan kueri yang belum terlihat.
Istilah ini juga digunakan untuk pembelajaran dalam konteks, di mana model bahasa yang telah dilatih sebelumnya menerima beberapa demonstrasi dalam promptnya tanpa memperbarui parameter. Pengaturan ini memiliki tujuan dengan contoh sedikit tetapi menggunakan mekanisme adaptasi yang berbeda dan memerlukan desain evaluasi yang berbeda.
Poin-poin Utama
- N-way K-shot menggambarkan N kelas dan K contoh dukungan berlabel per kelas.
- Metode metric-learning membandingkan kueri dengan representasi yang dipelajari dari contoh dukungan.
- Meta-learning mengoptimalkan lintas banyak tugas sehingga tugas baru dapat dipelajari dengan cepat.
- Beberapa contoh memperbesar kesalahan label, kebocoran, ambiguitas kelas, dan ketidakpastian, sehingga baseline dan pelaporan kepercayaan menjadi penting.
Episode, Set Dukungan, dan Set Kueri
Sebuah episode few-shot memisahkan set dukungan berlabel kecil dari set kueri yang digunakan untuk evaluasi. Selama meta-pelatihan, model melihat banyak episode semacam itu. Evaluasi yang kuat menahan seluruh kelas, tugas, atau domain sehingga episode pengujian mengukur adaptasi bukan menghafal.
Laporkan distribusi akurasi di banyak episode daripada satu sampel yang nyaman. Bandingkan dengan baseline tetangga terdekat sederhana dan linier; metode canggih yang tidak dapat mengalahkan representasi terlatih baik ditambah classifier dasar mungkin tidak membenarkan kompleksitasnya.
Pembelajaran Metric dan Prototipe
Jaringan pencocokan (matching networks) dan metode terkait menyematkan contoh dukungan dan kueri ke dalam ruang di mana vektor yang berdekatan seharusnya berbagi label. Jaringan prototipikal (prototypical networks) merata-ratakan embedding dukungan untuk setiap kelas dan mengklasifikasikan kueri berdasarkan jarak dari prototipe kelas tersebut.
Ini menghubungkan pembelajaran few-shot dengan kualitas representasi. Model deep-learning yang telah dilatih sebelumnya mungkin sudah mengatur fitur relevan dengan baik, sementara representasi yang tidak cocok dapat membuat setiap jarak menyesatkan.
Meta-Learning Berbasis Optimisasi
Model-Agnostic Meta-Learning (MAML) mencari parameter yang dapat beradaptasi dengan sejumlah kecil langkah gradien. Metode lain mempelajari optimizer, inisialisasi, atau aturan pembaruan parameter. Loop luar mengevaluasi kinerja setelah adaptasi lintas tugas.
Meta-learning mengasumsikan struktur yang berguna dibagikan antara tugas pelatihan dan tugas target. Ketika distribusi target sangat berbeda, adaptasi cepat dapat gagal. Validasi harus memvariasikan jumlah contoh (shots), kelas, domain, dan kesulitan tugas alih-alih menganggap satu benchmark sebagai universal.
Transfer Learning dan Strategi Tingkat Data
Transfer learning sering menjadi titik awal praktis yang paling kuat: bekukan encoder yang telah dilatih sebelumnya, latih kepala (head) kecil, lalu fine-tune secara selektif jika data cukup ada. Augmentasi data dapat memperkenalkan invarian, tetapi contoh sintetis yang tidak realistis dapat memperkuat bias atau menciptakan jalan pintas.
Active learning dapat memprioritaskan contoh mana yang harus dilabeli, sementara semi-supervised learning dapat menggunakan data tak berlabel tambahan. Ini adalah strategi pelengkap, bukan sinonim untuk pembelajaran few-shot.
Prompting Few-Shot Berbeda
Sebuah transformer dapat menyimpulkan pola dari demonstrasi yang ditempatkan dalam konteksnya. Tidak diperlukan pembaruan parameter yang persisten. Urutan, pemilihan kata, dan keseimbangan label dapat secara material mengubah output, dan contoh dapat menghabiskan sebagian besar jendela konteks.
Gunakan set evaluasi yang representatif, versi setiap prompt dan demonstrasi, serta uji alternatif zero-shot, few-shot, dan fine-tuned. Set dukungan yang sangat kecil tidak mendukung klaim kuat untuk seluruh populasi, terutama untuk kasus langka atau kritis terhadap keselamatan.
Paradigma Pembelajaran Few-Shot dan Konstruksi Tugas
Pembelajaran few-shot bertujuan menyelesaikan tugas dengan sangat sedikit contoh berlabel. Pada metode berbasis metric, encoder memetakan contoh ke dalam ruang di mana prototipe atau tetangga terdekat mewakili kelas. Meta-learning berbasis optimisasi melatih inisialisasi atau aturan pembaruan untuk adaptasi cepat. Transfer learning melakukan fine-tune model yang telah dilatih sebelumnya pada set target kecil. Pembelajaran dalam konteks menyediakan contoh dalam prompt tanpa memperbarui bobot. Mekanisme ini berbeda, sehingga klaim harus menyebutkan apakah parameter berubah, pelatihan sebelumnya apa yang terjadi, dan bagaimana contoh dipilih.
Evaluasi harus memisahkan kelas, tugas, subjek, atau domain pelatihan dan pengujian sesuai dengan generalisasi yang diklaim. Sebuah episode N-way K-shot berisi N kelas dan K contoh dukungan per kelas, ditambah contoh kueri untuk penilaian. Episode berulang memperkirakan varians dari pemilihan dukungan. Untuk prompting, urutan contoh, pemilihan kata label, format, dan kesamaan demonstrasi dapat secara material mengubah hasil. Bandingkan dengan baseline zero-shot, nearest-neighbor, linear-probe, dan fine-tuning biasa menggunakan representasi dan anggaran data yang sama.
Kualitas Data, Ketidakpastian, dan Transfer Negatif
Dengan sedikit contoh, kasus yang salah label atau tidak tipikal memiliki pengaruh berlebih. Tentukan aturan anotasi, inspeksi setiap item dukungan, dan pertahankan hasil ‘tidak diketahui’ atau ‘menolak’. Augmentasi data dan contoh sintetis dapat membantu hanya bila mereka mempertahankan tugas dan menambahkan variasi realistis. Model yang telah dilatih sebelumnya dapat mentransfer jalan pintas atau bias dari domain sumbernya. Uji kasus di luar domain, kelompok langka, dan sensitivitas terhadap penghapusan satu contoh dukungan. Laporkan interval kepercayaan lintas tugas dan seed acak, bukan satu prompt yang menguntungkan.
Active learning dapat meminta label pada kasus informatif, sementara metode semi-supervised menggunakan data tak berlabel dengan asumsi tambahan. Retrieval dapat memilih demonstrasi relevan secara dinamis tetapi harus menghindari kebocoran label pada pengujian. Adaptasi dapat overfit dengan cepat, sehingga batasi pembaruan, gunakan regularisasi, dan validasi pada contoh terpisah. Untuk tugas berisiko tinggi, beberapa label jarang membenarkan keputusan otonom; gunakan model untuk memprioritaskan atau membantu peninjauan hingga bukti hasil yang cukup ada.
Operasi Produksi
Versikan model dasar, embedding atau templat prompt, demonstrasi, skema label, dan parameter adaptasi. Lindungi contoh karena prompt atau gradien dapat mengungkapkan catatan sensitif. Pantau kinerja seiring perubahan kelas dan bahasa, serta segarkan contoh dukungan melalui tinjauan yang diatur alih-alih pelabelan otomatis. Pembelajaran few-shot mengurangi kebutuhan target berlabel dengan memanfaatkan struktur sebelumnya; namun tidak menghilangkan kebutuhan akan evaluasi representatif, definisi tugas yang cermat, keahlian domain, atau fallback aman ketika tugas baru berada di luar pengetahuan tersebut.
Contoh Praktis: Klasifikasi Few-Shot untuk Produk Baru
Tim dukungan membutuhkan label routing untuk sebuah produk dengan hanya lima contoh yang ditinjau per masalah. Mereka membandingkan prototipe terdekat dalam embedding yang telah dilatih sebelumnya, kepala linier, fine-tuning efisien parameter, dan prompting dalam konteks. Keluarga produk, pelanggan, dan pesan selanjutnya dikeluarkan dari meta-pelatihan dan pemilihan model. Pengambilan sampel set dukungan berulang melaporkan recall kelas, kalibrasi, varians, dan sensitivitas terhadap satu demonstrasi yang salah label.
Pesan dengan kepercayaan rendah dan tidak didukung diarahkan ke dukungan umum, dan peninjau memperbaiki label melalui antrian yang diatur. Contoh di-de-identifikasi, diberi versi, dan tidak pernah dipilih dari set pengujian akhir. Pemantauan melacak kosakata baru, tingkat kelas, koreksi, dan ketidaksepakatan. Ketika cukup label terkumpul, sistem few-shot dibandingkan dengan pelatihan supervised biasa. Penyiapan cepat berguna, tetapi tidak membenarkan otomatisasi jika kinerja tetap tidak stabil atau jika produk baru sangat berbeda dari keluarga tugas sebelumnya.
Bukti Implementasi dan Kesiapan Operasional
Keputusan produksi memerlukan lebih dari sekadar demonstrasi yang berhasil. Tentukan pengguna yang dituju, lingkungan operasi, masukan, keluaran, ketergantungan, pemilik, dan konsekuensi dari setiap kegagalan penting. Bangun baseline yang dapat direproduksi dan set evaluasi berversi sebelum penyetelan. Uji kasus biasa, kondisi batas, masukan yang rusak atau hilang, pergeseran distribusi, kegagalan ketergantungan, penyalahgunaan, serta kelompok atau lingkungan yang paling mungkin kurang terlayani. Ukur kualitas tugas bersama dengan kalibrasi atau ketidakpastian, latensi, throughput, biaya sumber daya, aksesibilitas, privasi, dan keamanan. Catat setiap transformasi dan ambang batas sehingga peninjau independen dapat mereproduksi hasil dan membedakan bukti dari prototipe yang menarik.
Sebelum peluncuran, tetapkan otoritas untuk rilis, pengecualian, perubahan, rollback, dan pensiun. Gunakan peluncuran bertahap, pertahankan fallback yang aman, dan verifikasi pemantauan dengan kegagalan yang disuntikkan secara sengaja. Telemetri operasional harus mengungkapkan kualitas masukan, perilaku keluaran, versi model atau aturan, kesehatan ketergantungan, intervensi manusia, dan hasil yang dikonfirmasi tanpa mengumpulkan data sensitif yang tidak diperlukan. Tentukan ambang batas peringatan dan pemilik respons, kemudian tinjau bukti dunia nyata setelah penerapan alih-alih mengasumsikan kinerja offline akan bertahan. Evaluasi kembali setiap kali sumber data, pengguna, model, vendor, kebijakan, perangkat keras, atau tujuan berubah. Sistem yang dipelihara juga memerlukan prosedur pemulihan, pembelajaran insiden, penghapusan dan retensi yang terdokumentasi, serta titik jelas di mana sistem harus dinonaktifkan atau diganti.
Pertanyaan yang Sering Diajukan
Apakah one-shot learning sama dengan few-shot learning?
One-shot learning adalah kasus khusus dengan satu contoh dukungan berlabel per kelas atau tugas. Zero-shot learning tidak menggunakan contoh target berlabel sama sekali.
Apakah pembelajaran few-shot menghilangkan kebutuhan akan data?
Tidak. Ini mengalihkan ketergantungan ke data pra-pelatihan, tugas terkait, representasi, dan asumsi. Label target sedikit; sejarah pembelajaran secara keseluruhan biasanya besar.
Referensi Utama












