Dasar-dasar AI
Apa Itu Pembelajaran Mendalam?

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
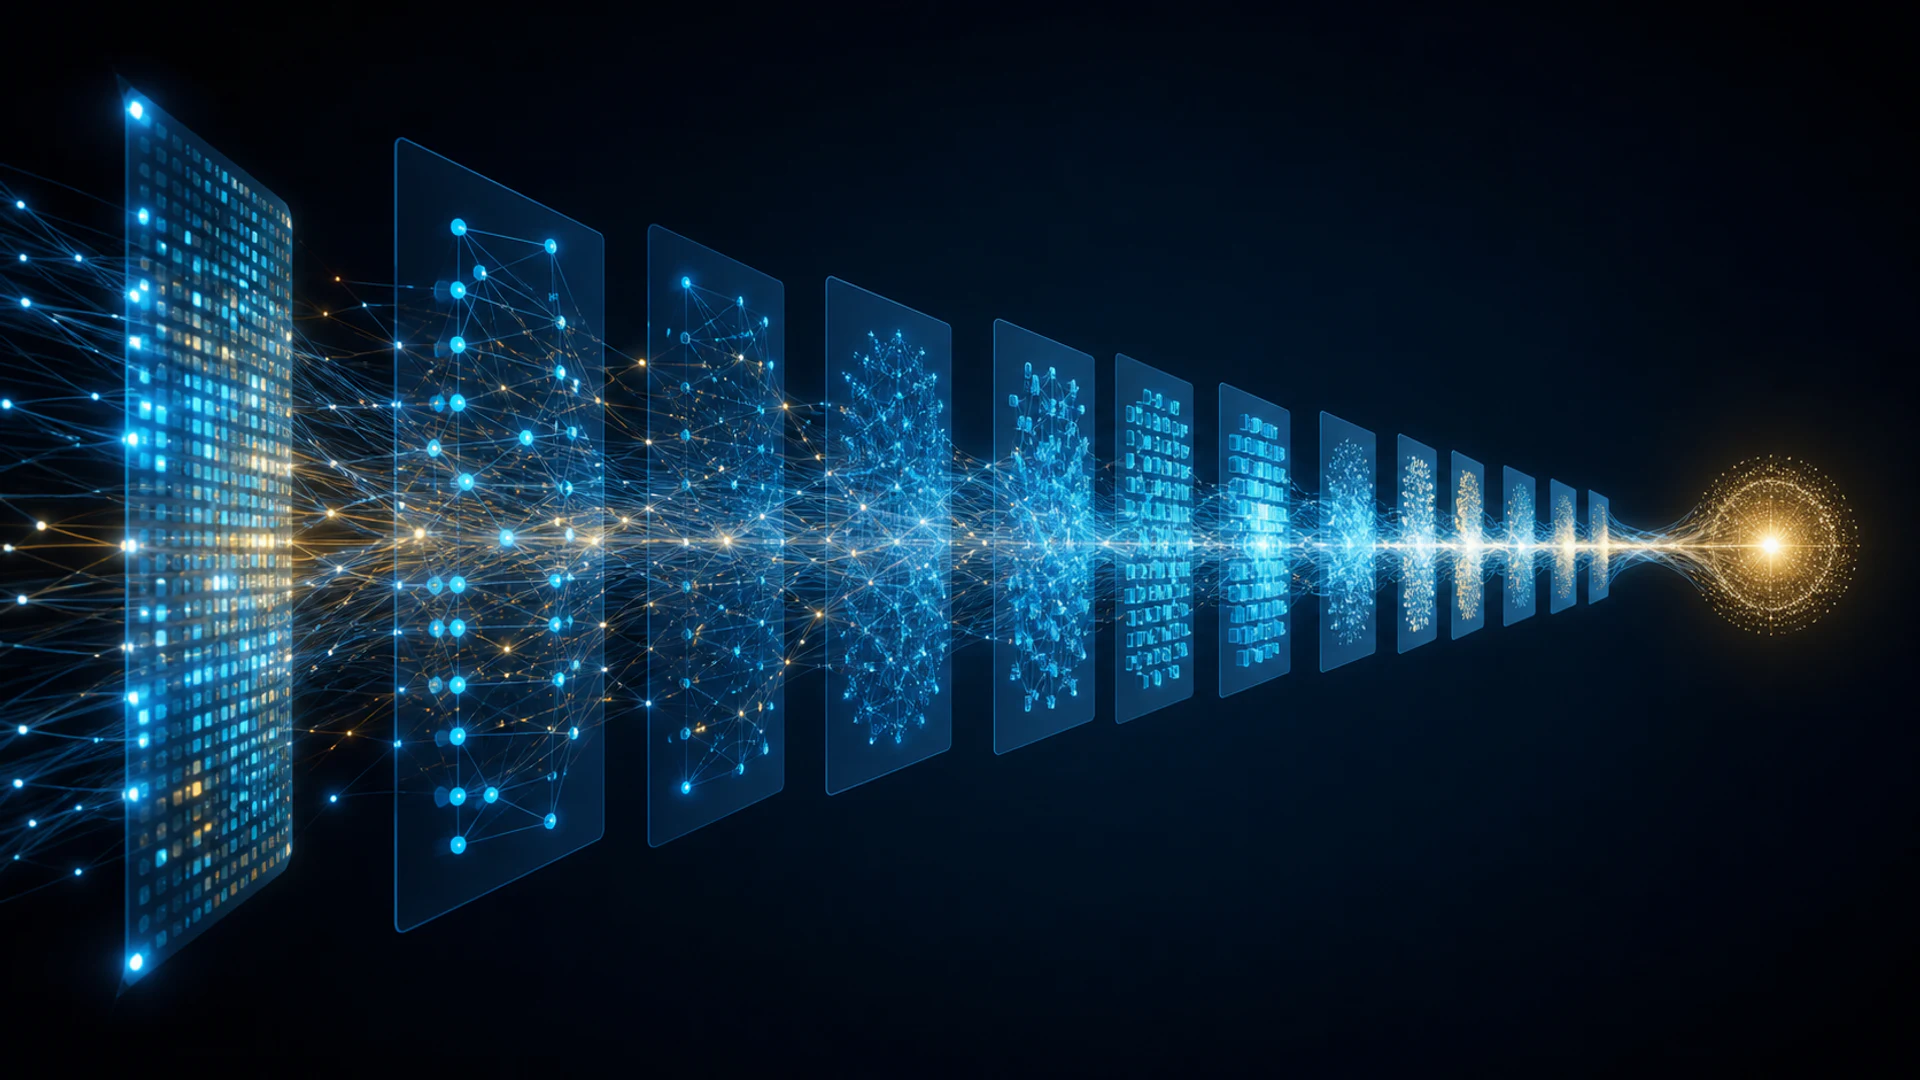
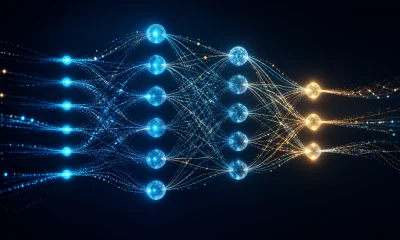
Deep learning adalah sekumpulan metode pembelajaran mesin yang menggunakan jaringan saraf dengan banyak lapisan pemrosesan untuk mempelajari representasi data yang berguna. Model-model ini mendukung banyak sistem modern untuk bahasa, gambar, audio, rekomendasi, prediksi ilmiah, dan AI generatif.
Kata deep mengacu pada jumlah transformasi antara input dan output, bukan pada mesin yang memiliki pemahaman lebih dalam. Model deep mempelajari hubungan numerik yang berguna untuk tujuan pelatihannya, dan kinerjanya tetap harus diuji pada data baru.
Poin-poin Penting
- Deep learning merupakan subset dari pembelajaran mesin.
- Lapisan mengubah tensor menggunakan parameter yang dipelajari, aktivasi nonlinier, normalisasi, dan operasi lainnya.
- Backpropagation menghitung gradien; optimizer menggunakan gradien tersebut untuk memperbarui parameter yang dapat dilatih, termasuk bobot dan bias.
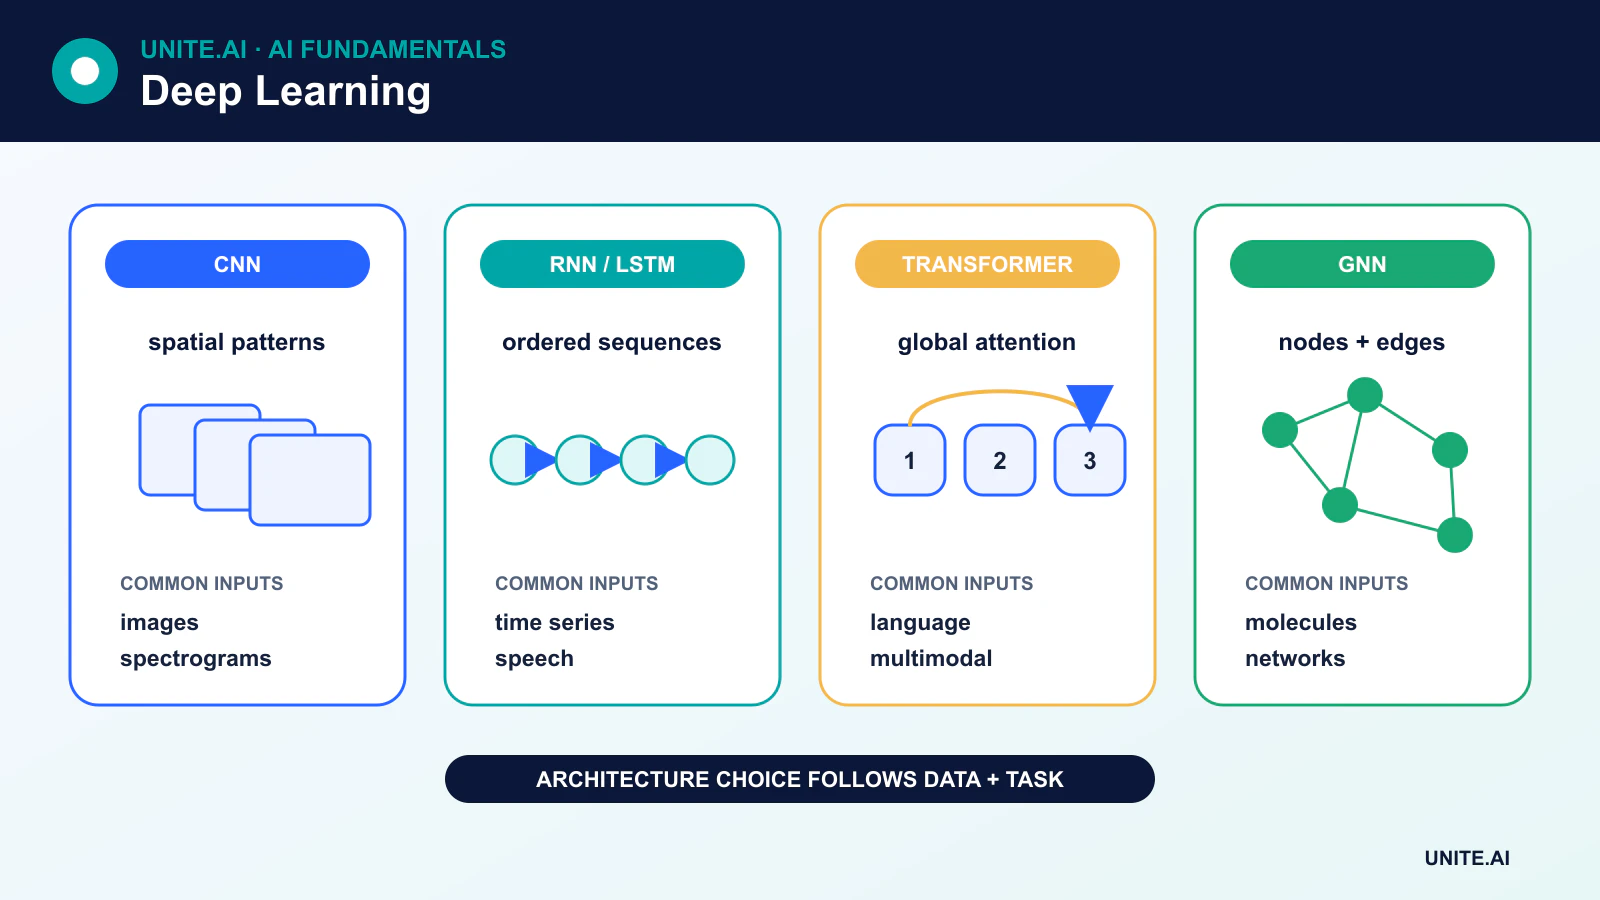
- CNN, jaringan berulang, transformer, autoencoder, dan model difusi memiliki struktur dan keunggulan yang berbeda.
Bagaimana Jaringan Saraf Deep Belajar
Jaringan saraf menerima data sebagai tensor, atau array multidimensi berisi angka. Tensor gambar dapat menyandikan saluran piksel, sementara model bahasa menggunakan vektor yang mewakili token. Setiap lapisan melakukan transformasi yang dapat diturunkan dan meneruskan hasilnya ke lapisan berikutnya.
Pada lapisan padat dasar, model menghitung jumlah berbobot dari inputnya, menambahkan bias yang dapat dilatih, lalu menerapkan fungsi aktivasi:
output = activation(Wx + b)
Fungsi aktivasi memperkenalkan nonlinieritas. Tanpa fungsi ini, menumpuk lapisan linear biasa tetap hanya menghasilkan transformasi linear. ReLU dan variannya umum digunakan pada lapisan tersembunyi, sementara aktivasi output bergantung pada tugas.
Pelatihan biasanya mengikuti empat langkah:
- Pass maju menghasilkan prediksi.
- Fungsi loss mengukur sejauh mana prediksi berbeda dari tujuan.
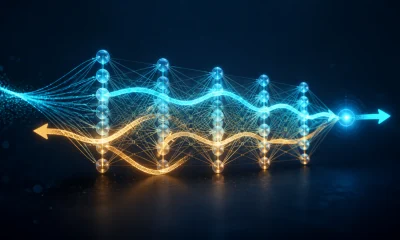
- Backpropagation menerapkan aturan rantai untuk menghitung gradien loss terhadap setiap parameter yang dapat dilatih.
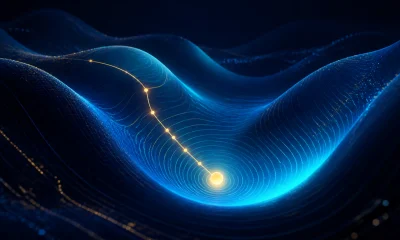
- Optimizer seperti stochastic gradient descent atau AdamW memperbarui parameter-parameter tersebut.
Mengulang langkah-langkah ini pada banyak batch dapat meningkatkan model, namun loss pelatihan yang lebih rendah tidak menjamin perilaku yang andal di dunia nyata. Validasi, regularisasi, data representatif, dan pemantauan tetap penting.
Arsitektur Deep Learning Utama
Multilayer Perceptron
Multilayer perceptron (MLP) menggunakan lapisan yang sepenuhnya terhubung di mana setiap unit output bergantung pada semua input dari lapisan sebelumnya. MLP berguna untuk fitur tabular dan sebagai komponen dalam sistem yang lebih besar, namun tidak mengasumsikan lokalitas gambar atau urutan urutan.
Jaringan Saraf Konvolusional
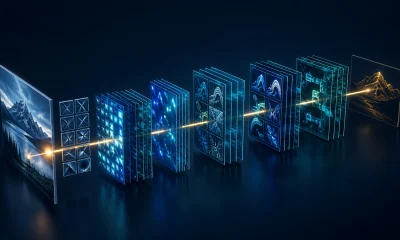
Jaringan saraf konvolusional (CNN) menerapkan filter yang dipelajari pada wilayah lokal. Pembagian bobot membuatnya efisien untuk grid seperti gambar dan spektrogram. CNN tetap penting untuk visi dan penyebaran di tepi, meskipun vision transformer dan model hibrida juga banyak digunakan.
Jaringan Berulang, LSTM, dan GRU
Jaringan saraf berulang (RNN) memperbarui keadaan tersembunyi saat urutan diproses. LSTM dan gated recurrent unit membantu mempertahankan informasi serta mengurangi masalah gradien menghilang yang membuat RNN dasar kesulitan dengan ketergantungan panjang. Mereka tidak menghilangkan semua keterbatasan konteks panjang, namun tetap berguna untuk sinyal streaming, data deret waktu, dan model berurutan yang kompak.
Transformer
Transformer menggunakan attention untuk memodelkan hubungan antar elemen dalam urutan atau kumpulan. Kemampuannya memproses banyak posisi secara paralel membantu menggantikan rekursi pada kebanyakan sistem bahasa berskala besar, dan varian transformer kini memproses gambar, audio, video, protein, serta data multimodal.
Autoencoder dan Model Generatif
Autoencoder mengompresi input menjadi representasi dan merekonstruksi input dari representasi tersebut. Ini menciptakan tujuan rekonstruksi self-supervised; tidak secara otomatis mengubah data tak berlabel menjadi contoh berlabel.
Generative adversarial networks melatih generator dan discriminator secara kompetitif. Model difusi belajar membalikkan proses penambahan noise secara bertahap. Transformer autoregresif menghasilkan satu token atau unit pada satu waktu. Pendekatan-pendekatan ini memiliki dinamika pelatihan, kontrol, dan kebutuhan komputasi yang berbeda.
Mengapa Kedalaman Membantu—dan Mengapa Arsitektur Penting
Beberapa lapisan memungkinkan model menggabungkan transformasi sederhana menjadi yang lebih kompleks. Pada visi, beberapa fitur yang dipelajari dapat berkembang dari tekstur lokal menuju pola khusus tugas. Pada bahasa, lapisan attention membangun representasi token yang bergantung pada konteks. Deskripsi ini merupakan intuisi yang berguna, bukan aturan baku tentang apa yang harus dipelajari setiap lapisan.
Jaringan modern juga mengandalkan koneksi residual, normalisasi, inisialisasi hati-hati, regularisasi, dan perangkat keras yang dioptimalkan. Menambahkan lapisan atau parameter secara sembarangan dapat membuat model lebih sulit dilatih, lebih lambat, atau lebih rentan terhadap overfitting. Skala model hanya membantu bila data, tujuan, optimisasi, dan lingkungan penyebaran mendukungnya.
Pelatihan vs Inferensi
Pelatihan menyesuaikan parameter dan biasanya merupakan tahap yang intensif komputasi. Inferensi menjalankan model terlatih untuk menghasilkan output. Inferensi masih dapat mahal untuk model besar, itulah mengapa tim menggunakan kuantisasi, distilasi, batching, caching, sparsity, dan perangkat keras khusus seperti neural processing unit.
Keterbatasan dan Penggunaan yang Bertanggung Jawab
Model deep dapat mewarisi bias, mengingat informasi sensitif, gagal saat terjadi pergeseran distribusi, dan menghasilkan output yang meyakinkan namun salah. Mereka juga dapat sulit diinterpretasikan dan mahal untuk dilatih. Evaluasi harus mencakup lebih dari rata-rata benchmark: tim membutuhkan kinerja pada tingkat kelas atau subkelompok, ketahanan, kalibrasi, keamanan, latensi, penggunaan energi, serta konsekuensi kegagalan.
Representasi, Optimisasi, dan Pilihan Arsitektur
Jaringan deep mempelajari representasi berurutan melalui lapisan yang diparameterisasi. Transformasi linear mencampur input; aktivasi nonlinier memungkinkan jaringan memperkirakan fungsi kompleks; normalisasi dan koneksi residual membantu optimisasi; attention, konvolusi, rekursi, atau operasi state-space mengkodekan asumsi struktural yang berbeda. Kedalaman meningkatkan jumlah transformasi, bukan menjamin kecerdasan. Arsitektur harus mencerminkan modalitas, volume data, latensi, memori, dan invarian tugas. Model konvolusional yang lebih kecil dapat mengungguli transformer ketika data terbatas dan struktur spasial lokal mendominasi.
Pelatihan menghitung loss, menurunkannya dengan backpropagation, dan memperbarui parameter menggunakan optimizer seperti stochastic gradient descent atau Adam. Ukuran batch, laju belajar, jadwal, inisialisasi, regularisasi, dan presisi numerik saling berinteraksi. Kurva loss pelatihan dan validasi membantu membedakan underfitting, overfitting, ketidakstabilan, dan kebocoran, namun tidak menjamin kegunaan di dunia nyata. Gunakan data evaluasi independen, pengulangan yang penting bila varians berpengaruh, ablasi, dan perbandingan dengan baseline yang lebih sederhana. Jumlah parameter yang besar juga meningkatkan kebutuhan akan tata kelola data, perencanaan komputasi, dan konfigurasi yang dapat direproduksi.
Menyajikan Model Deep Secara Aman dan Efisien
Penyebaran dapat menggunakan endpoint yang dihosting, akselerator khusus, browser, ponsel, atau perangkat tertanam. Ekspor dan kompilasi dapat menggabungkan operator, mengkuantisasi bobot dan aktivasi, atau mengubah perilaku numerik, sehingga harus memvalidasi artefak yang disebarkan, bukan hanya checkpoint pelatihan. Ukur cold start, latensi stabil, throughput, memori, daya, dan kualitas pada ukuran batch dan urutan yang realistis. Metode kompresi—pruning, distilasi, kuantisasi, dan adaptasi low-rank—menukarkan ukuran atau kecepatan dengan akurasi dan kompleksitas teknik, dan harus dievaluasi pada kelas sensitif serta kasus tepi.
Model deep dapat gagal dengan keyakinan tinggi saat terjadi pergeseran distribusi, input adversarial, korelasi semu, dan kelompok yang kurang terwakili. Pantau distribusi input dan output, hasil tugas, kalibrasi, penggunaan sumber daya, dan versi dependensi. Gunakan kontrol akses, artefak yang ditandatangani, data pelatihan yang dilindungi, red teaming, serta batas laju yang sesuai dengan model ancaman. Penjelasan seperti peta saliency atau tampilan attention merupakan bukti diagnostik, bukan bukti kausalitas. Gabungkan dengan tes perilaku, counterfactual, tinjauan manusia, respons insiden, dan batas eksplisit pada keputusan otomatis.
Contoh Praktis: Melatih Detektor Cacat Gambar
Sebuah pabrik mengumpulkan gambar produk dari berbagai kamera, shift, material, dan kelas cacat yang diketahui, kemudian membagi berdasarkan batch produksi sehingga item yang hampir duplikat tidak dapat melintasi partisi. Baseline konvolusional kecil dibandingkan dengan jaringan deep yang telah dilatih sebelumnya. Augmentasi mereproduksi variasi pencahayaan dan sudut pandang yang tervalidasi tanpa menghapus cacat. Evaluasi melaporkan recall per-cacat, tingkat penolakan palsu, kalibrasi, latensi inferensi, serta ketahanan terhadap blur, glare, penggantian kamera, dan warna material yang jarang.
Model yang diekspor serta kode resize, warna, dan normalisasi yang tepat diuji pada perangkat keras lini produksi untuk throughput berkelanjutan dan perilaku termal. Kasus dengan kepercayaan rendah dikirim ke inspektor; aturan independen menghentikan lini bila terjadi kegagalan sensor kritis. Gambar hanya disimpan sesuai izin dan artefak model ditandatangani. Pemantauan menghubungkan prediksi dengan hasil inspeksi selanjutnya dan batch produksi. Kamera atau material baru memicu evaluasi ulang yang terkontrol, bukan pembelajaran daring diam-diam dari label yang belum ditinjau.
Bukti Implementasi dan Kesiapan Operasional
Keputusan produksi memerlukan lebih dari sekadar demonstrasi yang berhasil. Tentukan pengguna yang ditargetkan, lingkungan operasi, input, output, dependensi, pemilik, dan konsekuensi dari setiap kegagalan penting. Bangun baseline yang dapat direproduksi dan set evaluasi berversi sebelum penyetelan. Uji kasus biasa, kondisi batas, input yang rusak atau hilang, pergeseran distribusi, kegagalan dependensi, penyalahgunaan, serta kelompok atau lingkungan yang paling mungkin kurang terlayani. Ukur kualitas tugas bersama dengan kalibrasi atau ketidakpastian, latensi, throughput, biaya sumber daya, aksesibilitas, privasi, dan keamanan. Catat setiap transformasi dan ambang batas sehingga peninjau independen dapat mereproduksi hasil dan membedakan bukti dari prototipe yang menarik.
Sebelum peluncuran, tetapkan otoritas untuk rilis, pengecualian, perubahan, rollback, dan pensiun. Gunakan rollout bertahap, pertahankan fallback yang aman, dan verifikasi pemantauan dengan kegagalan yang disuntikkan secara sengaja. Telemetri operasional harus mengungkap kualitas input, perilaku output, versi model atau aturan, kesehatan dependensi, intervensi manusia, dan hasil yang dikonfirmasi tanpa mengumpulkan data sensitif yang tidak diperlukan. Tentukan ambang batas peringatan dan pemilik respons, lalu tinjau bukti dunia nyata setelah penyebaran alih-alih mengasumsikan kinerja offline akan bertahan. Evaluasi kembali setiap kali sumber data, pengguna, model, vendor, kebijakan, perangkat keras, atau tujuan berubah. Sistem yang dipelihara juga memerlukan dokumentasi pemulihan, pembelajaran insiden, prosedur penghapusan dan retensi, serta titik yang jelas di mana sistem harus dinonaktifkan atau diganti.
Referensi Utama