
Dasar-dasar AI
Apa Itu Pembelajaran Mesin?

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
Pembelajaran mesin (ML) adalah cabang kecerdasan buatan di mana sebuah sistem mempelajari pola dari data sehingga dapat membuat prediksi, klasifikasi, rekomendasi, atau keputusan tanpa pengembang menulis aturan terpisah untuk setiap kemungkinan kasus. Hasilnya bukanlah mesin yang “berpikir” seperti manusia. Itu adalah model statistik yang memetakan masukan ke keluaran yang berguna dan dapat dievaluasi pada data yang tidak pernah dilihat selama pelatihan.
Pembelajaran mesin berada dalam bidang AI yang lebih luas, sementara deep learning adalah keluarga metode pembelajaran mesin yang dibangun di sekitar jaringan saraf berlapis‑lapis. Perbedaan ini penting: tidak setiap sistem AI menggunakan ML, dan tidak setiap masalah ML memerlukan jaringan saraf.
Poin-poin Utama
- ML mempelajari hubungan dari contoh alih-alih hanya mengandalkan aturan yang ditulis secara manual.
- Model yang berguna harus dapat menggeneralisasi ke data baru, bukan sekadar menghafal set pelatihannya.
- Pembelajaran terawasi, tidak terawasi, semi‑terawasi, swaterawasi, dan penguatan menyelesaikan berbagai jenis masalah.
- Kualitas data, desain evaluasi, dan pemantauan sama pentingnya dengan algoritma.
Cara Kerja Pembelajaran Mesin
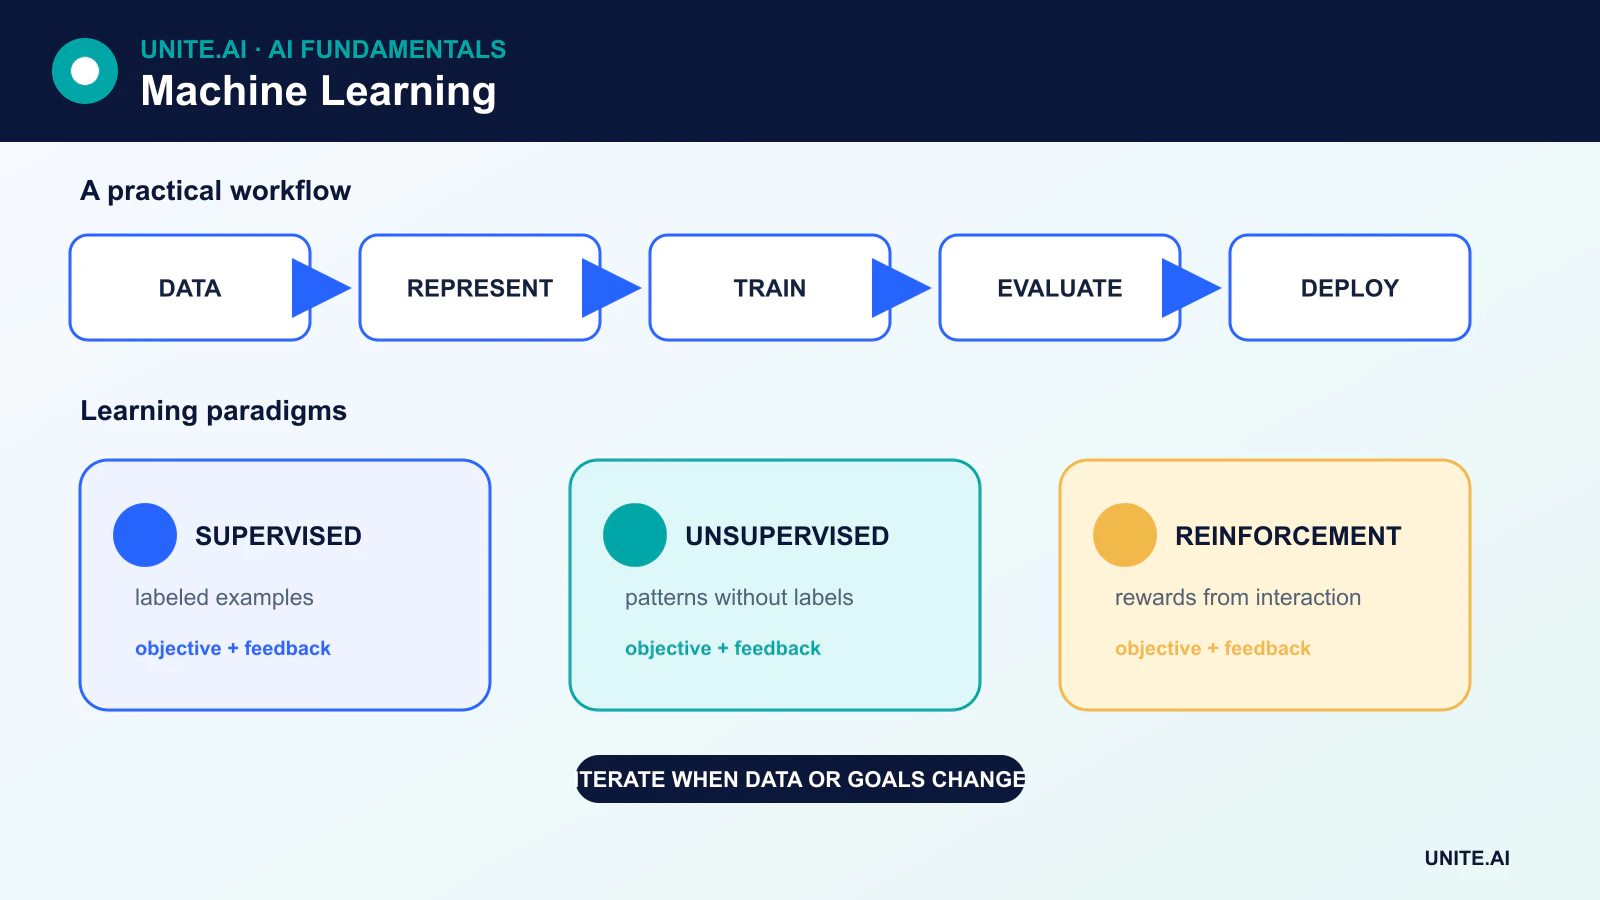
Sebagian besar proyek ML dapat dipahami sebagai rangkaian enam tahap:
- Tentukan tugas. Tentukan apa yang harus diprediksi atau temukan sistem, serta apa arti keberhasilan dalam aplikasi nyata.
- Kumpulkan dan persiapkan data. Bersihkan catatan, tangani nilai yang hilang, buat fitur yang berguna, dan dokumentasikan sumber data.
- Bagi data. Set pelatihan digunakan untuk melatih model, set validasi membantu memilih pengaturan, dan set pengujian memberikan perkiraan akhir pada data yang belum pernah dilihat.
- Latih model. Algoritma menyesuaikan parameter model untuk mengurangi fungsi kerugian atau memenuhi tujuan pembelajaran lainnya.
- Evaluasi generalisasi. Metrik harus mencerminkan tugas, keseimbangan kelas, biaya kesalahan, dan populasi tempat model akan beroperasi.
- Terapkan dan pantau. Data dunia nyata dapat berubah, sehingga tim memantau drift, penurunan kinerja, bias, dan kegagalan operasional.
Variabel yang diberikan ke model biasanya disebut fitur. Dalam pembelajaran terawasi, jawaban yang diinginkan disebut label atau target. Parameter yang dipelajari model mengkodekan hubungan antara fitur dan keluaran; mereka bukan basis data aturan eksplisit.
Paradigma Pembelajaran Utama
Pembelajaran Terawasi
Dalam pembelajaran terawasi, contoh mencakup baik masukan maupun target yang diketahui. Model klasifikasi memprediksi kategori, seperti apakah suatu transaksi fraud. Model regresi memprediksi nilai kontinu, seperti permintaan energi yang diperkirakan.
Algoritma terawasi yang umum meliputi pohon keputusan, mesin vektor pendukung, K-nearest neighbors, regresi linier dan logistik, pohon gradient‑boosted, dan jaringan saraf. Ambang batas klasifikasi seperti 0,5 adalah keputusan yang dipilih setelah model menghasilkan skor atau probabilitas; itu bukan sifat tak berubah dari regresi logistik.
Pembelajaran Tidak Terawasi
Pembelajaran tidak terawasi bekerja dengan data yang tidak menyertakan label target. Tujuannya dapat berupa menemukan klaster, mendeteksi observasi yang tidak biasa, memperkirakan distribusi, atau membuat representasi berdimensi lebih rendah. Sebuah klaster adalah kelompok yang disarankan oleh aturan kesamaan; tidak otomatis menjadi kelas dunia nyata yang bermakna.
Contohnya meliputi klaster K-means, analisis komponen utama, estimasi kepadatan, dan beberapa bentuk autoencoder. Autoencoder belajar merekonstruksi masukannya melalui representasi terkompresi. Ia tidak secara otomatis membuat label kebenaran dasar.
Pembelajaran Semi‑Terawasi dan Swaterawasi
Pembelajaran semi‑terawasi menggabungkan dataset berlabel kecil dengan dataset tidak berlabel yang lebih besar. Pembelajaran swaterawasi menciptakan sinyal pelatihan dari data itu sendiri—misalnya, memprediksi kata yang disembunyikan atau mencocokkan dua tampilan yang diubah dari gambar yang sama. Swateravasi menjadi inti bagi banyak transformer dan pipeline model fondasi modern karena dapat memanfaatkan koleksi besar teks, gambar, audio, atau video tanpa orang memberi label pada setiap contoh.
Pembelajaran Penguatan
Dalam pembelajaran penguatan, agen mengambil tindakan dalam lingkungan dan menerima hadiah atau biaya. Tujuannya adalah mempelajari kebijakan yang memaksimalkan hadiah kumulatif yang diharapkan. Ini berbeda dari pembelajaran terawasi karena tindakan yang benar tidak diberikan untuk setiap keadaan, dan suatu tindakan dapat memengaruhi data yang akan ditemui agen selanjutnya.
Pelatihan, Validasi, dan Generalisasi
Model yang berkinerja baik pada contoh pelatihannya masih dapat gagal pada data baru. Kegagalan ini dikenal sebagai overfitting. Tim menguranginya melalui kapasitas model yang tepat, regularisasi, cross‑validation, augmentasi data, pencegahan kebocoran, dan set pengujian yang benar‑benar independen.
Tidak ada metrik tunggal untuk setiap tugas ML. Klasifikasi mungkin memerlukan presisi, recall, F1, kalibrasi, atau ukuran berbobot biaya alih‑alih akurasi mentah. Regresi dapat menggunakan rata‑rata kesalahan absolut, akar rata‑rata kuadrat, atau kerugian khusus domain. Klaster membutuhkan bentuk evaluasi internal atau eksternal yang berbeda. Metrik harus mencerminkan apa arti kesalahan bagi pengguna atau organisasi.
Algoritma Pembelajaran Mesin adalah Alat, Bukan Jaminan
Sebuah algoritma membawa asumsi. Model linier mengasumsikan bentuk hubungan tertentu. K‑nearest neighbors mengasumsikan bahwa jarak yang dipilih mewakili kesamaan yang bermakna. Naive Bayes mengasumsikan fitur bersifat kondisional independen diberikan kelas. Pohon keputusan membagi ruang fitur menggunakan aturan pemisahan yang dipelajari; daun‑daunnya berisi prediksi berdasarkan kelompok observasi pelatihan, bukan satu observasi per daun.
Pemilihan model karenanya tergantung pada ukuran data, tipe fitur, persyaratan latensi, kebutuhan interpretabilitas, dan biaya kesalahan. Model yang lebih sederhana dapat mengungguli model yang lebih besar ketika data terbatas atau kendala operasional mengutamakan kecepatan dan transparansi.
Di Mana Pembelajaran Mesin Digunakan
ML mendukung peringkat pencarian, rekomendasi, peramalan, deteksi anomali, terjemahan, pengenalan suara, computer vision, pemeliharaan prediktif, deteksi penipuan, dan analisis ilmiah. Teknik yang sama juga dapat memperkuat bias historis, mengungkap informasi sensitif, atau berperilaku tidak terduga di bawah pergeseran distribusi. Penerapan yang bertanggung jawab memerlukan dokumentasi, pengawasan manusia bila diperlukan, pengujian keamanan, dan pemantauan berkelanjutan.
Dari Definisi Masalah hingga Eksperimen Pembelajaran Mesin yang Valid
Proyek pembelajaran mesin harus dimulai dengan keputusan dan hasil yang dapat diukur, bukan dengan algoritma. Tentukan unit prediksi, target, waktu observasi, waktu keputusan, fitur yang tersedia, dan biaya setiap kesalahan. Misalnya, untuk model churn, menggunakan peristiwa yang tercatat setelah pembatalan akan membocorkan jawabannya. Tetapkan aturan sederhana atau baseline statistik, kemudian bagi data berdasarkan waktu, pelanggan, lokasi, atau batas lain yang mencerminkan penerapan. Pembagian baris secara acak dapat menempatkan observasi yang hampir identik di set pelatihan dan pengujian serta menghasilkan skor yang menyesatkan.
Rekayasa fitur mengubah catatan mentah menjadi representasi yang dapat digunakan model, namun setiap fitur memerlukan asal usul dan jaminan ketersediaan. Lakukan normalisasi, pembuatan kosakata, imputasi, dan reduksi dimensi hanya pada data pelatihan, kemudian terapkan transformasi yang dipelajari pada data validasi dan pengujian. Cross‑validation memperkirakan variasi antar sampel; set pengujian akhir yang belum disentuh mendukung keputusan rilis. Pilih metrik berdasarkan konsekuensi: presisi dan recall untuk kesalahan klasifikasi yang tidak seimbang, kalibrasi ketika probabilitas menggerakkan tindakan, serta ukuran berbobot biaya atau utilitas ketika kesalahan memiliki efek operasional yang berbeda.
Penerapan, Pemantauan, dan Operasi yang Bertanggung Jawab
Inferensi produksi mengulangi transformasi lengkap pada saat pelatihan dan mengembalikan prediksi di bawah batas latensi, throughput, dan ketersediaan. Kemasi pra‑pemrosesan bersama model, validasi skema input, versi artefak, dan bandingkan hasil antara implementasi offline dan layanan. Pilih ambang batas menggunakan kapasitas operasional dan trade‑off kesalahan alih‑alih menggunakan nilai default 0,5. Luncurkan melalui evaluasi bayangan, kohort terbatas, atau percobaan dengan metrik pengaman. Pertahankan fallback deterministik dan jalur rollback untuk kegagalan dependensi atau perilaku yang tidak dapat diterima.
Pantau kualitas input, drift fitur, distribusi prediksi, kalibrasi, hasil subkelompok, latensi, biaya, dan label yang dikonfirmasi ketika akhirnya tersedia. Drift adalah sinyal untuk diselidiki, bukan bukti otomatis bahwa pelatihan ulang akan membantu. Pelatihan ulang memerlukan data yang ditinjau, tes yang dapat diulang, persetujuan, dan perbandingan dengan model unggulan saat ini. Dokumentasikan penggunaan yang dimaksudkan dan yang tidak sah, hak data, privasi, keamanan, intervensi manusia, dan banding bila orang terpengaruh. Pembelajaran mesin adalah sistem keputusan yang dipelihara; berkas model hanyalah satu komponen yang dapat diganti.
Contoh Praktis: Memperkirakan Kegagalan Peralatan
Seorang produsen mendefinisikan satu prediksi per mesin‑hari: apakah kegagalan yang terverifikasi akan terjadi dalam tujuh hari menggunakan hanya telemetri yang tersedia pada awal hari tersebut. Data dibagi berdasarkan mesin dan waktu, dibandingkan dengan aturan berbasis usia dan ambang, menyesuaikan pra‑pemrosesan pada data pelatihan, dan mengevaluasi recall kejadian, peringatan palsu, waktu peringatan, kalibrasi, serta kapasitas pemeliharaan. Penggantian sensor dan penghentian terjadwal dimodelkan sebagai konteks operasional, bukan sebagai observasi biasa.
Model pertama kali dijalankan dalam mode bayangan. Peringatan menampilkan telemetri yang berkontribusi dan ketidakpastian, namun pemelihara memutuskan apakah akan memeriksa. Temuan dan penyebab yang dikonfirmasi menjadi label yang diatur; ketidakhadiran work order tidak diasumsikan berarti tidak ada kegagalan. Peluncuran bertahap menggunakan batas peringatan dan fallback manual, sementara pemantauan melacak kesehatan sensor, drift input, presisi yang ditinjau, waktu henti, dan pemeliharaan yang tidak perlu. Pelatihan ulang terjadi hanya setelah tinjauan data dan ambang menunjukkan kemungkinan perbaikan dibandingkan sistem yang saat ini diterapkan.
Bukti Implementasi dan Kesiapan Operasional
Keputusan produksi membutuhkan lebih dari sekadar demonstrasi yang berhasil. Tentukan pengguna yang dimaksud, lingkungan operasional, masukan, keluaran, dependensi, pemilik, dan konsekuensi setiap kegagalan penting. Bangun baseline yang dapat direproduksi dan set evaluasi berversi sebelum penyetelan. Uji kasus biasa, kondisi batas, input yang rusak atau hilang, pergeseran distribusi, kegagalan dependensi, penyalahgunaan, serta grup atau lingkungan yang paling mungkin kurang terlayani. Ukur kualitas tugas bersama dengan kalibrasi atau ketidakpastian, latensi, throughput, biaya sumber daya, aksesibilitas, privasi, dan keamanan. Catat setiap transformasi dan ambang sehingga peninjau independen dapat mereproduksi hasil dan membedakan bukti dari prototipe yang menarik.
Sebelum peluncuran, tetapkan otoritas untuk rilis, pengecualian, perubahan, rollback, dan pensiun. Gunakan peluncuran bertahap, pertahankan fallback yang aman, dan verifikasi pemantauan dengan kegagalan yang sengaja disuntikkan. Telemetri operasional harus mengungkap kualitas input, perilaku output, versi model atau aturan, kesehatan dependensi, intervensi manusia, dan hasil yang dikonfirmasi tanpa mengumpulkan data sensitif yang tidak diperlukan. Tentukan ambang peringatan dan pemilik respons, kemudian tinjau bukti dunia nyata setelah penerapan alih‑alih mengasumsikan kinerja offline akan bertahan. Evaluasi kembali setiap kali sumber data, pengguna, model, vendor, kebijakan, perangkat keras, atau tujuan berubah. Sistem yang dipelihara juga memerlukan dokumentasi pemulihan, pembelajaran insiden, prosedur penghapusan dan retensi, serta titik yang jelas di mana sistem harus dinonaktifkan atau diganti.
Referensi Utama












