
Dasar-dasar AI
Apa itu Pohon Keputusan?

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
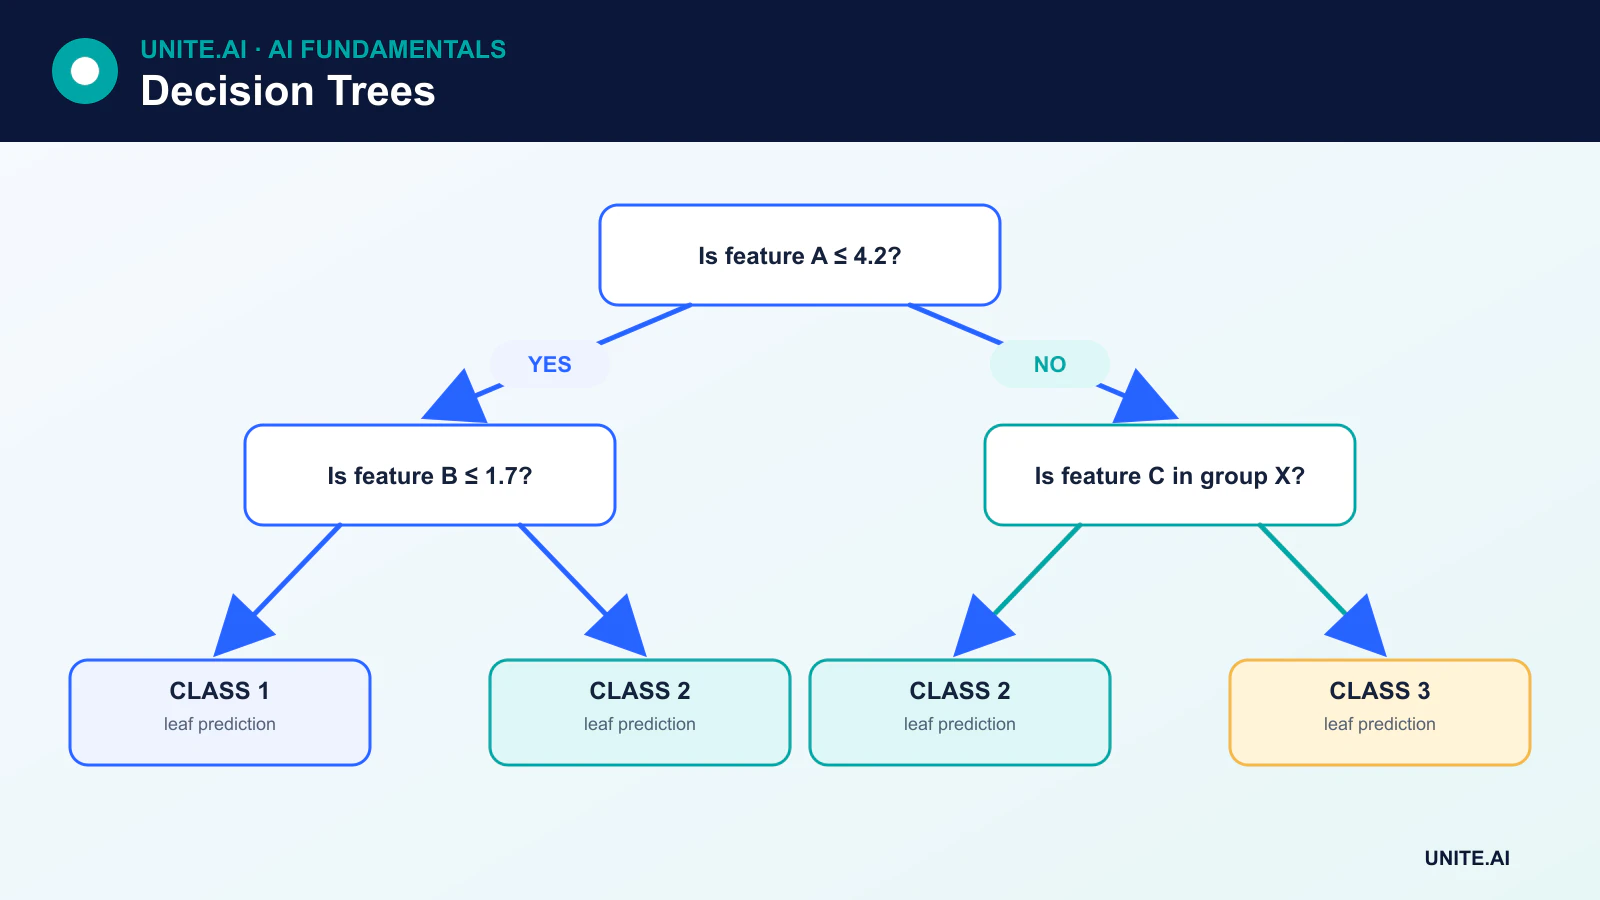
Pohon keputusan adalah model pembelajaran terawasi yang membuat prediksi dengan menerapkan rangkaian aturan if‑then. Setiap node internal menguji sebuah fitur, setiap cabang mewakili hasil dari pengujian tersebut, dan setiap daun menghasilkan prediksi kelas, probabilitas, atau nilai numerik.
Pohon keputusan digunakan untuk klasifikasi dan regresi. Daya tariknya praktis: mereka dapat merepresentasikan interaksi nonlinier, membutuhkan pra‑pemrosesan yang relatif sedikit, dan menghasilkan jalur yang dapat diperiksa oleh orang. Kelemahannya adalah ketidakstabilan—perubahan kecil pada data pelatihan dapat menghasilkan pohon yang berbeda.
Poin penting
- Sebuah pohon secara rekursif membagi ruang fitur; tidak harus mengisolasi setiap observasi pelatihan.
- Pembagian untuk klasifikasi biasanya menggunakan impuritas Gini atau entropi, sementara pembagian untuk regresi mengurangi kesalahan prediksi atau varians.
- Kedalaman, ukuran daun minimum, dan pemangkasan mengendalikan kompleksitas dan overfitting.
- Random forest dan pohon gradient‑boosted meningkatkan daya prediksi dengan menggabungkan banyak pohon.
Bagaimana pohon keputusan membuat prediksi
Misalkan sebuah model memprediksi apakah sebuah mesin kemungkinan akan gagal. Node akar mungkin menanyakan apakah getaran melebihi ambang batas yang dipelajari. Sebuah cabang kemudian dapat menguji suhu operasi. Observasi tersebut mencapai sebuah daun yang berisi perkiraan probabilitas kegagalan di antara contoh pelatihan yang mengikuti jalur yang sama.
Untuk regresi, daun dapat mengembalikan nilai rata‑rata target dari observasi di wilayah tersebut. Untuk klasifikasi, daun dapat mengembalikan kelas mayoritas atau distribusi frekuensi kelas. Sebuah daun dapat berisi banyak observasi; memisahkan seluruh data pelatihan sepenuhnya biasanya tidak diinginkan karena dapat menghasilkan pohon yang overfit.
Bagaimana pohon memilih pemisahan
Pelatihan mempertimbangkan fitur dan ambang batas kandidat, kemudian memilih pemisahan yang paling meningkatkan tujuan yang didefinisikan. Peningkatan tersebut harus ditimbang berdasarkan berapa banyak observasi yang masuk ke setiap node anak.
Impuritas Gini
Untuk klasifikasi, impuritas Gini mengukur seberapa campur aduk kelas dalam sebuah node:
Gini = 1 - Σ p(k)²
Node yang hanya berisi satu kelas memiliki impuritas nol. Sebuah pemisahan kandidat berguna ketika impuritas tertimbang anak‑cucunya lebih rendah daripada impuritas node induk.
Entropi dan gain informasi
Entropi adalah ukuran lain dari ketidakpastian kelas:
Entropy = -Σ p(k) log₂ p(k)
Gain informasi adalah entropi induk dikurangi entropi anak yang ditimbang. Gini dan entropi sering menghasilkan pohon yang serupa, meskipun tidak selalu identik.
Loss regresi
Pohon regresi biasanya memilih pemisahan yang mengurangi squared error, absolute error, atau kriteria regresi lainnya. Setiap daun kemudian memprediksi sebuah nilai berdasarkan target pelatihan di dalam wilayah tersebut.
CART dan algoritma pohon lainnya
CART, atau Classification and Regression Trees, menggunakan pemisahan biner dan menjadi dasar implementasi umum seperti decision trees scikit-learn. Algoritma lain meliputi ID3, C4.5, dan C5.0. Implementasi berbeda dalam jenis pemisahan yang didukung, penanganan nilai yang hilang, pemangkasan, dan tujuan.
Variabel kategorikal mungkin memerlukan encoding, pemisahan subset langsung, atau penanganan khusus implementasi. Nilai yang hilang dapat diimputasi atau ditangani melalui arah default yang dipelajari atau pemisahan surrogate. Penting untuk memahami perilaku perpustakaan tertentu daripada mengasumsikan setiap implementasi pohon bekerja dengan cara yang sama.
Mengendalikan kompleksitas pohon
Pohon yang dalam dapat menghafal noise. Kontrol umum meliputi:
- Kedalaman maksimum: membatasi panjang jalur prediksi.
- Minimum sampel per pemisahan atau daun: mencegah wilayah yang sangat kecil.
- Penurunan impuritas minimum: mengharuskan sebuah pemisahan memberikan manfaat yang cukup.
- Jumlah maksimum daun: membatasi total kompleksitas.
- Pemangkasan cost‑complexity: menghapus cabang yang perbaikannya tidak cukup untuk membenarkan tambahan kompleksitas.
Pemangkasan adalah proses optimisasi terstruktur, bukan penghapusan acak. Hyperparameter harus dipilih dengan data validasi atau cross‑validation, sementara set pengujian akhir tetap tidak tersentuh.
Kekuatan dan keterbatasan
Pohon keputusan dapat memodelkan interaksi dan efek ambang tanpa skala fitur. Mereka menerima input numerik dan, tergantung pada implementasinya, input kategorikal. Prediksi cepat, dan pohon kecil mudah divisualisasikan.
Namun, satu pohon dapat memiliki varians tinggi, menghasilkan perubahan prediksi yang tiba‑tiba di dekat pemisahan, dan lebih menyukai fitur dengan banyak titik pemisahan yang memungkinkan. Pohon juga melakukan ekstrapolasi yang buruk pada regresi: di luar wilayah yang diamati, daun tetap mengembalikan nilai yang dipelajari dari sampel pelatihannya. Pohon besar mungkin tidak lebih dapat dipahami dibandingkan model kompleks lainnya.
Dari satu pohon ke ensemble
Ensemble learning menggabungkan beberapa model. Random forest melatih banyak pohon pada observasi yang di‑resample dan subset fitur, kemudian merata‑ratakan prediksinya. Gradient boosting membangun pohon secara berurutan sehingga setiap pohon baru menangani sisa kesalahan. Pendekatan ini biasanya mengungguli satu pohon, namun mengorbankan sebagian interpretabilitas dan menambah biaya komputasi.
Feature importance dari sebuah pohon atau ensemble harus ditafsirkan dengan hati‑hati. Importance berbasis impuritas dapat bias, dan pentingnya sebuah fitur tidak membuktikan kausalitas. Permutation importance, alat partial‑dependence, dan tinjauan domain memberikan konteks tambahan.
Bagaimana pohon mempelajari pemisahan dan prediksi
Pohon keputusan secara rekursif membagi ruang fitur. Pada setiap node, algoritma pelatihan mengevaluasi ambang batas fitur kandidat atau partisi kategori dan memilih pemisahan yang paling mengurangi impuritas, seperti impuritas Gini atau entropi untuk klasifikasi dan squared error untuk regresi. Daun menyimpan distribusi kelas atau prediksi numerik berdasarkan observasi pelatihan yang mencapainya. Pemisahan greedy praktis secara komputasi namun tidak menjamin pohon terbaik secara global, dan sampel yang berbeda atau penentuan tie‑break dapat menghasilkan struktur yang berbeda.
Fitur kontinu, ordinal, kategorikal, dan yang hilang memerlukan penanganan eksplisit. One‑hot encoding dapat menghasilkan banyak pemisahan kandidat; metode kategorikal native dapat menggunakan statistik terurut namun memerlukan implementasi yang aman dari kebocoran. Pohon tidak memerlukan skala, namun dapat lebih menyukai variabel ber‑kardinalitas tinggi dan mengisolasi kelompok kecil. Kedalaman, ukuran daun minimum, penurunan impuritas minimum, dan pemangkasan cost‑complexity mengendalikan varians. Pilihlah dengan data validasi dan evaluasi kalibrasi, karena probabilitas daun yang didasarkan pada beberapa kasus dapat menjadi ekstrem dan tidak stabil.
Interpretasi, mode kegagalan, dan penggunaan produksi
Sebuah jalur dari akar ke daun adalah aturan tepat untuk satu prediksi model, namun tidak otomatis menjadi penjelasan kausal. Variabel yang berkorelasi dapat menggantikan satu sama lain, perubahan data kecil dapat mengubah pemisahan atas, dan jalur yang tampak sederhana dapat bergantung pada label yang bias. Feature importance global berbasis impuritas dapat menyesatkan; permutation importance, partial dependence, dan pemeriksaan counterfactual menambah konteks namun juga memiliki asumsi. Laporkan ketidakpastian dan uji apakah aturan yang diklaim berlaku pada data independen dan sub‑kelompok yang relevan.
Pohon tunggal berguna ketika transparansi, latensi rendah, dan struktur nonlinier yang sederhana penting, namun ensemble biasanya memberikan kinerja prediksi yang lebih kuat. Validasi perilaku batas, kategori langka, nilai yang hilang, dan input di luar rentang pelatihan. Aturan yang diekspor harus mereproduksi pra‑pemrosesan pelatihan dan perbandingan numerik secara tepat. Pantau okupansi daun, distribusi output, kesalahan, dan kategori yang muncul. Pohon yang mengarahkan banyak kasus baru ke wilayah yang sangat kecil atau sebelumnya kosong harus memicu tinjauan meskipun drift agregat tetap kecil. Simpan fallback untuk skema tidak valid dan dokumentasikan setiap keputusan pemangkasan atau ambang.
Contoh kerja: pohon triase pinjaman yang dapat diinterpretasikan
Pemberi pinjaman menggunakan pohon hanya untuk memprioritaskan aplikasi yang tidak lengkap untuk peninjauan manual, bukan untuk menyetujui atau menolak kredit. Targetnya adalah hasil kelengkapan yang terdokumentasi, dan fitur yang tersedia pada saat masuk tidak mencakup keputusan selanjutnya. Validasi temporal berkelompok membandingkan pohon dipangkas yang dangkal dengan aturan dan regresi logistik. Ukuran daun minimum mencegah aturan berdasarkan beberapa pelamar, sementara kalibrasi dan kesalahan spesifik kelas dilaporkan di seluruh saluran dan kelompok terlindungi yang relevan.
Reviewer melihat jalur tepat dan nilai sumber tetapi dapat memperbaiki data yang salah dan mengesampingkan routing. Organisasi menguji proksi yang berkorelasi dan perubahan counterfactual, memantau okupansi daun dan nilai yang hilang, serta memperlakukan lonjakan lalu lintas ke daun kecil sebagai insiden kualitas data. Perubahan kebijakan menciptakan versi model dan validasi baru, bukan penyuntingan pemisahan yang tidak terdokumentasi. Karena penggunaannya memengaruhi akses dan beban, pelamar menerima saluran manusia dan pohon tidak pernah disajikan sebagai penjelasan kausal tentang kelayakan kredit.
Bukti implementasi dan kesiapan operasional
Keputusan produksi membutuhkan lebih dari sekadar demonstrasi yang berhasil. Definisikan pengguna yang dimaksud, lingkungan operasi, input, output, dependensi, pemilik, dan konsekuensi dari setiap kegagalan penting. Bangun baseline yang dapat direproduksi dan set evaluasi berversi sebelum penyetelan. Uji kasus biasa, kondisi batas, input yang rusak atau hilang, pergeseran distribusi, kegagalan dependensi, penyalahgunaan, serta grup atau lingkungan yang paling mungkin kurang terlayani. Ukur kualitas tugas bersama dengan kalibrasi atau ketidakpastian, latensi, throughput, biaya sumber daya, aksesibilitas, privasi, dan keamanan. Catat setiap transformasi dan ambang sehingga reviewer independen dapat mereproduksi hasil dan membedakan bukti dari prototipe yang menarik.
Sebelum peluncuran, tetapkan otoritas untuk rilis, pengecualian, perubahan, rollback, dan pensiun. Gunakan peluncuran bertahap, pertahankan fallback yang aman, dan verifikasi pemantauan dengan kegagalan yang disuntikkan secara sengaja. Telemetri operasional harus mengungkap kualitas input, perilaku output, versi model atau aturan, kesehatan dependensi, intervensi manusia, dan hasil yang dikonfirmasi tanpa mengumpulkan data sensitif yang tidak diperlukan. Definisikan ambang batas peringatan dan pemilik respons, kemudian tinjau bukti dunia nyata setelah penerapan alih-alih mengasumsikan kinerja offline akan bertahan. Evaluasi kembali setiap kali sumber data, pengguna, model, vendor, kebijakan, perangkat keras, atau tujuan berubah. Sistem yang dipelihara juga memerlukan dokumentasi pemulihan, pembelajaran insiden, prosedur penghapusan dan retensi, serta titik yang jelas di mana sistem harus dinonaktifkan atau diganti.
Referensi utama












