
Dasar-dasar AI
Apa itu Matriks Kebingungan?

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
Sebuah confusion matrix adalah tabel yang menghitung seberapa sering prediksi classifier setuju atau tidak setuju dengan label yang diketahui. Tabel ini mengungkap kelas mana yang bingung dan menyediakan hitungan yang digunakan untuk menghitung metrik seperti presisi, recall, spesifisitas, dan F1. Ini adalah salah satu alat diagnostik utama untuk masalah klasifikasi pembelajaran terawasi.
Matriks itu sendiri bukanlah satu skor kinerja tunggal. Ia merupakan tampilan terstruktur dari hasil pada ambang keputusan tertentu, dataset, dan definisi kelas.
Intisari
- Untuk klasifikasi biner, empat hasilnya adalah true positive, false positive, false negative, dan true negative.
- Selalu beri label pada sumbu: perpustakaan dan publikasi tidak semuanya menempatkan kelas aktual dan kelas prediksi dalam orientasi yang sama.
- Akurasi dapat menyembunyikan kesalahan serius ketika kelas tidak seimbang.
- Mengubah ambang klasifikasi mengubah matriks kebingungan dan pertukaran antara presisi dan recall.
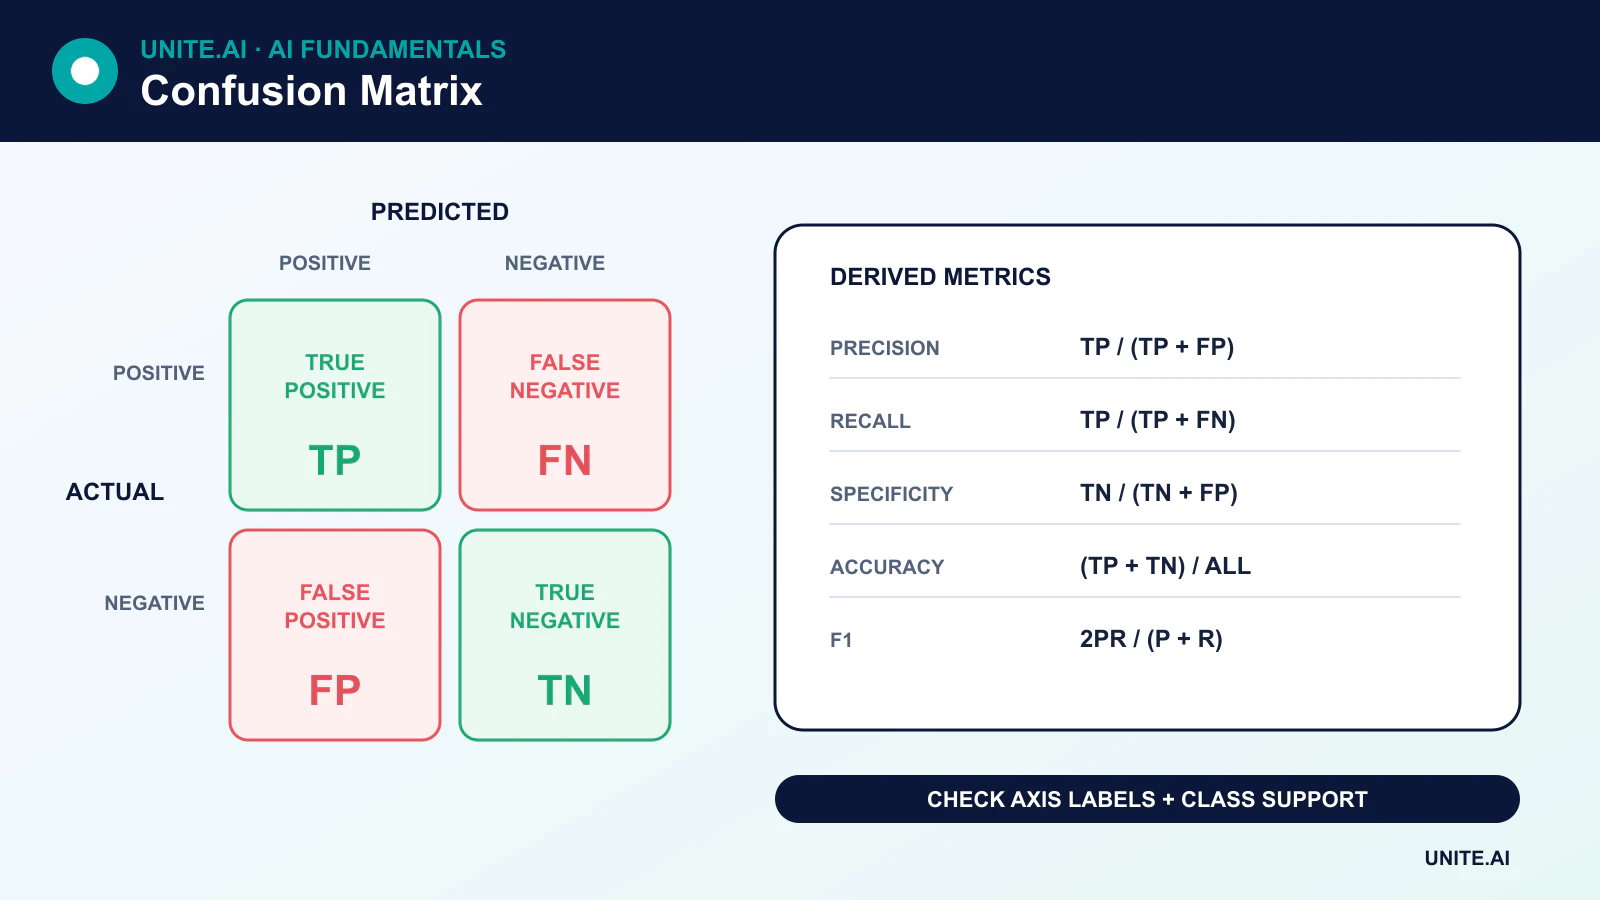
Empat Hasil Klasifikasi Biner
- True positive (TP): contoh tersebut positif dan model memprediksi positif.
- False positive (FP): contoh tersebut negatif tetapi model memprediksi positif.
- False negative (FN): contoh tersebut positif tetapi model memprediksi negatif.
- True negative (TN): contoh tersebut negatif dan model memprediksi negatif.
Dalam konvensi scikit-learn, baris mewakili kelas sebenarnya dan kolom mewakili kelas yang diprediksi. Visualisasi lain mungkin menukar susunan ini, sehingga label—bukan posisi sudut—yang harus menjadi panduan interpretasi.
Metrik yang Dihasilkan dari Matriks Kebingungan
Presisi
Precision = TP / (TP + FP)
Presisi menjawab: di antara contoh yang diprediksi positif, berapa proporsi yang sebenarnya positif?
Recall atau sensitivitas
Recall = TP / (TP + FN)
Recall menjawab: di antara semua contoh positif sebenarnya, berapa proporsi yang berhasil diidentifikasi model? Pada klasifikasi biner, recall kelas positif juga disebut sensitivitas atau tingkat true‑positive.
Spesifisitas
Specificity = TN / (TN + FP)
Spesifisitas adalah recall untuk kelas negatif: di antara negatif sebenarnya, berapa proporsi yang berhasil ditolak oleh model dengan benar?
Akurasi
Accuracy = (TP + TN) / (TP + TN + FP + FN)
Akurasi berguna ketika kelas dan biaya kesalahan relatif seimbang. Namun dapat menipu ketika satu kelas mendominasi.
Skor F1
F1 = 2 × (Precision × Recall) / (Precision + Recall)
Skor F1 merangkum presisi dan recall dengan rata‑rata harmonik. Ia mengabaikan true negatives, sehingga bukan ringkasan yang tepat untuk setiap tugas.
Contoh Praktis
Misalkan set uji berisi 1.000 transaksi. Lima puluh di antaranya penipuan. Sebuah model menemukan 40 dari penipuan tersebut tetapi menandai 30 transaksi sah:
- TP = 40
- FN = 10
- FP = 30
- TN = 920
Model tersebut memiliki akurasi 96%, tetapi presisinya sekitar 57% dan recallnya 80%. Akurasi tinggi ini sebagian besar dipengaruhi oleh banyaknya transaksi sah. Apakah model ini dapat diterima tergantung pada biaya penipuan yang terlewat, kapasitas investigasi, dan seberapa terkalibrasi skor risiko yang dihasilkan.
Ambang Mengubah Matriks
Banyak classifier menghasilkan skor alih‑alih jawaban ya/tidak yang tak terhindarkan. Menurunkan ambang positif biasanya meningkatkan recall dan false positives; menaikkannya biasanya meningkatkan presisi atau spesifisitas sambil melewatkan lebih banyak positif. Ambang harus dipilih menggunakan data validasi dan biaya kesalahan nyata, bukan secara otomatis ditetapkan pada 0,5.
Kurva precision‑recall dan ROC merangkum kinerja di berbagai ambang. Kurva precision‑recall seringkali lebih informatif ketika kelas positif jarang.
Matriks Kebingungan Multikelas
Untuk K kelas, matriks berukuran K × K. Prediksi yang benar berada pada diagonal; sel di luar diagonal menunjukkan pasangan kelas yang bingung. Metrik per‑kelas dapat dirata‑rata dengan cara berbeda:
- Macro average: memberikan setiap kelas bobot yang sama.
- Weighted average: memberi bobot pada setiap kelas berdasarkan jumlah contoh.
- Micro average: mengagregasi hitungan hasil sebelum menghitung metrik.
Melaporkan hanya satu rata‑rata dapat menyembunyikan kinerja buruk pada kelas yang lebih kecil. Sertakan jumlah dukungan dan hasil per‑kelas di mana perbedaan penting.
Kesalahan Umum
- Membaca matriks yang ditranspos tanpa memeriksa label sumbu.
- Menghitung metrik dari data pelatihan alih‑alih dari set yang dipisahkan secara tepat.
- Mengabaikan prevalensi kelas, strategi sampling, atau entitas duplikat antar split.
- Membandingkan matriks yang dihasilkan pada ambang yang berbeda tanpa mencatat perubahannya.
- Menganggap semua false positive dan false negative memiliki biaya yang sama.
Matriks kebingungan oleh karena itu merupakan alat diagnostik, bukan evaluasi lengkap. Kalibrasi, analisis subkelompok, ketahanan, dan konsekuensi hilir juga termasuk dalam tinjauan klasifikasi.
Membaca Setiap Sel dan Menurunkan Metrik Berguna
Untuk klasifikasi biner, matriks kebingungan menghitung true positives, false positives, false negatives, dan true negatives untuk kelas positif dan ambang yang dipilih. Akurasi membagi prediksi benar dengan semua kasus; presisi menanyakan berapa fraksi prediksi positif yang benar; recall menanyakan berapa fraksi positif sebenarnya yang ditemukan; spesifisitas mengukur negatif sebenarnya yang ditolak dengan benar. F1 adalah rata‑rata harmonik dari presisi dan recall. Tidak ada yang secara inheren paling baik: penyaringan penipuan, triase medis, dan penyaringan spam memberikan konsekuensi berbeda pada sel yang sama.
Untuk masalah multikelas, baris biasanya mewakili kelas sebenarnya dan kolom kelas yang diprediksi, meskipun konvensi bervariasi, sehingga label harus eksplisit. Hitungan one‑vs‑rest menghasilkan presisi dan recall per‑kelas. Rata‑rata macro memberi bobot kelas secara setara; rata‑rata micro mengagregasi keputusan dan mengutamakan kelas umum; rata‑rata weighted mengikuti dukungan kelas. Tugas multilabel memungkinkan beberapa label per item dan memerlukan definisi per‑label atau per‑sampel. Normalisasi per baris untuk memeriksa pola recall atau per kolom untuk memeriksa komposisi prediksi, tetapi pertahankan hitungan mentah agar kelompok langka tidak berlebihan secara visual.
Ambang, Ketidakpastian, dan Keputusan Operasional
Matriks kebingungan merangkum keputusan keras pada satu ambang. Gunakan kurva precision‑recall atau ROC untuk membandingkan ambang, kemudian pilih titik operasi berdasarkan kapasitas, prevalensi, dan biaya kesalahan. Kalibrasi menanyakan apakah probabilitas yang diprediksi cocok dengan frekuensi yang diamati dan terpisah dari peringkat. Ketika prevalensi berubah, presisi dapat berubah meskipun sensitivitas dan spesifisitas tetap stabil. Laporkan interval kepercayaan atau variasi bootstrap, dan hindari menarik kesimpulan dari beberapa kesalahan dalam subkelompok kecil.
Audit matriks berdasarkan waktu, lokasi, perangkat, bahasa, dan kelompok terkait yang terdampak untuk menemukan konsentrasi kesalahan. Bandingkan model dengan proses keputusan yang ada, termasuk tinjauan manusia. Untuk cascade, catat kesalahan pada setiap tahap: pengambilan, klasifikasi, penentuan ambang, dan aksi. Pantau label hasil secara langsung dengan penundaan dan proses koreksinya. F1 yang tampak meningkat masih dapat meningkatkan false negative yang berbahaya atau melebihi kapasitas tinjauan. Matriks kebingungan adalah buku keputusan; hubungkan setiap sel dengan siapa yang mengalami kesalahan dan respons apa yang menyusul.
Contoh Praktis: Memilih Ambang Penyaringan Medis
Sebuah model penyaringan machine‑learning menghasilkan skor risiko untuk kondisi dengan prevalensi rendah. Tim membuat matriks kebingungan pada berbagai ambang dan melaporkan sensitivitas, spesifisitas, presisi, rujukan palsu, dan kasus yang terlewat dengan interval kepercayaan. Karena nilai prediktif positif bergantung pada prevalensi, model ini memodelkan populasi yang dimaksud alih‑alih mengutip presisi dari satu dataset. Hasil dibagi berdasarkan perangkat, situs, usia, jenis kelamin, dan kelompok lain yang secara klinis dibenarkan.
Klinisi memilih titik operasi yang mempertahankan sensitivitas yang diperlukan tanpa membebani tes konfirmasi. Matriks diterjemahkan menjadi perkiraan hitungan per 10.000 orang yang disaring sehingga konsekuensinya dapat dipahami. Skor di luar kondisi yang tervalidasi tidak menghasilkan kesimpulan otomatis. Pemantauan membandingkan prediksi dengan diagnosis yang dikonfirmasi setelah penundaan, melacak kapasitas dan kalibrasi, serta memicu tinjauan ketika prevalensi atau akuisisi berubah. Matriks kebingungan tetap terhubung dengan model, ambang, dan populasi yang tepat.
Bukti Implementasi dan Kesiapan Operasional
Keputusan produksi memerlukan lebih dari sekadar demonstrasi yang berhasil. Tentukan pengguna yang dimaksud, lingkungan operasional, input, output, ketergantungan, pemilik, dan konsekuensi dari setiap kegagalan penting. Bangun baseline yang dapat direproduksi dan set evaluasi berversi sebelum penyetelan. Uji kasus biasa, kondisi batas, input yang rusak atau hilang, pergeseran distribusi, kegagalan ketergantungan, penyalahgunaan, serta kelompok atau lingkungan yang paling mungkin kurang terlayani. Ukur kualitas tugas bersama dengan kalibrasi atau ketidakpastian, latensi, throughput, biaya sumber daya, aksesibilitas, privasi, dan keamanan. Catat setiap transformasi dan ambang sehingga peninjau independen dapat mereproduksi hasil dan membedakan bukti dari prototipe yang menarik.
Sebelum peluncuran, tetapkan otoritas untuk rilis, pengecualian, perubahan, rollback, dan pensiun. Gunakan peluncuran bertahap, pertahankan fallback yang aman, dan verifikasi pemantauan dengan kegagalan yang sengaja disuntikkan. Telemetri operasional harus mengungkap kualitas input, perilaku output, versi model atau aturan, kesehatan ketergantungan, intervensi manusia, dan hasil yang dikonfirmasi tanpa mengumpulkan data sensitif yang tidak diperlukan. Tentukan ambang peringatan dan pemilik respons, kemudian tinjau bukti dunia nyata setelah penerapan alih‑alih mengasumsikan kinerja offline akan bertahan. Evaluasi kembali setiap kali sumber data, pengguna, model, vendor, kebijakan, perangkat keras, atau tujuan berubah. Sistem yang dipelihara juga memerlukan prosedur pemulihan terdokumentasi, pembelajaran insiden, prosedur penghapusan dan retensi, serta titik yang jelas di mana sistem harus dinonaktifkan atau diganti.
Pertanyaan yang Sering Diajukan
Apa itu matriks kebingungan yang dinormalisasi?
Normalisasi membagi hitungan dengan total kelas sebenarnya, total kelas yang diprediksi, atau semua observasi. Hal ini memudahkan perbandingan rasio antar kelas, namun laporan juga harus mempertahankan hitungan dukungan mentah agar kelompok kecil tidak disamakan dengan kelompok yang sama besarnya.
Dapatkah matriks kebingungan mengevaluasi regresi?
Tidak secara langsung. Matriks kebingungan memerlukan kelas diskrit. Mengelompokkan target kontinu membuang informasi; regresi biasanya menggunakan analisis residu dan metrik yang dirancang untuk nilai kontinu, seperti MAE atau RMSE.
Referensi Utama












