
Dasar-dasar AI
Bagaimana Cara Kerja Klasifikasi Teks?

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
Klasifikasi teks memberikan satu atau lebih label kepada dokumen, pesan, atau rentang teks. Contohnya termasuk deteksi spam, penentuan rute niat, analisis sentimen, penandaan topik, moderasi, dan prioritas tiket dukungan.
Klasifier produksi lebih dari sekadar model. Ia bergantung pada taksonomi label yang tepat, anotasi representatif, pemisahan yang aman dari kebocoran, aturan keputusan yang terkalibrasi, serta pemantauan terhadap perubahan bahasa dan prevalensi kelas.
Poin-poin penting
- Tentukan label dan kasus ambigu sebelum memilih arsitektur.
- Baseline bag-of-words sederhana tetap berharga; encoder yang telah dilatih sebelumnya menambahkan konteks dan pembelajaran transfer.
- Akurasi dapat menyembunyikan kinerja kelas minoritas yang buruk, sehingga gunakan metrik yang memperhatikan kelas serta analisis kesalahan.
- Kalibrasi probabilitas, abstensi, dan tinjauan manusia mengubah skor menjadi keputusan yang lebih aman.
Tentukan taksonomi dan kebijakan anotasi
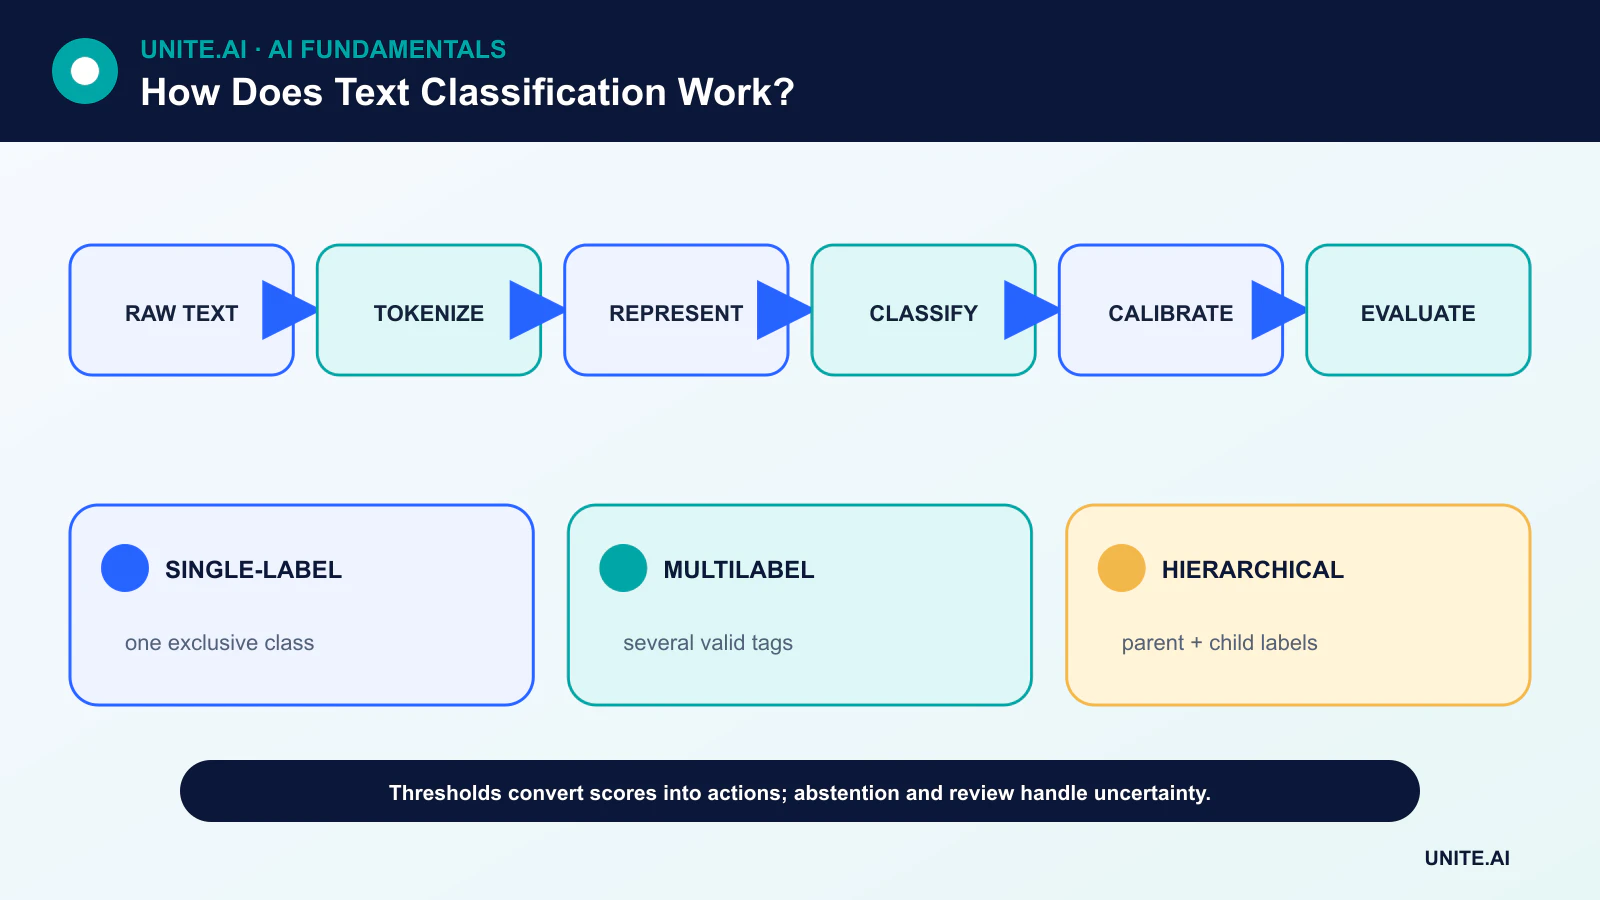
Tugas satu label memilih satu kelas yang saling eksklusif. Tugas multilabel dapat menetapkan beberapa tag independen. Taksonomi hierarkis berisi label induk dan anak. Ini merupakan masalah pembelajaran yang berbeda dan memerlukan output serta metrik yang berbeda.
Anotator memerlukan definisi, contoh positif dan negatif, aturan untuk konteks yang hilang, serta jalur eskalasi. Statistik kesepakatan dapat mengungkap tugas yang tidak jelas, namun ketidaksepakatan juga dapat mencerminkan ambiguitas nyata yang harus dipertahankan oleh sistem.
Merepresentasikan teks
Pipeline tradisional menggunakan hitungan token, n-gram, dan TF-IDF dengan classifier linier atau support vector machines. Mereka dilatih dengan cepat, menampilkan istilah yang berpengaruh, dan memberikan baseline yang kuat.
Sistem neural memetakan token ke embedding. Encoder transformer yang telah dilatih sebelumnya menggunakan attention untuk menghasilkan representasi kontekstual dan dapat disesuaikan (fine-tuned) dengan contoh berlabel. Classifier yang diprompt atau zero-shot dapat mengurangi pelabelan awal, namun pemilihan kata label, versi model, dan kalibrasinya harus dievaluasi pada domain yang sebenarnya.
Pelatihan tanpa kebocoran
Dataset dipisahkan menjadi data pelatihan, validasi, dan pengujian akhir. Dokumen hampir duplikat, pesan dari percakapan yang sama, atau templat dari sumber yang sama harus berada dalam satu split. Untuk penggunaan yang bergantung pada waktu, split kronologis lebih menggambarkan penerapan.
Ketidakseimbangan kelas dapat diatasi melalui pembobotan, resampling, pemilihan ambang, atau data tambahan. Contoh sintetis tidak boleh menggantikan peninjauan kegagalan kelas minoritas yang nyata dan dapat memperkenalkan artefak yang mudah dipelajari model.
Metrik dan keputusan terkalibrasi
Sebuah confusion matrix menunjukkan label mana yang kebingungan. Presisi mengukur berapa banyak prediksi positif yang benar; recall mengukur berapa banyak positif sebenarnya yang ditemukan. Rata-rata makro memberi bobot kelas secara setara, sementara rata-rata mikro memberi bobot contoh individual.
Skor softmax mentah tidak otomatis menjadi probabilitas yang dapat dipercaya. Kalibrasi membandingkan kepercayaan dengan kebenaran yang diamati. Tim dapat menetapkan ambang khusus kelas, abstain ketika kepercayaan rendah, dan mengarahkan kasus sensitif ke peninjau.
Penerapan, penggunaan multibahasa, dan drift
Teks berubah seiring produk, peristiwa, slang, dan perilaku adversarial. Pemantauan harus melacak bahasa input, panjang, pola out-of-vocabulary, tingkat kelas, kepercayaan, dan hasil yang tertunda. Pelatihan ulang memerlukan data berversi dan rangkaian regresi contoh penting.
Kinerja multibahasa harus diuji per bahasa dan dialek. Menerjemahkan semuanya ke satu bahasa dapat mengubah sentimen atau entitas; encoder multibahasa mungkin tetap tidak merata karena pra-pelatihannya dan labelnya tidak representatif secara setara.
Representasi dan keluarga classifier
Klasifikasi teks memetakan dokumen, kalimat, atau urutan token ke satu atau lebih label. Tentukan apakah label saling eksklusif, multilabel, hierarkis, berurutan, atau open-set. Pipeline tradisional mem-tokenisasi teks, membangun fitur bag-of-words atau TF–IDF, dan melatih logistic regression, naive Bayes, atau SVM linier. Sistem neural mempelajari embedding dengan konvolusi, recurrent, atau transformer. Model bahasa yang diprompt dapat mengklasifikasikan tanpa pelatihan khusus tugas, namun batasan output, biaya, drift, dan bukti tetap perlu dievaluasi terhadap baseline yang lebih sederhana.
Pra-pemrosesan tergantung pada representasi. Mengubah menjadi huruf kecil atau menghapus tanda baca dapat menghancurkan sinyal untuk nama, sentimen, kode, atau bahasa; stemming dapat menggabungkan makna yang berbeda. Tokenizer transformer beroperasi pada subkata dan memiliki batas panjang, sehingga strategi pemotongan penting. Dokumen panjang mungkin memerlukan pemotongan menjadi potongan dan agregasi. Pertahankan teks mentah dan versi transformasi, serta lakukan split berdasarkan penulis, percakapan, sumber, atau waktu untuk mencegah duplikat dekat dan templat berulang melintasi pelatihan dan pengujian.
Label, metrik, dan analisis kesalahan
Panduan anotasi harus mendefinisikan ruang lingkup, contoh, kasus ambigu, serta opsi unknown atau abstain. Ukur kesepakatan dan selesaikan ketidaksepakatan alih-alih menyembunyikannya dengan voting mayoritas. Untuk kelas yang tidak seimbang, akurasi tidak memadai; laporkan presisi, recall, F1, confusion, kalibrasi, dan beban kerja spesifik ambang per kelas. Tugas multilabel membutuhkan metrik mikro, makro, dan tingkat label. Evaluasi bahasa, dialek, domain, panjang pesan, dan waktu. Split acak dapat melebih-lebihkan kualitas ketika kosakata atau templat mengalami drift.
Analisis kesalahan harus memisahkan kegagalan representasi, konteks yang tidak cukup, ambiguitas label, kosakata langka, negasi, sarkasme, dan isyarat palsu. Gunakan tes kontrafaktual yang mengubah nama, penanda dialek, atau metadata tidak relevan sambil mempertahankan makna. Periksa kesalahan dengan kepercayaan tinggi dan kasus yang ditolak. Model dapat belajar bahwa saluran pelanggan atau tanda tangan memprediksi label alih-alih menafsirkan konten. Hapus kebocoran dan revisi data sebelum sekadar meningkatkan kapasitas model.
Desain produksi
Sediakan tokenizer dan model tetap dengan validasi skema, batas panjang, batching, serta fallback untuk bahasa yang tidak didukung atau kepercayaan rendah. Pantau distribusi input, tingkat label, kalibrasi, latensi, dan hasil yang ditinjau. Lindungi teks karena dapat berisi instruksi pribadi, rahasia, atau adversarial. Untuk moderasi otomatis, kelayakan, atau penentuan rute, sediakan mekanisme banding dan ukur kesalahan yang tidak merata. Versikan label dan ambang dengan kebijakan bisnis. Klasifikasi teks dapat diandalkan hanya dalam sistem label dan distribusi data yang telah didefinisikan; penjelasan model yang fasih tidak membuktikan bahwa klasifikasi tersebut benar.
Contoh kerja: mengklasifikasikan permintaan dukungan yang masuk
Tim dukungan mendefinisikan label rute yang saling eksklusif serta flag urgent, multibahasa, dan unknown. Anotator memberi label pada pesan yang di-deidentifikasi dengan panduan untuk isu campuran dan mengukur kesepakatan. Baseline logistic TF–IDF, encoder yang di-fine-tune, dan model yang diprompt menggunakan set pengujian berbasis waktu yang sama. Laporan evaluasi mencakup presisi dan recall kelas, false negative urgent, kalibrasi, validitas skema, latensi, dan biaya, dengan templat hampir duplikat dikelompokkan untuk menghindari kebocoran.
Classifier yang diterapkan memvalidasi bahasa dan panjang, abstain pada bukti lemah, dan memungkinkan agen memperbaiki rute. Prompt dan pesan diperlakukan tidak dapat dipercaya; akses alat tidak tersedia. Pemantauan melacak prevalensi label, kepercayaan, koreksi, waktu respons, dan topik yang muncul. Kebijakan atau perubahan produk memperbarui taksonomi dan data pelatihan ulang melalui tinjauan. Sistem meningkatkan penempatan antrian, namun tidak pernah menyimpulkan emosi atau hak pelanggan di luar label yang telah divalidasi.
Bukti implementasi dan kesiapan operasional
Keputusan produksi memerlukan lebih dari demonstrasi yang berhasil. Tentukan pengguna yang dimaksud, lingkungan operasional, input, output, ketergantungan, pemilik, dan konsekuensi dari setiap kegagalan penting. Bangun baseline yang dapat direproduksi dan set evaluasi berversi sebelum penyetelan. Uji kasus biasa, kondisi batas, input yang rusak atau hilang, pergeseran distribusi, kegagalan ketergantungan, penyalahgunaan, serta grup atau lingkungan yang paling mungkin kurang terlayani. Ukur kualitas tugas bersama kalibrasi atau ketidakpastian, latensi, throughput, biaya sumber daya, aksesibilitas, privasi, dan keamanan. Catat setiap transformasi dan ambang sehingga peninjau independen dapat mereproduksi hasil dan membedakan bukti dari prototipe yang menarik.
Sebelum peluncuran, tetapkan otoritas untuk rilis, pengecualian, perubahan, rollback, dan pensiun. Gunakan peluncuran bertahap, pertahankan fallback yang aman, dan verifikasi pemantauan dengan kegagalan yang sengaja disuntikkan. Telemetri operasional harus mengungkap kualitas input, perilaku output, versi model atau aturan, kesehatan ketergantungan, intervensi manusia, dan hasil yang dikonfirmasi tanpa mengumpulkan data sensitif yang tidak diperlukan. Tentukan ambang peringatan dan pemilik respons, kemudian tinjau bukti dunia nyata setelah penerapan alih-alih mengasumsikan kinerja offline akan bertahan. Evaluasi kembali setiap kali sumber data, pengguna, model, vendor, kebijakan, perangkat keras, atau tujuan berubah. Sistem yang dipelihara juga memerlukan prosedur pemulihan terdokumentasi, pembelajaran insiden, penghapusan dan retensi, serta titik yang jelas di mana sistem harus dinonaktifkan atau diganti.
Pertanyaan yang sering diajukan
Apakah analisis sentimen merupakan tugas klasifikasi teks?
Biasanya ya, namun sentimen dapat bersifat multilabel, berbasis aspek, atau kontinu daripada satu label positif/neutral/negatif.
Kapan classifier teks harus abstain?
Ketika kepercayaan rendah, teks berada di luar lingkup, konteks yang diperlukan tidak ada, atau biaya tindakan otomatis yang salah melebihi biaya peninjauan.
Referensi utama












