Dasar-dasar AI
Apa itu Overfitting?

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
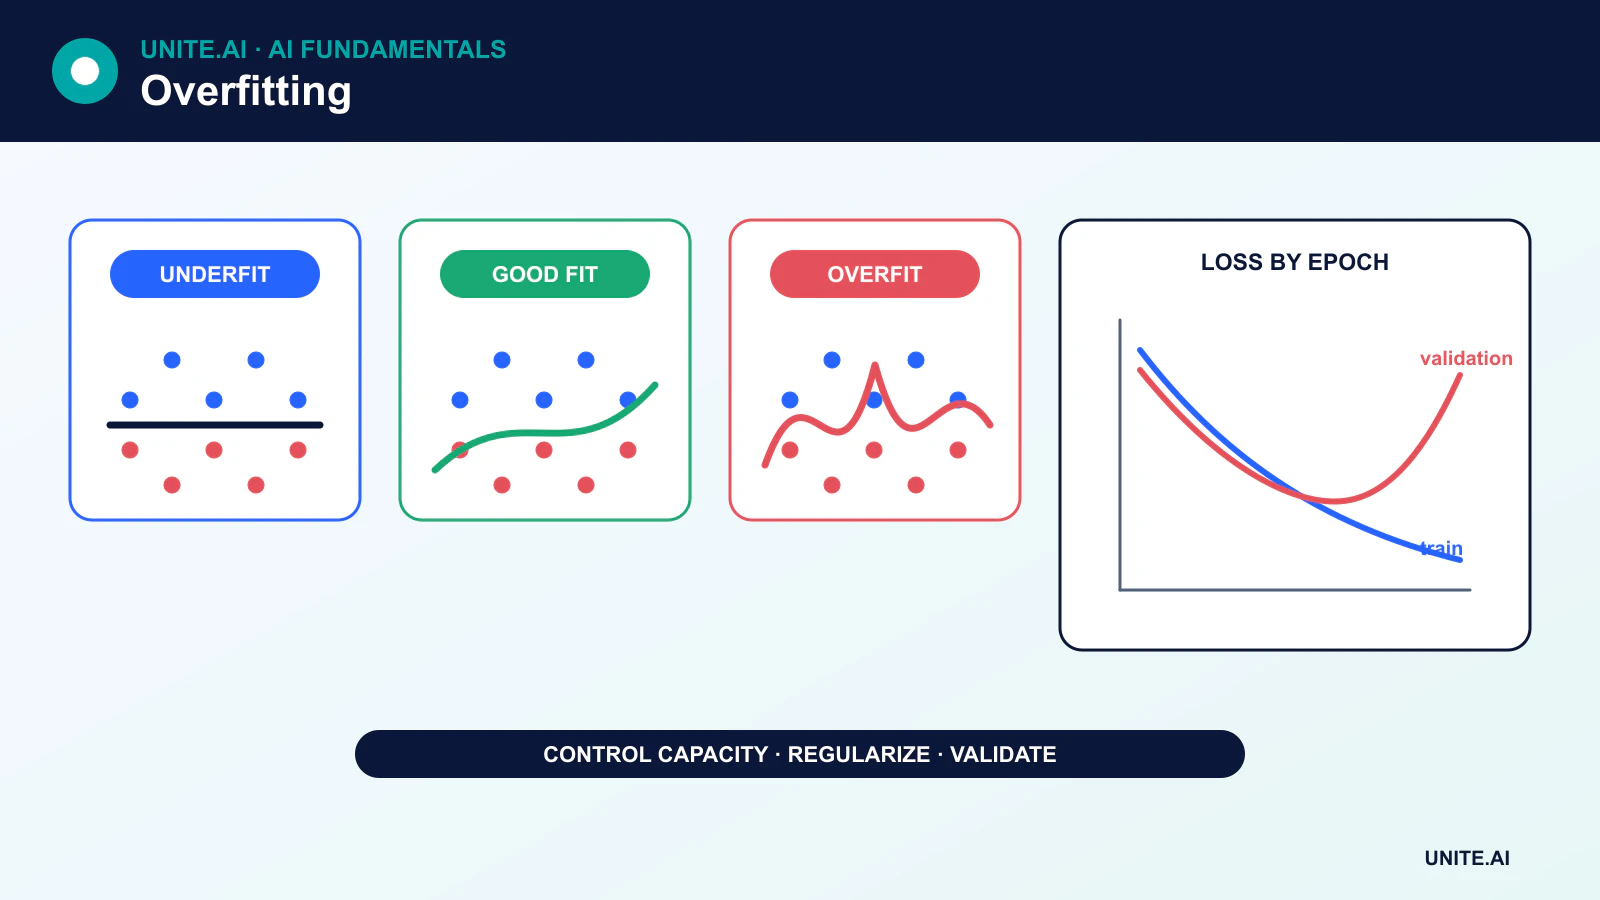
Overfitting terjadi ketika sebuah model menangkap pola atau noise yang bekerja sangat baik pada data pelatihan tetapi gagal untuk digeneralisasikan ke contoh baru. Model yang overfit dapat memiliki kesalahan pelatihan yang sangat rendah sementara kinerja pada validasi atau dunia nyata secara signifikan lebih buruk.
Masalah sebaliknya adalah underfitting: model atau proses pelatihan tidak dapat menangkap cukup sinyal bahkan pada set pelatihan. Pemodelan yang baik menyeimbangkan kecocokan dengan generalisasi daripada mengejar kinerja pelatihan yang sempurna.
Poin-poin utama
- Kinerja pelatihan saja tidak dapat mendiagnosis generalisasi.
- Early stopping harus menggunakan perilaku validasi, tidak pernah membuat keputusan berulang pada set tes akhir.
- Lebih banyak data dapat membantu, tetapi lebih banyak fitur atau kapasitas juga dapat memperburuk overfitting.
- Regularisasi, augmentasi, cross-validation, pencegahan leakage, dan evaluasi yang tepat menangani penyebab yang berbeda.
Kecocokan, underfitting, dan overfitting
Model mengalami underfit ketika asumsi-asumsinya terlalu ketat, fiturnya mengabaikan sinyal penting, optimisasi tidak memadai, atau pelatihan tidak cukup. Menambahkan fitur atau kapasitas yang relevan dapat membantu, tetapi menambahkan fitur secara sembarangan dapat meningkatkan noise dan overfitting.
Model overfit ketika kapasitas efektifnya terlalu tinggi dibandingkan dengan informasi dalam data pelatihan. Contohnya termasuk decision tree yang dalam dan menghasilkan daun‑daun kecil, sebuah polinomial yang mengikuti fluktuasi acak, atau jaringan saraf yang menghafal contoh.
Peran data pelatihan, validasi, dan pengujian
- Data pelatihan menyesuaikan parameter model.
- Data validasi memilih arsitektur, hiperparameter, ambang batas, dan waktu penghentian.
- Data pengujian memberikan perkiraan akhir setelah pilihan‑pilihan tersebut selesai.
Jika set pengujian berulang kali menjadi panduan keputusan, ia menjadi bagian dari proses pengembangan dan tidak lagi memberikan perkiraan akhir yang tidak bias. Cross-validation dapat memanfaatkan data terbatas secara lebih efisien, tetapi semua pra‑pemrosesan dan pemilihan fitur harus dilakukan di dalam setiap lipatan pelatihan.
Early stopping
Selama pelatihan, loss pelatihan biasanya terus menurun. Loss validasi mungkin turun pada awalnya dan kemudian naik karena model menjadi khusus pada noise pelatihan. Early stopping menyimpan checkpoint dengan tujuan validasi terbaik atau menghentikan pelatihan setelah validasi tidak membaik selama periode kesabaran yang ditentukan.
Checkpoint yang tepat bukan yang memiliki loss pelatihan terendah. Set pengujian akhir yang terpisah dievaluasi setelah keputusan early‑stopping dan penyesuaian selesai.
Metode regularisasi
Penalti bobot
Regularisasi L2 atau weight decay mengurangi nilai parameter yang besar. Regularisasi L1 dapat mendorong koefisien yang jarang. Efeknya tergantung pada model dan optimizer; misalnya, AdamW memisahkan weight decay dari pembaruan adaptif.
Dropout dan regularisasi stokastik
Dropout secara acak menutupi aktivasi selama pelatihan. Metode lain men‑drop jalur, mengganggu fitur, atau melicinkan label. Teknik ini mengubah tujuan pelatihan dan harus dinonaktifkan atau ditangani secara tepat pada fase inferensi.
Augmentasi data
Augmentasi menciptakan variasi realistis—seperti pemotongan, rotasi, noise, atau parafrase—yang harus mempertahankan target. Transformasi yang tidak valid dapat mengubah label dan merusak model. Untuk visi, alat seperti Albumentations membantu menerapkan pipeline yang terkontrol.
Kontrol kapasitas
Pohon yang lebih dangkal, lebih sedikit parameter, pemilihan fitur, pemangkasan, dan kelas hipotesis yang lebih sederhana dapat mengurangi varians. Pemangkasan pohon didasarkan pada kriteria, bukan penghapusan acak detail yang dipelajari.
Data leakage dapat terlihat seperti kinerja luar biasa
Leakage terjadi ketika informasi yang tidak tersedia pada saat prediksi masuk ke pelatihan atau evaluasi. Contoh umum meliputi menyesuaikan normalisasi pada seluruh dataset, membagi rekaman yang berulang di antara lipatan, menggunakan data masa depan untuk memprediksi masa lalu, atau menyertakan fitur yang berasal dari target.
Leakage bukan overfitting biasa, tetapi menciptakan kesenjangan menyesatkan yang sama antara hasil offline dan penerapan. Strategi pembagian harus menghormati waktu, identitas, lokasi, dan proses pembuatan data.
Perubahan distribusi adalah masalah terpisah
Model dapat menggeneralisasi ke distribusi tesnya namun tetap gagal ketika data produksi berubah. Perangkat baru, kebijakan, populasi, musim, atau perilaku adversarial dapat mengubah hubungan input atau target. Pemantauan dan evaluasi berkala diperlukan bahkan ketika model asli tidak overfit.
Mendiagnosa overfitting
Gunakan kurva pembelajaran, varians cross‑validation, metrik subkelompok, kalibrasi, dan inspeksi kesalahan. Jika kinerja pelatihan dan validasi keduanya buruk, fokus pada underfitting, fitur, label, atau optimisasi. Jika pelatihan kuat dan validasi lemah, selidiki kapasitas, leakage, regularisasi, dan representativitas sebelum sekadar mengumpulkan lebih banyak data.
Mengapa overfitting terjadi dan bagaimana mendeteksinya
Overfitting terjadi ketika model mempelajari pola yang mengurangi kesalahan pelatihan tetapi tidak dapat digeneralisasikan ke populasi target. Penyebabnya meliputi kapasitas berlebih relatif terhadap data efektif, noise label, entitas yang berulang, pemilihan fitur yang fleksibel, leakage, dan penyetelan terhadap set validasi yang sama. Kesenjangan yang melebar antara kinerja pelatihan dan validasi merupakan bukti umum, tetapi kesenjangan kecil tidak menyingkirkan overfitting jika kedua set terkontaminasi atau berbeda dari penerapan. Kurva pembelajaran berdasarkan volume data dan kapasitas membantu membedakan varians dari bias.
Leakage sangat menipu: informasi masa depan, duplikat, tumpang tindih subjek, pra‑pemrosesan yang disesuaikan pada semua data, atau label yang dikodekan dalam metadata dapat menghasilkan skor held‑out yang luar biasa. Bagi data berdasarkan unit yang akan baru pada penerapan—pasien, pelanggan, mesin, lokasi, atau waktu—sebelum menyesuaikan transformasi atau augmentasi. Simpan set tes akhir tetap tertutup saat memilih fitur, arsitektur, dan ambang batas. Jika tim berulang kali memeriksa hasil tes, set tes menjadi set validasi lain dan perlu diganti atau diperbaiki secara formal.
Regularisasi, pemilihan model, dan drift produksi
Kurangi overfitting dengan data yang lebih representatif, kapasitas yang lebih rendah, weight decay, dropout, early stopping, augmentasi, ensembling, atau kendala yang mencerminkan struktur domain. Setiap metode memiliki trade‑off: augmentasi dapat mengubah label, dropout mengubah optimisasi, dan ensemble menambah biaya penyajian. Cross‑validation memperkirakan variabilitas pemilihan, tetapi lipatan yang dikelompokkan atau sadar waktu harus mempertahankan batas penerapan. Bandingkan dengan model sederhana dan laporkan ketidakpastian di seluruh lipatan atau seed daripada memilih run yang paling menguntungkan.
Produksi dapat mengungkap bentuk kegagalan generalisasi yang berbeda ketika input, pengguna, insentif, atau pengukuran berubah. Pantau distribusi fitur dan prediksi, kalibrasi, hasil subkelompok, dan ground truth yang tertunda. Jangan melatih ulang secara otomatis pada umpan balik yang belum ditinjau; keputusan model sendiri dapat membentuk label yang kemudian dilihatnya. Diagnosa apakah kegagalan berasal dari drift, pipeline data, perubahan kebijakan, atau target yang tidak valid. Overfitting dikendalikan oleh desain eksperimen dan disiplin siklus hidup, bukan oleh satu pengaturan regularisasi.
Contoh kerja: menghilangkan leakage dalam model penipuan
Klasifier penipuan awal memperoleh skor yang sangat tinggi karena peristiwa kartu dan pedagang yang berulang muncul secara acak di baris pelatihan dan pengujian, dan informasi chargeback yang dicatat beberapa minggu kemudian dimasukkan sebagai fitur. Tim merekonstruksi waktu ketersediaan setiap fitur, menghapus bidang pasca‑keputusan, mengelompokkan berdasarkan akun, dan menggunakan pembagian waktu maju. Kinerja turun tajam tetapi kini memperkirakan keputusan sebenarnya. Baseline aturan sederhana dan kurva pembelajaran memandu kompleksitas model yang dibutuhkan.
Regularisasi dan early stopping disetel hanya dalam lipatan historis. Evaluasi akhir melaporkan presisi pada kapasitas peninjauan, recall, kalibrasi, dan biaya berdasarkan jenis penipuan serta segmen pelanggan. Dalam produksi, label yang dikonfirmasi datang terlambat dan bias oleh transaksi mana yang ditinjau, sehingga pemantauan memisahkan drift skor dari perkiraan hasil. Pelatihan ulang menggunakan kasus yang telah diputuskan dan diputar ulang terhadap kebijakan saat ini. Proyek lebih memilih skor jujur yang lebih rendah daripada skor tinggi yang bocor dan tidak dapat bertahan di produksi.
Bukti implementasi dan kesiapan operasional
Keputusan produksi membutuhkan lebih dari sekadar demonstrasi yang berhasil. Tentukan pengguna yang dimaksud, lingkungan operasi, masukan, keluaran, ketergantungan, pemilik, dan konsekuensi dari setiap kegagalan penting. Bangun baseline yang dapat direproduksi dan set evaluasi berversi sebelum penyetelan. Uji kasus biasa, kondisi batas, masukan yang rusak atau hilang, pergeseran distribusi, gangguan ketergantungan, penyalahgunaan, serta grup atau lingkungan yang paling mungkin kurang terlayani. Ukur kualitas tugas bersama dengan kalibrasi atau ketidakpastian, latensi, throughput, biaya sumber daya, aksesibilitas, privasi, dan keamanan. Catat setiap transformasi dan ambang batas sehingga peninjau independen dapat mereproduksi hasil dan membedakan bukti dari prototipe yang menarik.
Sebelum peluncuran, tetapkan otoritas untuk rilis, pengecualian, perubahan, rollback, dan pensiun. Gunakan peluncuran bertahap, pertahankan fallback yang aman, dan verifikasi pemantauan dengan kegagalan yang sengaja disuntikkan. Telemetri operasional harus mengungkap kualitas masukan, perilaku keluaran, versi model atau aturan, kesehatan ketergantungan, intervensi manusia, dan hasil yang dikonfirmasi tanpa mengumpulkan data sensitif yang tidak diperlukan. Tentukan ambang batas peringatan dan pemilik respons, kemudian tinjau bukti dunia nyata setelah penerapan alih‑alih mengasumsikan kinerja offline akan bertahan. Evaluasi kembali setiap kali sumber data, pengguna, model, vendor, kebijakan, perangkat keras, atau tujuan berubah. Sistem yang dipelihara juga memerlukan dokumentasi pemulihan, pembelajaran insiden, prosedur penghapusan dan retensi, serta titik yang jelas di mana sistem harus dinonaktifkan atau diganti.
Pertanyaan yang sering diajukan
Apakah model sederhana dapat overfit?
Ya. Pemilihan fitur yang berulang, penyetelan ambang batas, atau evaluasi pada holdout yang sama dapat menyebabkan overfit pada proses pengembangan meskipun model akhir sederhana.
Apakah lebih banyak data pelatihan selalu menyelesaikan overfitting?
Tidak. Data yang lebih representatif dan berlabel benar dapat membantu, tetapi data yang duplikat, bias, bocor, atau di luar domain mungkin tidak. Tujuan pembelajaran dan desain evaluasi tetap penting.
Referensi utama