
Dasar-dasar AI
Apa Itu Analisis Sentimen? Metode, Penggunaan, dan Batasan

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
Analisis sentimen memperkirakan bahasa evaluatif dalam teks, transkrip pidato, atau konten lainnya. Sebuah sistem dapat mengklasifikasikan polaritas seperti positif, negatif, atau netral; mendeteksi opini pada tingkat aspek; memperkirakan intensitas; atau mengidentifikasi sikap terhadap klaim tertentu.
Target harus didefinisikan dengan hati-hati. Sentimen tidak sama dengan emosi, niat, toksisitas, kepuasan, atau kebenaran. Sebuah kalimat positif dapat menggambarkan peristiwa berbahaya secara sarkastik, sementara ulasan produk yang negatif masih dapat merekomendasikan produk secara keseluruhan.
Poin-poin utama
- Tentukan unit, target, label, dan konteks sebelum mengumpulkan contoh.
- Leksikon adalah baseline yang transparan; model terawasi dan transformer dapat menangkap lebih banyak konteks tetapi memerlukan data yang representatif.
- Negasi, sarkasme, kosakata domain, teks multibahasa, dan batas aspek tetap sulit.
- Lakukan evaluasi per kelas, subkelompok, domain, dan periode waktu; sertakan tinjauan manusia untuk penggunaan yang berdampak.
Tingkat dan target
Analisis tingkat dokumen menghasilkan satu label untuk seluruh item. Analisis tingkat kalimat memisahkan pernyataan, sementara analisis berbasis aspek mengaitkan sentimen dengan entitas atau atribut—misalnya, positif tentang kualitas gambar tetapi negatif tentang daya tahan baterai.
Sikap menanyakan apakah pembicara mendukung proposisi tertentu, yang dapat berbeda dari nada emosional. Perbedaan ini harus ditetapkan dalam panduan anotasi sebelum menerapkan metode klasifikasi teks.
Leksikon, model klasik, dan transformer
Leksikon memberikan skor pada kata dan menggabungkannya dengan aturan untuk negasi atau intensitas. Leksikon dapat diinterpretasikan dan murah tetapi kesulitan dengan konteks. Model terawasi klasik menggunakan fitur kata atau n-gram, sementara transformer mempelajari representasi kontekstual dan dapat disesuaikan (fine‑tuned).
Prompting few‑shot mungkin praktis, tetapi output bergantung pada contoh dan pemilihan kata. Bandingkan setiap pendekatan kompleks dengan baseline dan gunakan few‑shot learning hanya dengan set evaluasi yang dipisahkan dan berversi.
Tantangan data dan bahasa
Label dapat mencerminkan perspektif anotator daripada fakta objektif. Perpindahan domain sangat signifikan: ‘tidak dapat diprediksi’ dapat menjadi pujian untuk sebuah film dan kritik untuk sebuah kendaraan. Pergantian kode, dialek, emoji, kutipan ucapan, dan ironi mempersulit sinyal pada tingkat token.
Seimbangkan kelas secara sengaja dan hindari kebocoran penulis, produk, atau percakapan terkait antara data latih dan uji. Model yang menghafal merek atau pembicara dapat tampak akurat tanpa benar‑benar mempelajari sentimen.
Evaluasi dan penggunaan yang bertanggung jawab
Laporkan presisi, recall, F1, dan confusion matrix alih‑alih hanya akurasi. Tinjau kesalahan berdasarkan aspek, panjang, dialek, dan waktu, serta kalibrasi ambang batas untuk biaya operasional setiap kesalahan.
Tren agregat dapat mendukung riset atau triase, tetapi menyimpulkan keadaan individu atau membuat keputusan terkait pekerjaan, kredit, kesehatan, atau penegakan hukum menimbulkan risiko yang lebih besar. Sediakan ketidakpastian, konteks sumber, kontrol privasi, dan tinjauan manusia.
Anotasi dan konstruksi dataset
Tulislah panduan anotasi dengan entitas target, unit analisis, definisi label, penanganan campuran dan netral, aturan kutipan, kebijakan sarkasme, serta contoh dari domain. Lakukan pilot dengan beberapa anotator, hitung kesepakatan, diskusikan perbedaan, dan revisi tugas sebelum memperluas label.
Sampling menentukan apa yang dipelajari model. Aliran media sosial dapat melebih-lebihkan akun yang sangat aktif; tiket dukungan dapat mengabaikan pelanggan yang puas; rating bintang mungkin tidak sesuai dengan teks ulasan. Pertahankan metadata sumber dan waktu, hormati ketentuan platform serta privasi, dan buat set uji dari populasi tempat keputusan akan diambil.
Kebocoran label dapat terjadi melalui rating, emoji yang dimasukkan oleh sistem pengumpulan, tanda tangan templat, atau nama produk yang terkait dengan sentimen. Hapus duplikat posting yang hampir identik dan kelompokkan percakapan atau penulis sehingga bahasanya tidak muncul di kedua sisi pembagian.
Pilihan pemodelan dan kalibrasi
Sistem leksikon menjumlahkan skor kata dan menyesuaikan untuk negasi, intensifier, tanda baca, atau emoji. Mereka memberikan pemeriksaan sanity yang berguna dan dapat disesuaikan dengan istilah domain. Model linier dengan fitur TF–IDF tetap kompetitif pada beberapa dataset dan mengungkap n‑gram yang berpengaruh.
Encoder kontekstual merepresentasikan kata menurut teks sekitarnya dan dapat disesuaikan untuk polaritas atau aspek. Dokumen panjang mungkin memerlukan model hierarkis, agregasi kalimat, atau pengambilan span yang relevan. Pendekatan multibahasa dapat melatih satu model bersama, menerjemahkan ke bahasa pivot, atau mempertahankan model lokal; masing‑masing memiliki cakupan dan pertukaran budaya.
Kalibrasi probabilitas penting ketika skor memicu tindakan. Plot keandalan dan expected calibration error mengungkap apakah kepercayaan 0,8 yang dilaporkan sesuai dengan sekitar 80 % kebenaran. Ambang batas dapat menciptakan zona abstain untuk tinjauan manusia, dan ambang terpisah dapat dibenarkan ketika biaya kesalahan berbeda—bukan untuk menyembunyikan kualitas yang tidak setara.
Aplikasi dan kesalahpahaman umum
Sentimen agregat dapat membantu memprioritaskan tema, membandingkan reaksi kampanye, atau mengarahkan pesan layanan yang mendesak. Analisis aspek seringkali lebih dapat ditindaklanjuti daripada polaritas keseluruhan karena mengidentifikasi apa yang dibicarakan orang. Analisis tren memerlukan sampling yang stabil dan definisi label yang konsisten sepanjang waktu.
Jangan menyamakan prevalensi posting negatif dengan opini populasi. Perilaku posting, bot, moderasi, demografi platform, kampanye, dan kueri pengumpulan membentuk sampel. Model sentimen tidak mengukur populasi yang diam, dan perubahan kata dapat tampak seperti perubahan sikap.
Untuk keputusan individual, label palsu dapat menstigmatisasi dan sulit dipertentangkan. Hindari menggunakan sentimen sebagai proksi untuk keterlibatan karyawan, kesehatan mental, kelayakan kredit, niat, atau penipuan. Ketika orang terpengaruh, tunjukkan konteks sumber, izinkan koreksi, dan persyaratkan pembuat keputusan manusia dengan kebijaksanaan nyata.
Contoh terapan: analisis sentimen untuk umpan balik pelanggan
Sebuah perusahaan yang menganalisis komentar dukungan harus menentukan apakah ia membutuhkan sentimen dokumen, sentimen aspek, emosi, urgensi, atau klasifikasi isu. ‘Pengiriman cepat tetapi produk rusak’ tidak dapat direpresentasikan secara akurat dengan satu label positif‑atau‑negatif. Buat panduan anotasi untuk target, negasi, sarkasme, pernyataan campuran, kutipan ucapan, dan kasus tidak diketahui, lalu ukur kesepakatan sebelum memperlakukan label sebagai kebenaran dasar.
Bandingkan leksikon atau baseline linier dengan encoder yang disesuaikan atau model bahasa yang diprompt. Bagi data berdasarkan waktu atau pelanggan untuk mencegah kebocoran duplikat dekat, dan pertahankan prevalensi kelas. Laporkan presisi, recall, F1, kalibrasi, dan confusion berdasarkan bahasa, saluran, produk, serta proksi demografis hanya bila sah dan beralasan. Tinjau kesalahan dengan kepercayaan tinggi karena lebih berbahaya dalam penyaluran otomatis dibandingkan output yang tidak pasti dan harus dinaikkan.
Gunakan sentimen sebagai satu sinyal untuk agregasi atau prioritas, bukan sebagai ukuran tak terbantahkan atas keadaan seseorang. Pantau pergeseran kosakata dan produk, latih ulang dengan contoh yang ditinjau, dan izinkan agen memperbaiki label. Jangan pernah menyimpulkan sifat yang dilindungi atau mendisiplinkan pekerja berdasarkan skor sentimen yang tidak tervalidasi. Untuk pelaporan eksekutif, tunjukkan ukuran sampel, ketidakpastian, data yang hilang, dan topik yang mendorong perubahan sehingga skor yang berfluktuasi memicu penyelidikan bukan kesimpulan sederhana.
Penerapan multibahasa tidak boleh mengasumsikan bahwa menerjemahkan masukan mempertahankan nada, negasi, idiom, atau konvensi budaya. Validasi setiap bahasa yang didukung dan pola campuran bahasa dengan peninjau native, serta berikan hasil tidak diketahui ketika bukti lemah. Adaptasi domain juga penting: kata yang terdengar negatif dalam percakapan biasa mungkin merupakan deskripsi teknis netral. Pertahankan ambang batas atau model terpisah hanya bila bukti operasional membenarkan kompleksitas dan beban tata kelola tambahan.
Daftar periksa implementasi praktis
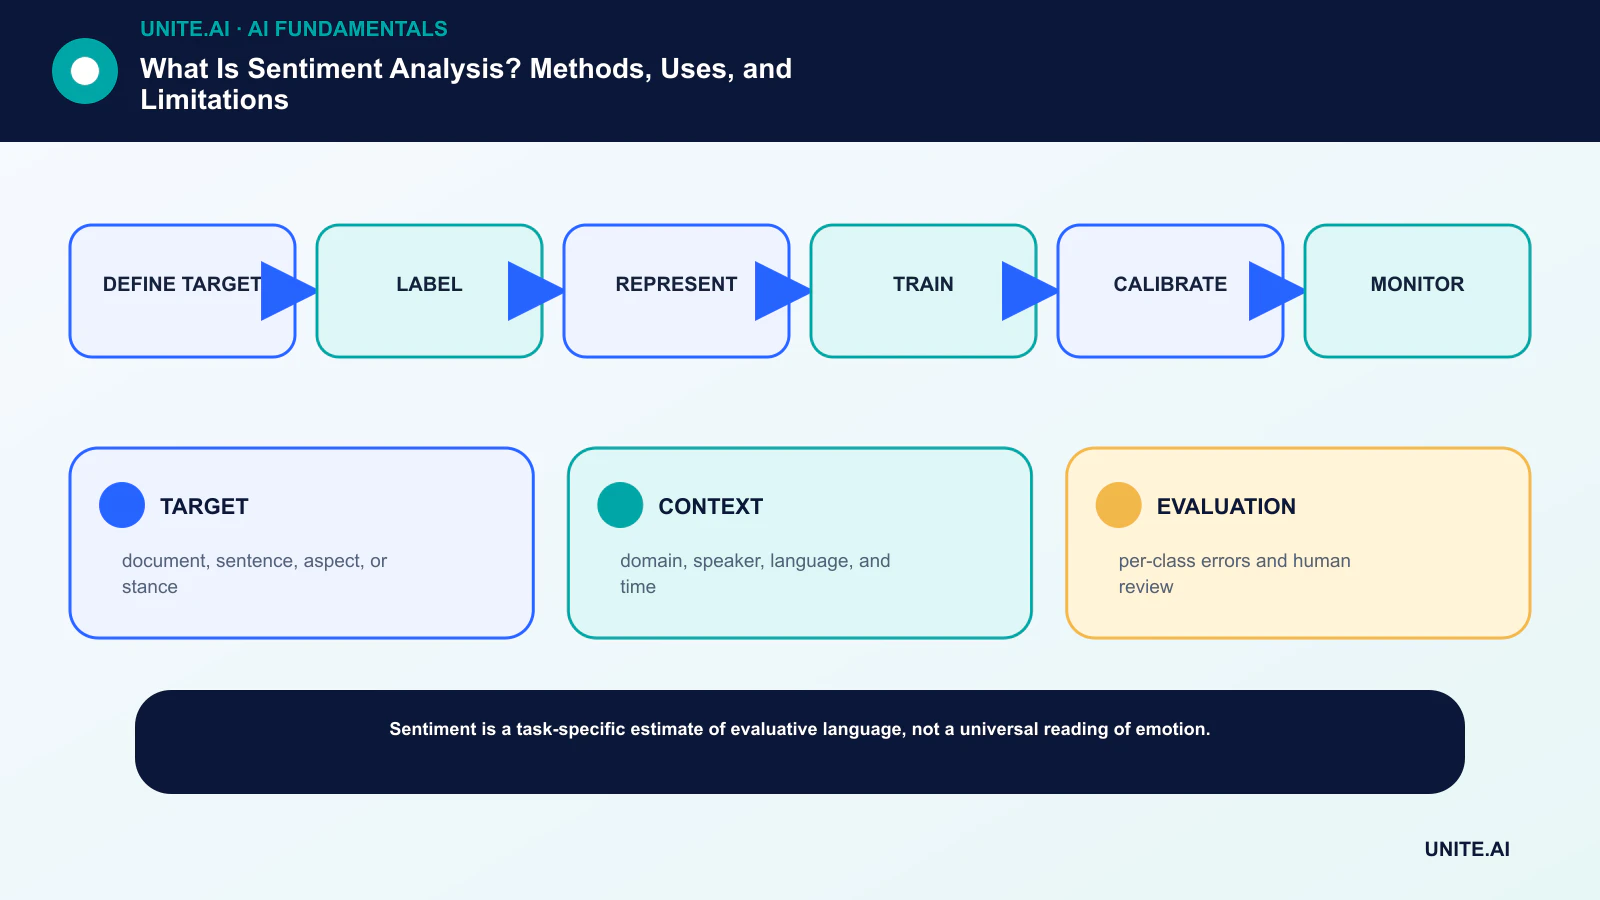
Ubah konsep menjadi alur kerja yang terbatas dan dapat diuji: definisikan target → label → representasi → pelatihan → kalibrasi → pemantauan. Tunjuk pemilik yang bertanggung jawab, dokumentasikan data dan ketergantungan, tetapkan baseline sederhana, tetapkan kriteria penerimaan dan penghentian, uji kegagalan representatif, serta definisikan pemantauan, rollback, dan tinjauan sebelum memperluas lingkup. Catat versi dan asumsi sehingga tim lain dapat mereproduksi hasil dan memahami apa yang berubah.
Sebelum peluncuran, lakukan tinjauan kesiapan yang terdokumentasi bersama orang‑orang yang membangun, mengoperasikan, mengamankan, dan terpengaruh oleh sistem. Uji kasus normal, kondisi batas, kegagalan ketergantungan, dan penyalahgunaan; simpan bukti dan risiko yang belum terselesaikan. Tentukan siapa yang dapat menyetujui rilis, mengubah ambang batas, mengganti output, atau menghentikan operasi. Tinjau kembali keputusan setelah data dunia nyata muncul, karena pilot yang secara teknis berhasil tidak menjamin kinerja andal pada skala yang lebih luas.
- TARGET: dokumen, kalimat, aspek, atau sikap.
- CONTEXT: domain, pembicara, bahasa, dan waktu.
- EVALUATION: kesalahan per‑kelas dan tinjauan manusia.
Pertanyaan yang sering diajukan
Apakah analisis sentimen bersifat objektif?
Tidak. Ia memperkirakan label yang didefinisikan oleh tugas dan proses anotasi. Beberapa teks memang ambigu, campuran, bergantung pada konteks, atau ditafsirkan berbeda oleh pembaca.
Bisakah analisis sentimen mendeteksi sarkasme?
Model dapat mempelajari beberapa pola, tetapi sarkasme sering bergantung pada riwayat pembicara, pengetahuan bersama, dan konteks di luar teks. Hal ini tetap menjadi mode kegagalan yang umum.
Referensi utama












