Dasar-dasar AI
Apa itu Teorema Bayes?

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
Teorema Bayes menjelaskan cara memperbarui probabilitas suatu hipotesis setelah mengamati bukti. Ia menghubungkan probabilitas bukti diberikan hipotesis dengan probabilitas hipotesis diberikan bukti tersebut.
Perbedaan ini menjadi inti dari penalaran statistik dan pembelajaran mesin. Sebuah tes dapat sangat akurat ketika suatu kondisi ada, namun hasil positif masih memiliki probabilitas yang wajar untuk menunjukkan kondisi tersebut jika kondisi itu jarang.
Poin penting
- Posterior menggabungkan kepercayaan prior dengan kemungkinan bukti yang diamati.
- Istilah bukti menormalkan hipotesis yang mungkin.
- Base rate dapat mendominasi bukti yang tampak kuat.
- Naive Bayes mengasumsikan fitur-fitur bersifat kondisional independen diberikan kelas, bukan independen dalam setiap situasi.
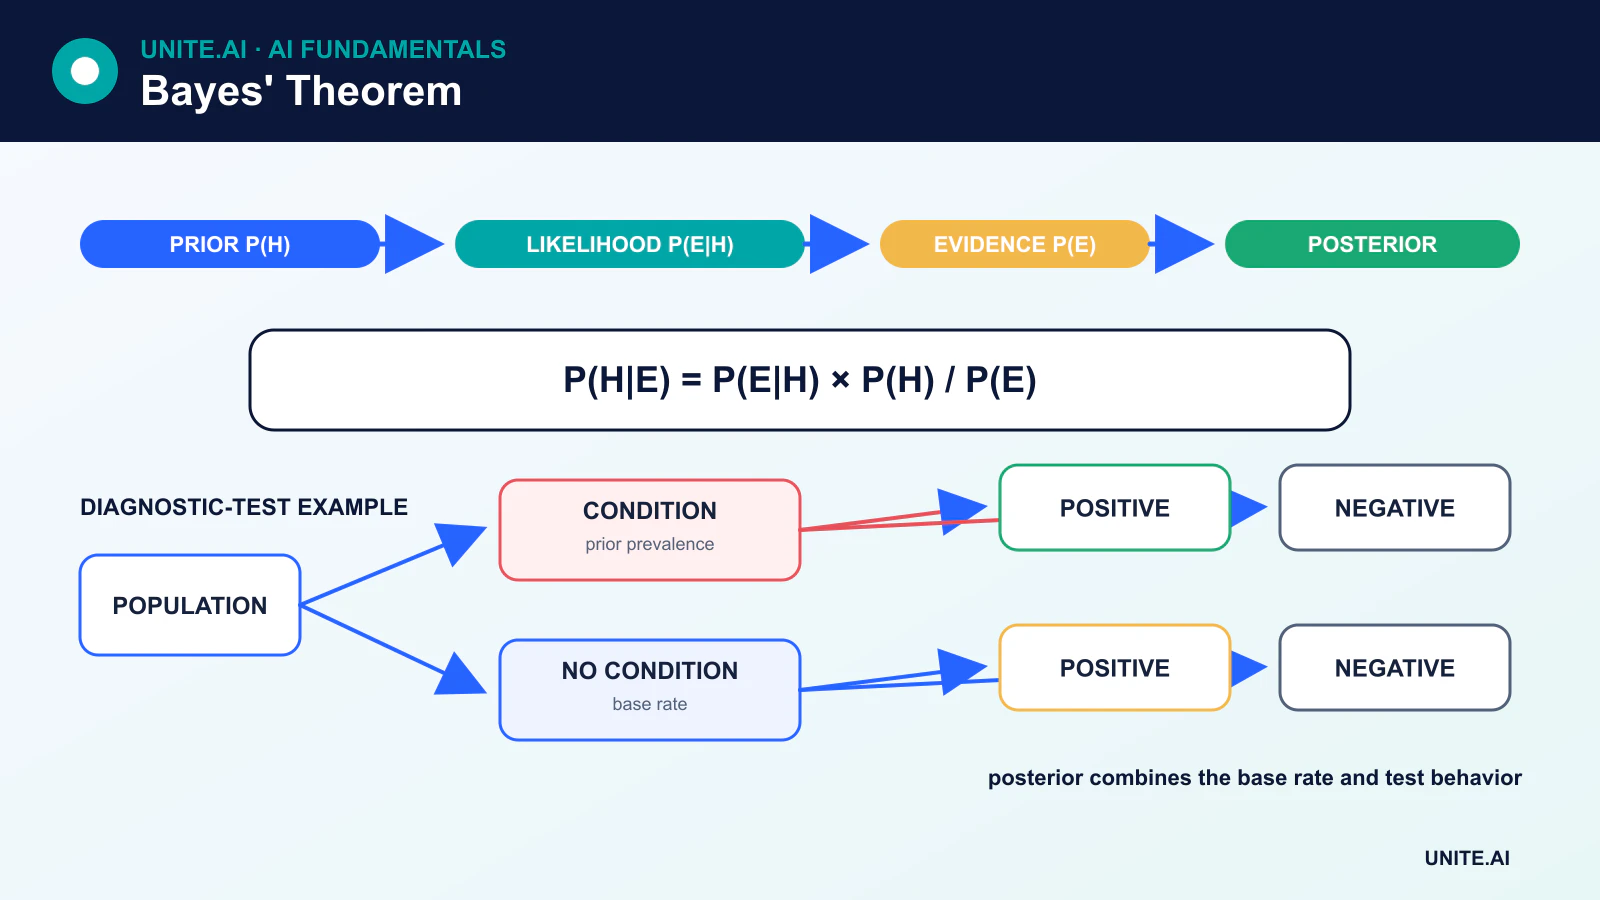
Rumus
P(A|B) = P(B|A)P(A) / P(B)
- P(A) adalah probabilitas prior dari hipotesis A.
- P(B|A) adalah kemungkinan mengamati bukti B jika A benar.
- P(B) adalah probabilitas keseluruhan dari bukti.
- P(A|B) adalah probabilitas posterior A setelah mengamati B.
Teorema ini berasal dari dua ekspresi ekivalen untuk probabilitas gabungan: P(A ∩ B) = P(B|A)P(A) dan P(A ∩ B) = P(A|B)P(B).
Contoh numerik base-rate
Misalkan suatu kondisi memengaruhi 1% populasi. Sebuah tes memiliki sensitivitas 90% dan tingkat false-positive 5%. Pertimbangkan 1.000 orang:
- Sekitar 10 orang memiliki kondisi tersebut; tes secara benar menandai 9 orang.
- Sekitar 990 orang tidak memiliki kondisi; tingkat false-positive 5% menandai kira-kira 50 orang.
- Sehingga terdapat sekitar 59 hasil positif, di mana 9 di antaranya adalah positif sejati.
Probabilitas kondisi setelah hasil positif adalah sekitar 9 / 59 ≈ 15%, bukan 90%. Sensitivitas tes menjawab P(positif | kondisi); pengguna biasanya menginginkan P(kondisi | positif). Teorema Bayes menghubungkan keduanya menggunakan base rate.
Pembaruan Bayesian
Ketika bukti baru muncul, posterior dapat menjadi prior untuk pembaruan selanjutnya. Model Bayesian lengkap menentukan hipotesis yang mungkin, distribusi prior, likelihood, dan kuantitas yang akan diperkirakan. Ketidakpastian direpresentasikan dengan distribusi posterior, bukan hanya estimasi titik.
Prior harus didokumentasikan dan diuji sensitivitasnya. Prior yang lemah informatif dapat meregularisasi nilai yang tidak masuk akal, sementara prior kuat yang dipilih buruk dapat mendominasi data terbatas.
Klasifier Naive Bayes
Naive Bayes memprediksi kelas y dari fitur x₁ … xₙ menggunakan teorema Bayes dan asumsi:
P(x₁, …, xₙ | y) = Π P(xᵢ | y)
Fitur-fitur diasumsikan kondisional independen setelah kelas diketahui. Hal ini sering tidak realistis, namun classifier dapat bekerja baik ketika skor kelas yang dihasilkan tetap berguna.
Varian umum
- Multinomial Naive Bayes memodelkan fitur berbentuk hitungan dan umum dalam klasifikasi dokumen.
- Bernoulli Naive Bayes memodelkan keberadaan fitur biner.
- Gaussian Naive Bayes memodelkan setiap fitur kontinu dengan distribusi Gaussian kondisional pada kelas.
- Categorical Naive Bayes memodelkan kategori diskrit.
Pelunakan dan stabilitas numerik
Jika nilai fitur tidak pernah muncul bersama kelas dalam pelatihan, estimasi probabilitas tanpa pelunakan dapat menjadi nol dan menghilangkan seluruh perkalian. Pelunakan aditif atau gaya Laplace mencegah hal ini. Implementasi menghitung probabilitas log sehingga mengalikan banyak nilai kecil menjadi penjumlahan nilai log yang stabil.
Probabilitas, skor, dan kalibrasi
Output probabilitas Naive Bayes dapat terkalibrasi buruk karena fitur yang berkorelasi secara efektif dihitung lebih dari satu kali. Sebuah classifier mungkin dapat mengurutkan kelas dengan baik namun melebih-lebihkan kepercayaan. Kalibrasi harus dievaluasi pada data yang ditahan ketika probabilitas memengaruhi keputusan.
Bayes di luar Naive Bayes
Inferensi Bayesian mendukung model hierarkis, pengujian A/B, estimasi parameter ilmiah, peramalan, pengambilan keputusan yang menyadari ketidakpastian, dan model grafis probabilistik. Metode perkiraan seperti Markov chain Monte Carlo dan inferensi variasional digunakan ketika posterior tidak dapat dihitung dalam bentuk tertutup.
Kesalahan penalaran umum
- Mengkacaukan
P(A|B)denganP(B|A). - Mengabaikan base rate yang jarang atau umum.
- Menganggap prior sebagai objektif atau tidak mendokumentasikannya.
- Mengasumsikan likelihood tinggi otomatis berarti posterior tinggi.
- Menafsirkan asosiasi prediktif sebagai kausalitas.
Probabilitas kondisional, odds, dan bukti
Teorema Bayes menghubungkan probabilitas suatu hipotesis setelah bukti dengan probabilitas priornya, likelihood mengamati bukti tersebut di bawah hipotesis, dan probabilitas total bukti. Dalam bentuk odds, odds posterior sama dengan odds prior dikalikan dengan rasio likelihood. Ini memisahkan apa yang diyakini sebelum tes dari seberapa kuat tes membedakan hipotesis. Tes yang tampak sangat akurat tetap dapat menghasilkan banyak false positive ketika kondisi tersebut jarang karena base rate masuk ke posterior.
Likelihood adalah fungsi hipotesis untuk data yang diamati tetap dan tidak boleh dikacaukan dengan probabilitas hipotesis. Normalisasi bukti menjumlahkan atau mengintegrasikan di antara hipotesis yang bersaing. Asumsi independensi kondisional dapat menyederhanakan perhitungan, seperti pada naive Bayes, namun harus diperiksa konsekuensinya. Beberapa bukti tidak dapat dikalikan sebagai independen ketika mereka berbagi penyebab atau informasi duplikat. Arah kausal juga penting: P(bukti|hipotesis) tidak secara umum sama dengan P(hipotesis|bukti), kesalahan invers probabilitas klasik.
Pilihan pemodelan, komputasi, dan penggunaan keputusan
Analisis Bayesian menentukan prior, likelihood, dan distribusi prediktif posterior. Prior dapat mengenkode pengetahuan yang sudah ada, meregularisasi sampel kecil, atau bersifat lemah informatif; mereka harus dibenarkan dan diuji melalui analisis sensitivitas. Model konjugat menghasilkan pembaruan analitik, sementara Markov chain Monte Carlo, inferensi variasional, dan metode berurutan memperkirakan posterior yang kompleks. Diagnosa konvergensi, ukuran sampel efektif, kesalahan aproksimasi, dan kelayakan prediktif prior daripada melaporkan angka posterior tanpa pemeriksaan komputasi.
Probabilitas posterior memberi informasi tetapi tidak dengan sendirinya menentukan tindakan. Keputusan memerlukan kerugian, manfaat, kendala, dan alternatif yang tersedia. Evaluasi model probabilistik dengan kalibrasi, aturan skor yang tepat, dan pemeriksaan prediktif posterior pada data baru. Perbarui hanya dengan bukti yang dikumpulkan di bawah proses yang dimodelkan; bias seleksi dan pergeseran dataset dapat membuat likelihood tidak valid. Komunikasikan interval kredibel dan asumsi tanpa memperlakukan mereka sebagai rentang frekuensi yang dijamin. Teorema Bayes adalah aljabar probabilitas yang tepat, sementara kualitas kesimpulan Bayesian bergantung pada model dan bukti yang diberikan.
Contoh terapan: menafsirkan tes diagnostik
Sebuah tes memiliki sensitivitas 95% dan spesifisitas 90%, namun kondisi tersebut hanya memengaruhi 1% populasi yang disaring. Untuk 10.000 orang, diperkirakan sekitar 95 positif sejati dan 990 false positive, menghasilkan nilai prediktif positif di bawah 9%. Teorema Bayes menjelaskan efek base-rate secara eksplisit. Perhitungan menyatakan populasi, ambang tes, dan ketidakpastian alih-alih mengiklankan sensitivitas sebagai peluang hasil positif benar. Perbedaan ini juga menjadi dasar bagi data science yang cermat.
Klinisi memperbarui probabilitas dengan bukti tambahan hanya ketika ketergantungan antar tes dimodelkan. Ambang keputusan menggabungkan bahaya penyakit yang terlewat, risiko tes konfirmasi, biaya, dan preferensi pasien. Kalibrasi diperiksa pada populasi lokal, dan perubahan prevalensi memicu peninjauan. Posterior mendukung diskusi dan langkah selanjutnya; ia tidak menggantikan diagnosis konfirmasi. Pelaporan menggunakan frekuensi alami dan analisis sensitivitas sehingga pasien dan praktisi dapat melihat bagaimana kesimpulan berubah di bawah asumsi yang masuk akal.
Bukti implementasi dan kesiapan operasional
Keputusan produksi memerlukan lebih dari sekadar demonstrasi yang berhasil. Tentukan pengguna yang dituju, lingkungan operasional, masukan, keluaran, ketergantungan, pemilik, dan konsekuensi tiap kegagalan penting. Bangun baseline yang dapat direproduksi dan set evaluasi berversi sebelum penyetelan. Uji kasus biasa, kondisi batas, masukan yang rusak atau hilang, pergeseran distribusi, kegagalan ketergantungan, penyalahgunaan, serta grup atau lingkungan yang paling mungkin kurang terlayani. Ukur kualitas tugas bersama dengan kalibrasi atau ketidakpastian, latensi, throughput, biaya sumber daya, aksesibilitas, privasi, dan keamanan. Catat setiap transformasi dan ambang sehingga peninjau independen dapat mereproduksi hasil dan membedakan bukti dari prototipe yang menarik.
Sebelum peluncuran, tetapkan otoritas untuk rilis, pengecualian, perubahan, rollback, dan pensiun. Gunakan peluncuran bertahap, pertahankan fallback yang aman, dan verifikasi pemantauan dengan kegagalan yang sengaja disuntikkan. Telemetri operasional harus mengungkap kualitas masukan, perilaku keluaran, versi model atau aturan, kesehatan ketergantungan, intervensi manusia, dan hasil yang terkonfirmasi tanpa mengumpulkan data sensitif yang tidak diperlukan. Tentukan ambang peringatan dan pemilik respons, kemudian tinjau bukti dunia nyata setelah penerapan alih-alih mengasumsikan kinerja offline akan bertahan. Evaluasi kembali setiap kali sumber data, pengguna, model, vendor, kebijakan, perangkat keras, atau tujuan berubah. Sistem yang dipelihara juga memerlukan dokumentasi pemulihan, pembelajaran insiden, prosedur penghapusan dan retensi, serta titik yang jelas di mana sistem harus dinonaktifkan atau diganti.
Pertanyaan yang sering diajukan
Apa perbedaan antara likelihood dan probabilitas?
Dengan parameter tetap, sebuah model memberikan probabilitas pada data yang mungkin. Dengan data yang diamati tetap, ekspresi yang sama dapat dilihat sebagai fungsi likelihood atas nilai parameter yang mungkin. Rumus numeriknya dapat sama sementara interpretasinya berbeda.
Apakah Naive Bayes merupakan inferensi Bayesian penuh?
Ia menggunakan teorema Bayes untuk klasifikasi dengan model independensi kondisional yang kuat. Inferensi Bayesian yang lebih luas menempatkan distribusi pada kuantitas yang tidak diketahui dan beralasan dengan distribusi posterior.
Referensi utama