
Dasar-dasar AI
Apa Itu Model Bahasa Besar (LLM)?

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
Model bahasa besar (LLM) adalah jaringan saraf yang dilatih pada kumpulan besar urutan untuk memprediksi token atau tujuan bahasa terkait. Sebagian besar LLM saat ini menggunakan arsitektur transformer dan dapat menghasilkan, mengklasifikasikan, merangkum, menerjemahkan, mengambil, dan mengubah bahasa melalui antarmuka yang sama.
LLM bukanlah basis data atau penalaran yang terjamin. Output‑nya merupakan prediksi bersyarat yang dipengaruhi oleh data pelatihan, pasca‑pelatihan, konteks, alat, dan proses decoding. Kelancaran dapat hadir bersamaan dengan kesalahan faktual, ketidakpastian, bias, atau perilaku yang tidak aman.
Poin-poin utama
- Tokenisasi mengubah teks menjadi unit terpisah; embedding dan attention membangun representasi kontekstual.
- Pra‑pelatihan mempelajari pola luas, sementara fine‑tuning dan metode preferensi membentuk perilaku tugas.
- Pengambilan (retrieval) dan alat dapat menambahkan bukti atau tindakan terkini, namun memerlukan izin dan validasi terpisah.
- Evaluasi sistem yang diterapkan untuk kualitas, keterkaitan fakta, keamanan, latensi, biaya, dan drift.
Token, transformer, dan pra‑pelatihan
Teks dibagi menjadi token. Sebuah transformer memetakan token tersebut menjadi vektor, mencampur informasi melalui lapisan attention dan feed‑forward, serta menghasilkan distribusi probabilitas untuk token berikutnya atau token yang hilang.
Tujuan self‑supervised menciptakan sinyal pelatihan dari urutan mentah. Skala dalam jumlah parameter, data, dan komputasi dapat meningkatkan loss secara dapat diprediksi pada rentang tertentu, namun kualitas dataset, arsitektur, optimisasi, dan evaluasi menentukan kemampuan apa yang muncul dalam praktik.
Pasca‑pelatihan dan inferensi
Penyetelan instruksi menggunakan demonstrasi; optimisasi preferensi dapat membuat output lebih sesuai dengan penilaian manusia atau kebijakan. Pada inferensi, prompt dan riwayat percakapan menentukan konteks, sementara suhu dan pengaturan sampling memengaruhi variasi.
RLHF dan metode serupa membentuk perilaku alih‑alih memasang pemeriksa fakta lengkap. Model masih dapat menghasilkan jawaban yang tampak masuk akal namun tidak didukung.
Pengambilan, alat, dan agen
Generasi yang diperkaya dengan retrieval menyediakan potongan teks yang dipilih dari koleksi eksternal. Pemanggilan alat memungkinkan kode aplikasi menanyakan basis data, menghitung, mencari, atau melakukan aksi. Pola‑pola ini memisahkan sebagian pengetahuan dan eksekusi dari bobot model.
Aplikasi harus memvalidasi argumen alat, menegakkan izin, mempertahankan sitasi, dan memperlakukan konten yang diambil sebagai masukan yang tidak dapat dipercaya. Pencarian kesamaan vektor membantu retrieval tetapi tidak membuktikan bahwa sebuah potongan mendukung jawaban.
Keterbatasan dan evaluasi
LLM dapat berhalusinasi, menampilkan konten yang diingat, mengikuti instruksi berbahaya, mereproduksi bias, dan gagal pada tugas yang tampak mirip dengan contoh pelatihan. Konteks panjang tidak menjamin setiap fakta digunakan atau direkonsiliasi dengan benar.
Evaluasi pada tugas privat yang representatif dengan prompt dan versi yang terdokumentasi. Ukur dukungan oleh sumber, penolakan, kalibrasi, keamanan, hasil subkelompok, beban kerja manusia, latensi, dan biaya. Pantau setelah rilis karena model, data, dan perilaku pengguna berubah.
Data pelatihan dan pengembangan model
Korpus pra‑pelatihan menggabungkan halaman web, buku, kode, materi akademik, percakapan, serta sumber berlisensi atau terkurasi. Pipeline mendeteksi bahasa, menghapus duplikat, menyaring kualitas dan konten tidak aman, menangani data pribadi, dan memilih bobot campuran. Pilihan‑pilihan ini membentuk pengetahuan, cakupan bahasa, gaya, bias, dan memorisasi.
Proses optimisasi memproses batch urutan token dan meminimalkan loss prediksi dengan gradient descent. Pelatihan terdistribusi membagi data, tensor model, tahap pipeline, atau pakar di seluruh akselerator. Checkpointing, stabilitas numerik, komunikasi jaringan, dan pemulihan kegagalan menjadi perhatian teknik utama pada skala besar.
Evaluasi selama pelatihan melacak loss dan rangkaian kemampuan, namun kontaminasi benchmark dapat menggelembungkan hasil. Sisihkan periode waktu dan tugas proprietari, cari tumpang tindih, dan laporkan prompt, decoding, alat, serta skor secara tepat. Sebuah model dapat memperbaiki loss rata‑rata sementara regresi muncul pada keamanan atau bahasa dengan sumber daya rendah.
Jendela konteks, decoding, dan inferensi
Pada inferensi, cache key‑value menyimpan proyeksi attention untuk token sebelumnya sehingga tidak perlu dihitung ulang pada setiap langkah. Memori cache bertambah seiring dengan jumlah lapisan, urutan, batch, dan representasi. Kuantisasi dan paging mengurangi beban namun dapat mengubah kualitas atau latensi.
Decoding greedy memilih token dengan probabilitas tertinggi; suhu (temperature) mengubah skala probabilitas; top‑k dan top‑p membatasi kumpulan kandidat; beam search melacak beberapa urutan. Strategi terbaik tergantung pada apakah tugas mengutamakan determinisme, keragaman, output terstruktur, atau kemungkinan urutan. Selalu validasi skema setelah generasi.
Konteks panjang meningkatkan jumlah informasi yang tersedia, bukan jaminan ingatan atau penalaran. Posisi, gangguan, kontradiksi, dan struktur prompt memengaruhi penggunaan. Retrieval dapat memilih set bukti yang lebih kecil, sementara rangkuman memadatkan riwayat dengan risiko kehilangan detail. Ukur kinerja sepanjang panjang dan lokasi konteks.
Adaptasi, penyebaran, dan ekonomi
Fine‑tuning penuh memperbarui semua parameter; metode efisien‑parameter memperbarui adaptor atau matriks berperingkat rendah; pra‑pelatihan lanjutan menyesuaikan distribusi domain; penyetelan instruksi dan preferensi membentuk respons. Retrieval sering lebih baik untuk fakta yang sering berubah, sementara penyetelan lebih baik untuk perilaku dan format tugas. Metode‑metode tersebut dapat digabungkan.
Pilihan penyebaran meliputi API yang di‑hosting, endpoint terkelola, bobot terbuka yang di‑host sendiri, model pada perangkat, dan hibrida. Bandingkan penanganan data, kontrol versi, latensi, throughput, wilayah, ketersediaan, portabilitas model, dukungan, dan total biaya. Self‑hosting memindahkan tanggung jawab keamanan, skalabilitas, pembaruan, dan pemantauan penyalahgunaan.
Biaya per token tidak lengkap. Model yang lemah mungkin memerlukan percobaan ulang, prompt lebih panjang, lebih banyak tinjauan, atau kesalahan yang mahal. Ukur biaya per tugas yang berhasil diselesaikan dengan kualitas dan tingkat risiko yang diperlukan. Gunakan caching, batching, model yang lebih kecil, dan kode deterministik bila mereka meningkatkan alur kerja secara keseluruhan.
Contoh kerja: menambatkan LLM pada dokumen perusahaan
Asisten dokumen harus dimulai dengan korpus yang menyadari izin, pengidentifikasi dokumen yang stabil, versi dan tanggal efektif, struktur yang dapat diparse, serta set evaluasi berisi pertanyaan yang dapat dijawab, tidak dapat dijawab, ambigu, dan konflik. Index retrieval memecah dokumen menjadi potongan dan metadata, tetapi ukuran potongan serta tumpang tindih harus sesuai dengan struktur dokumen. Kualitas pencarian diukur secara terpisah sebelum generasi sehingga model yang lancar tidak dapat menyembunyikan bukti yang hilang.
Saat runtime, otentikasi pengguna, saring retrieval berdasarkan akses, ambil dan urutkan ulang bukti, susun prompt terbatas, hasilkan jawaban yang disitasi, dan validasi output yang diperlukan. Model harus menyatakan ketika sumber bertentangan atau tidak mendukung jawaban. Penggunaan alat dan aksi eksternal memerlukan otorisasi terpisah. Lindungi dari instruksi yang tertanam dalam dokumen yang di‑retrieval dengan memperlakukan konten sebagai data, bukan kebijakan sistem yang lebih tinggi prioritasnya.
Evaluasi recall retrieval, presisi sitasi, kebenaran jawaban, keterkaitan fakta, penolakan, latensi, dan biaya di seluruh peran serta tipe dokumen. Lacak versi model, prompt, indeks, parser, dan korpus untuk setiap pengujian. Dalam produksi, catat ID bukti dan umpan balik tanpa mengekspos teks pribadi, pantau pertanyaan yang baru tidak dapat dijawab setelah perubahan konten, dan pertahankan fallback yang aman. Antarmuka LLM tidak menggantikan manajemen arsip, kontrol akses, atau tinjauan subjek yang dapat dipertanggungjawabkan.
Perencanaan kapasitas harus memodelkan distribusi panjang prompt dan output, pengguna bersamaan, perilaku cache, latensi alat, dan tingkat percobaan ulang. Streaming meningkatkan persepsi latensi namun mempersulit moderasi dan pembatalan karena konten yang tidak aman atau salah dapat sampai ke pengguna sebelum respons penuh diperiksa. Tetapkan anggaran token dan alat, isolasi penyewa, lindungi kredensial penyedia, dan latih failover antar versi model tanpa mengubah perilaku yang diandalkan pengguna secara diam‑diam.
Daftar periksa implementasi praktis
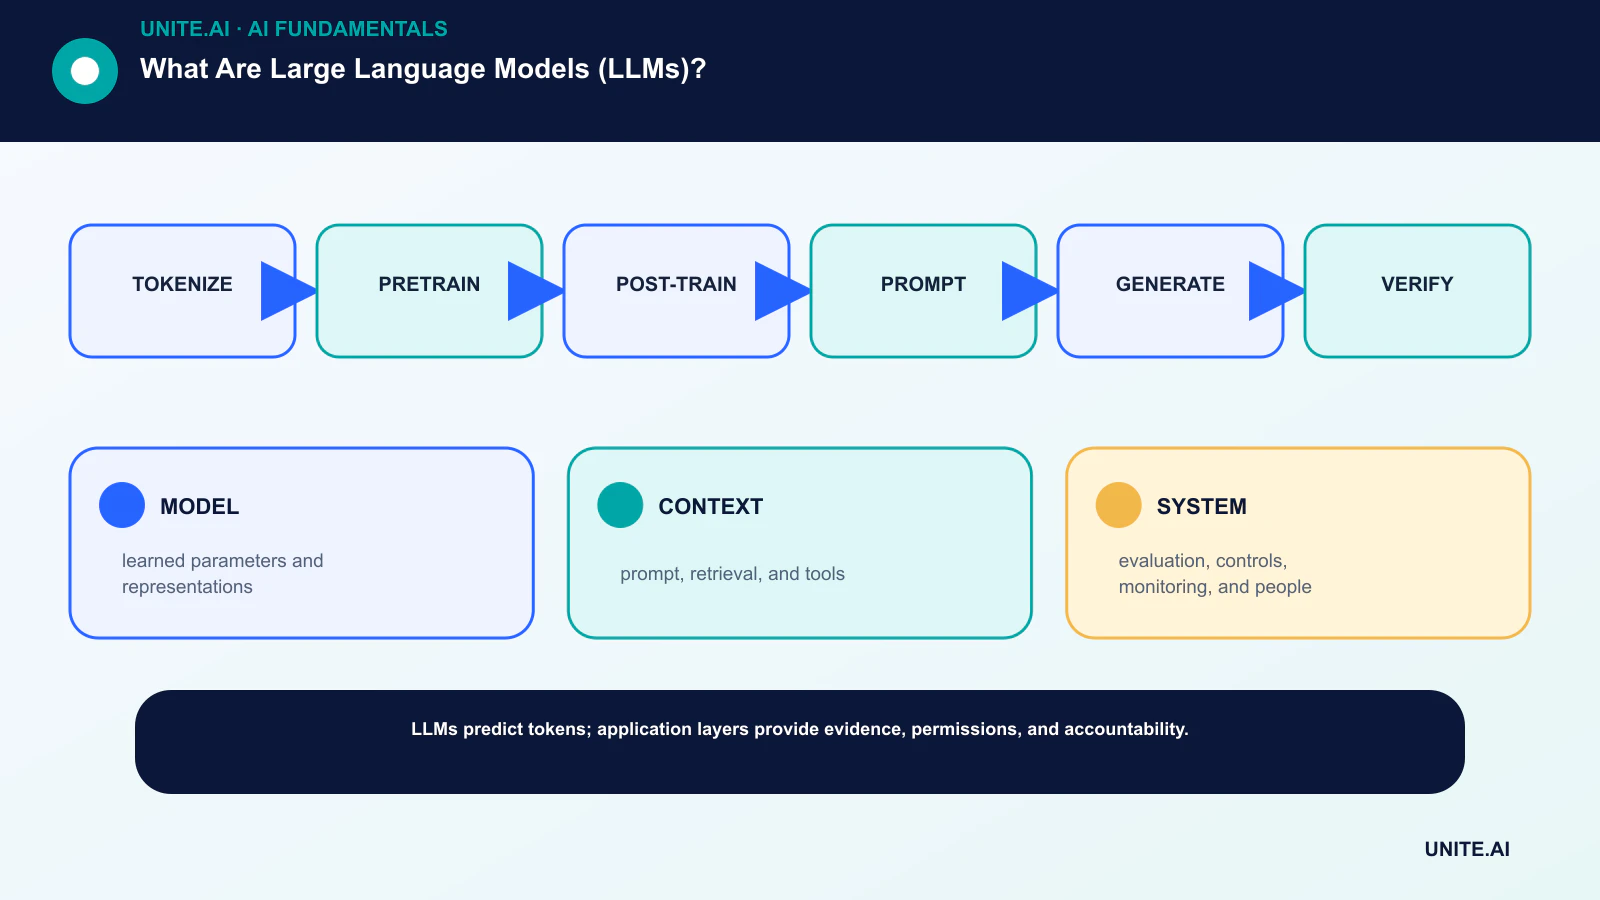
Ubah konsep menjadi alur kerja terbatas dan dapat diuji: tokenisasi → pra‑pelatihan → pasca‑pelatihan → prompt → menghasilkan → verifikasi. Tetapkan pemilik yang dapat dipertanggungjawabkan, dokumentasikan data dan ketergantungan, buat baseline sederhana, tetapkan kriteria penerimaan dan penghentian, uji kegagalan representatif, dan definisikan pemantauan, rollback, serta tinjauan sebelum memperluas ruang lingkup. Catat versi dan asumsi sehingga tim lain dapat mereproduksi hasil dan memahami apa yang berubah.
Sebelum peluncuran, lakukan tinjauan kesiapan yang terdokumentasi bersama orang‑orang yang membangun, mengoperasikan, mengamankan, dan terpengaruh oleh sistem. Uji kasus normal, kondisi batas, kegagalan ketergantungan, dan penyalahgunaan; simpan bukti dan risiko yang belum terselesaikan. Tentukan siapa yang dapat menyetujui rilis, mengubah ambang batas, mengganti output, atau menghentikan operasi. Tinjau kembali keputusan setelah data dunia nyata tersedia, karena pilot yang berhasil secara teknis tidak menjamin kinerja yang dapat diandalkan pada skala yang lebih luas.
- MODEL: parameter dan representasi yang dipelajari.
- KONTEKS: prompt, retrieval, dan alat.
- SISTEM: evaluasi, kontrol, pemantauan, dan orang.
Pertanyaan yang sering diajukan
Mengapa LLM disebut besar?
Tidak ada ambang parameter universal. ‘Besar’ mengacu pada skala relatif terhadap model bahasa sebelumnya, termasuk jumlah parameter, data pelatihan, komputasi, dan ruang lingkup penggunaan.
Apakah LLM memahami bahasa?
Mereka membangun representasi internal yang berguna dan menunjukkan perilaku kompleks, namun kata ‘memahami’ memiliki beberapa makna. Kinerja harus ditunjukkan tugas per tugas, bukan disimpulkan dari kelancaran.
Referensi utama












