
Dasar-dasar AI
Apa Itu Pembelajaran Penguatan dari Umpan Balik Manusia (RLHF)?

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
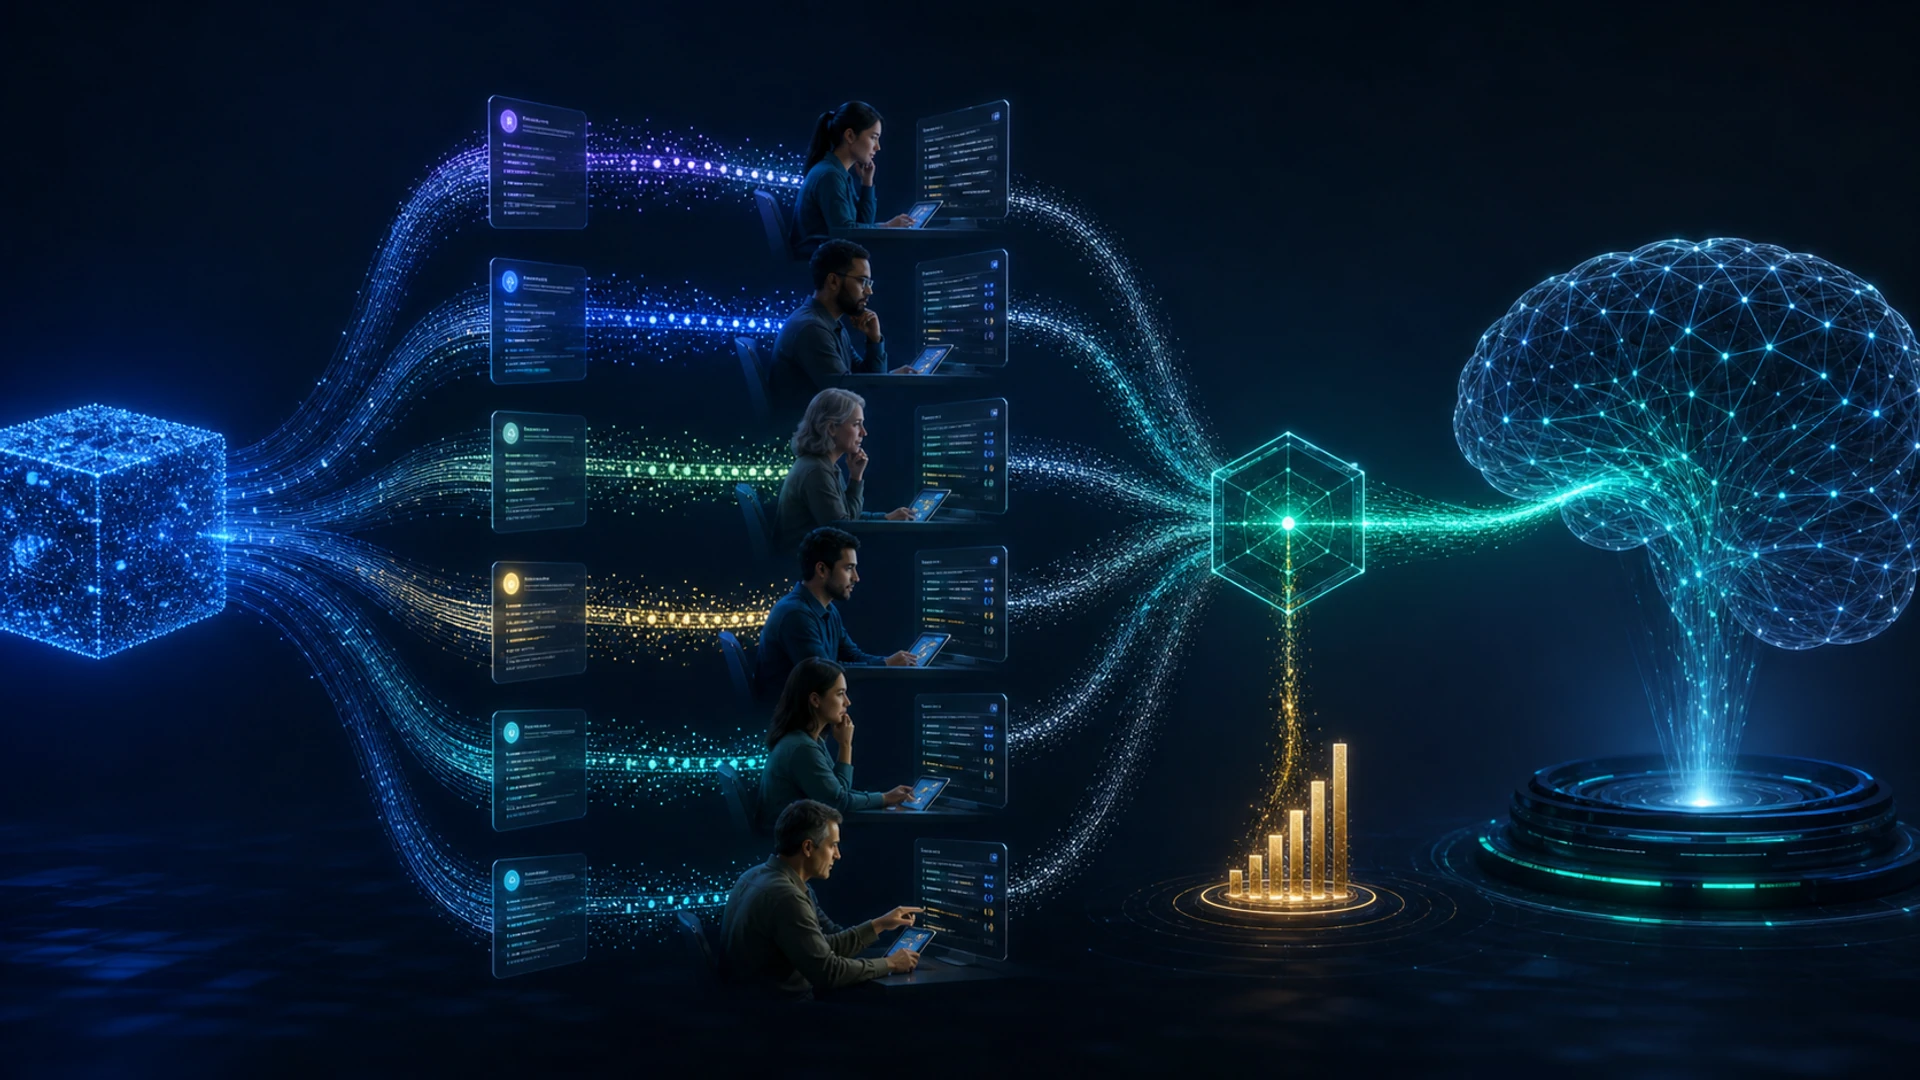
Pembelajaran penguatan dari umpan balik manusia (RLHF) adalah sekumpulan metode yang menggunakan penilaian manusia untuk membantu mengoptimalkan sebuah model ketika perilaku yang diinginkan sulit ditentukan dengan hadiah otomatis yang sederhana. Untuk model bahasa, orang biasanya membandingkan respons kandidat dan model preferensi yang dipelajari mengubah perbandingan tersebut menjadi sinyal pelatihan.
RLHF dapat membuat model yang telah dilatih sebelumnya menjadi lebih membantu atau lebih sesuai dengan kebijakan tertulis, tetapi tidak menjamin kebenaran atau keselarasan dengan setiap pengguna. Hasilnya bergantung pada siapa yang memberikan umpan balik, bagaimana prompt diambil, apa yang dapat direpresentasikan oleh model hadiah, dan bagaimana optimisasi dibatasi.
Poin utama
- RLHF biasanya mengikuti pra‑pelatihan dan penyetelan instruksi yang diawasi.
- Preferensi berpasangan melatih model hadiah atau preferensi; optimisasi kebijakan kemudian memberi keunggulan pada output dengan skor lebih tinggi.
- Manipulasi hadiah, ketidaksepakatan anotator, pergeseran distribusi, dan over‑optimisasi tetap menjadi risiko penting.
- Evaluasi kebijakan akhir secara langsung untuk kualitas tugas, keamanan, kalibrasi, dan efek pada subkelompok.
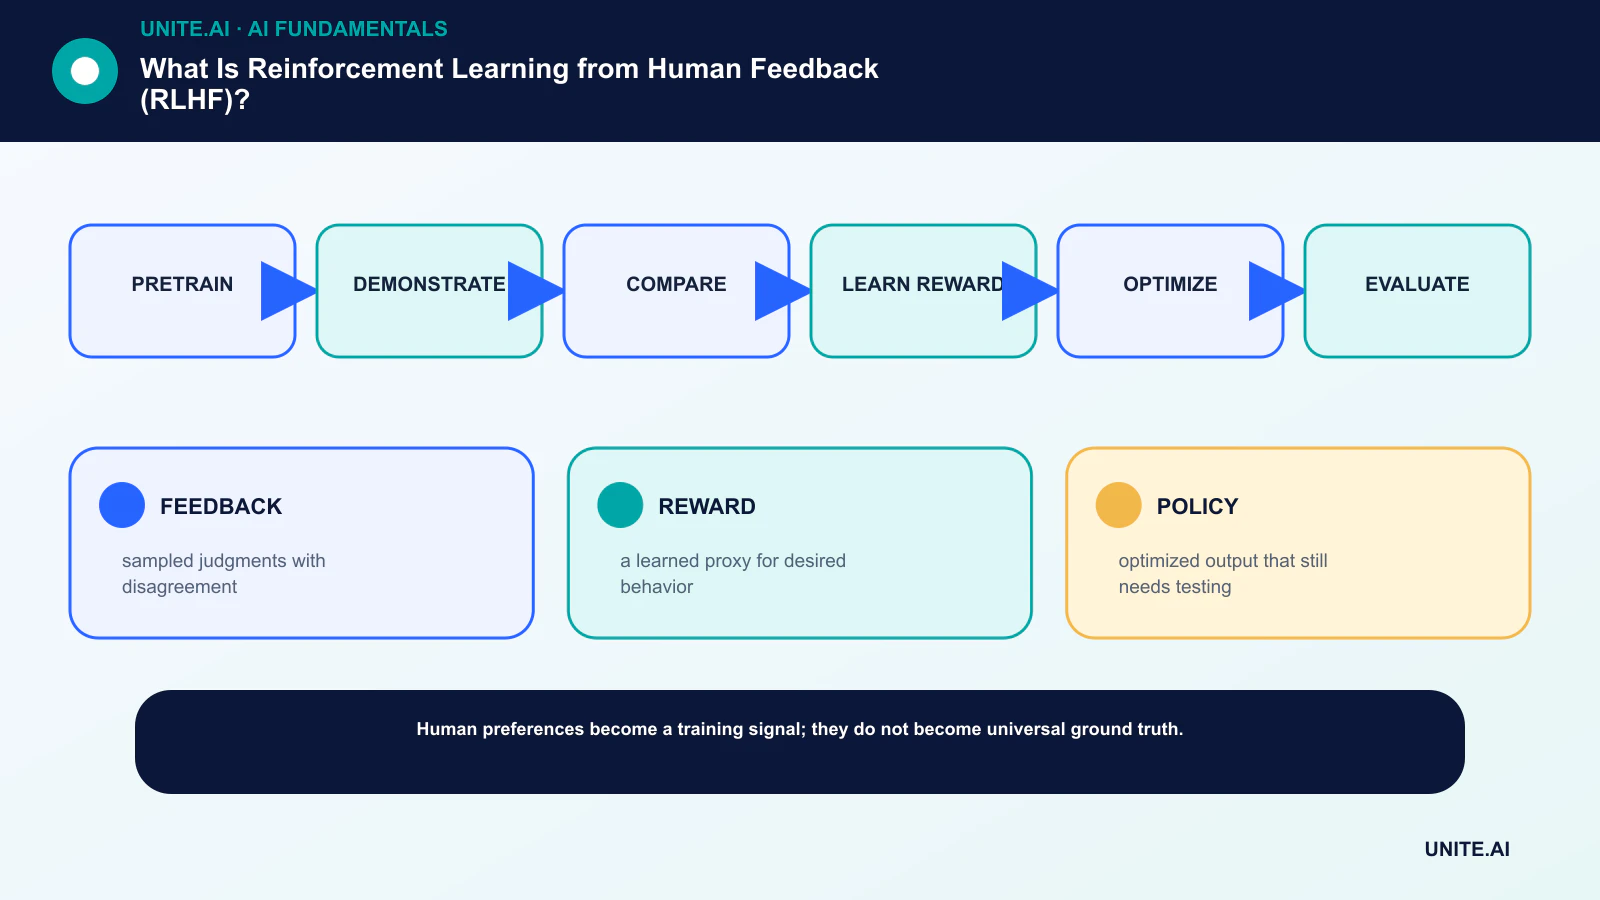
Alur kerja RLHF umum
Model bahasa pertama-tama mempelajari struktur statistik yang luas melalui pra‑pelatihan. Penyempurnaan terawasi kemudian menggunakan demonstrasi respons yang diinginkan. Untuk pengumpulan preferensi, anotator memberi peringkat atau memilih antara output untuk prompt yang sama.
Model hadiah belajar memprediksi perbandingan tersebut. Algoritma pembelajaran penguatan seperti PPO dapat mengoptimalkan model bahasa terhadap hadiah yang dipelajari tersebut, sementara penalti mencegahnya menyimpang terlalu jauh dari kebijakan referensi.
Umpan balik adalah pengukuran, bukan kebenaran mutlak
Anotator mungkin tidak setuju karena instruksi ambigu, keahlian berbeda, atau nilai yang memang bertentangan. Posisi, kelebihan kata, kepercayaan diri, dan gaya dapat memengaruhi preferensi. Program berkualitas tinggi melatih penilai, mengukur kesepakatan, mengaudit contoh, dan mempertahankan ketidakpastian.
Pengambilan sampel juga penting. Jika kumpulan preferensi mengecualikan bahasa yang sulit, domain, atau bahaya, model hadiah tidak dapat mengawasinya secara andal. Disiplin data‑science sama pentingnya dengan optimizer.
Modus kegagalan
Kebijakan dapat memanfaatkan kelemahan dalam hadiah yang dipelajari, menghasilkan output yang memperoleh skor tinggi tanpa memenuhi maksud dasar. Optimisasi berlebihan dapat mengurangi keberagaman, memperkuat gaya yang disukai, atau membuat model terlalu setuju dengan percaya diri.
Model hadiah itu sendiri dapat gagal di luar distribusi pelatihannya. Tim harus menguji prompt adversarial, tugas faktual, batas penolakan, kalibrasi, dan perilaku pada tingkat optimisasi yang berbeda, alih-alih bergantung pada satu tingkat kemenangan preferensi agregat.
Alternatif dan pelengkap
Optimisasi Preferensi Langsung belajar dari pasangan preferensi tanpa menyesuaikan kebijakan terpisah melalui loop pembelajaran penguatan daring. Pengambilan sampel penolakan, penyempurnaan preferensi terawasi, umpan balik berbasis aturan, dan supervisi proses menawarkan pertukaran lainnya.
Tidak ada metode yang menghilangkan kebutuhan akan prompt, pengambilan, alat, dan kontrol tingkat aplikasi. Pelatihan pasca membentuk perilaku; sistem yang diterapkan tetap memerlukan bukti yang berlandaskan, izin, pemantauan, dan eskalasi manusia.
Cara melatih model preferensi
Untuk sebuah prompt x dan dua respons y₁ serta y₂, model preferensi memberikan skor skalar dan dilatih sehingga respons yang dipilih memperoleh skor lebih tinggi. Fungsi kerugian umum didasarkan pada probabilitas bahwa satu skor melebihi yang lain. Ini mengubah banyak penilaian berpasangan menjadi fungsi yang dapat menilai output yang baru dihasilkan.
Model mempelajari sinyal apa pun yang memprediksi pilihan yang terkumpul. Jika penilai lebih menyukai prosa yang percaya diri, jawaban yang lebih panjang, norma budaya tertentu, atau sudut pandang yang familiar, korelasi tersebut dapat menjadi fitur hadiah. Instruksi seimbang, contoh kontra, tinjauan ahli, dan audit terhadap preferensi dangkal mengurangi namun tidak menghilangkan masalah.
Data preferensi dapat mencakup ikatan, peringkat, kritik, label skalar, atau demonstrasi. Pemilihan pasangan penting: perbandingan antara jawaban yang jelas berbeda mengajarkan lebih sedikit tentang batas kualitas halus, sementara hanya pasangan yang sulit dapat membuat pelatihan tidak stabil. Pengambilan sampel aktif dapat menargetkan ketidaksepakatan informatif namun dapat mengubah distribusi data.
Optimisasi kebijakan dan regularisasi
RLHF berbasis PPO mengambil sampel respons dari kebijakan saat ini, menilai mereka dengan model hadiah, dan memperbarui kebijakan untuk meningkatkan hadiah yang diharapkan. Penalti Kullback–Leibler atau batasan terkait menjaga kebijakan tetap dekat dengan referensi yang diawasi, membatasi pergeseran destruktif dan mencegah eksploitasi kelemahan model hadiah yang sempit.
Kekuatan optimisasi adalah pilihan produk. Terlalu sedikit meninggalkan perilaku yang diinginkan tidak berubah; terlalu banyak dapat menghasilkan manipulasi hadiah, frase berulang, sikap menjilat, atau keberagaman yang berkurang. Plot kualitas dan metrik keamanan terhadap hadiah dan divergensi selama pelatihan alih-alih memilih checkpoint hanya berdasarkan hadiah.
Metode preferensi langsung menghasilkan tujuan dari pasangan preferensi dan model referensi tanpa loop RL daring yang eksplisit. Mereka dapat menyederhanakan pelatihan, namun tetap mewarisi kualitas preferensi, cakupan, dan asumsi kebijakan referensi. Umpan balik konstitusional atau yang dihasilkan AI mengubah siapa yang menyediakan label; hal itu tidak menghilangkan kebutuhan untuk memvalidasi nilai dan kegagalan dengan orang.
Evaluasi dan tata kelola data
Gunakan perbandingan buta, tes khusus tugas, prompt adversarial, pemeriksaan faktualitas, presisi dan recall penolakan, serta tinjauan subkelompok. Pisahkan evaluator dari data pelatihan bila memungkinkan. Tingkat kemenangan terhadap model yang lebih lama dapat menyembunyikan kegagalan absolut ketika kedua kandidat buruk.
Catat perekrutan anotator, kompensasi, keahlian, geografi, bahasa, instruksi, paparan terhadap konten berbahaya, ketidaksepakatan, adjudikasi, dan kontrol kualitas. Pekerjaan umpan balik dapat menimbulkan risiko psikologis, dan operasi data yang bertanggung jawab mencakup dukungan pekerja serta hak untuk menolak tugas yang mengganggu.
Setelah penerapan, pantau pergeseran preferensi dan overgeneralisasi. Kebijakan yang disetel untuk bantuan santai dapat berperilaku buruk dalam konteks medis atau hukum. Jaga batas domain, pengambilan, izin, dan eskalasi di luar asumsi RLHF, dan latih ulang hanya ketika bukti baru membenarkan perubahan.
Alur pelatihan dan evaluasi RLHF yang konkret
Proyek tipikal dimulai dengan model bahasa yang telah dilatih sebelumnya dan dataset instruksi yang digunakan untuk penyempurnaan terawasi. Anotator kemudian membandingkan respons kandidat berdasarkan rubrik tertulis yang mencakup kebenaran, relevansi, gaya, keamanan, dan ketidakpastian. Preferensi berpasangan melatih model hadiah atau langsung mengoptimalkan kebijakan. Pengambilan sampel harus mencakup tugas biasa, kasus pinggiran yang sulit, prompt adversarial, banyak bahasa, dan area di mana anotator secara sah tidak setuju.
Akurasi model hadiah pada perbandingan yang ditahan diperlukan namun tidak cukup. Kebijakan yang dioptimalkan dapat mengeksploitasi kesalahan dalam hadiah yang dipelajari, menjadi terlalu bertele-tele, menolak permintaan yang tidak berbahaya, atau kehilangan kemampuan. Lacak benchmark tugas, preferensi manusia, kalibrasi, keamanan, keberagaman, dan divergensi dari model referensi selama pelatihan. Secara periodik kumpulkan perbandingan baru dari kebijakan yang berubah sehingga data preferensi mencakup output yang sebenarnya dihasilkan model.
Catat siapa yang memberikan preferensi, instruksi mereka, kompensasi, ketidaksepakatan, kontrol kualitas, serta batas budaya atau domain. Gunakan peninjau ahli bila kesalahan dapat menimbulkan bahaya khusus. Lakukan red‑team pada model hadiah dan kebijakan akhir, pertahankan tes regresi perilaku, dan tahapkan penerapan. RLHF membentuk perilaku sesuai dengan preferensi yang diukur; ia tidak membuktikan kebenaran, menghilangkan bias, atau menyelesaikan masalah yang lebih luas tentang bagaimana menentukan apa yang harus dilakukan model dalam setiap konteks.
Daftar periksa implementasi praktis
Ubah konsep menjadi alur kerja yang terbatas dan dapat diuji: pra‑pelatihan → demonstrasi → perbandingan → belajar hadiah → optimisasi → evaluasi. Tentukan pemilik yang bertanggung jawab, dokumentasikan data dan ketergantungan, buat baseline sederhana, tetapkan kriteria penerimaan dan penghentian, uji kegagalan representatif, serta definisikan pemantauan, rollback, dan tinjauan sebelum memperluas ruang lingkup. Catat versi dan asumsi sehingga tim lain dapat mereproduksi hasil dan memahami apa yang berubah.
Sebelum peluncuran, lakukan tinjauan kesiapan yang terdokumentasi bersama orang‑orang yang membangun, mengoperasikan, mengamankan, dan terpengaruh oleh sistem. Uji kasus normal, kondisi batas, kegagalan ketergantungan, dan penyalahgunaan; simpan bukti dan risiko yang belum terselesaikan. Tentukan siapa yang dapat menyetujui rilis, mengubah ambang batas, menimpa output, atau menghentikan operasi. Tinjau kembali keputusan setelah data dunia nyata muncul, karena pilot yang berhasil secara teknis tidak menjamin kinerja andal pada skala yang lebih luas.
- UMPAN BALIK: penilaian yang diambil sampelnya dengan ketidaksepakatan.
- HADIAH: proksi yang dipelajari untuk perilaku yang diinginkan.
- KEBIJAKAN: output yang dioptimalkan namun masih perlu diuji.
Pertanyaan yang sering diajukan
Apakah RLHF sama dengan fine-tuning?
RLHF adalah bentuk pasca‑pelatihan yang menggunakan hadiah yang berasal dari preferensi. Penyempurnaan terawasi melatih langsung pada output target; banyak alur kerja menggunakan keduanya.
Apakah RLHF membuat model menjadi jujur?
Ia dapat meningkatkan perilaku yang diukur melalui proses umpan balik, tetapi model masih dapat salah, persuasif, atau secara strategis mengeksploitasi hadiah. Kebenaran memerlukan evaluasi langsung dan dasar yang kuat.
Referensi utama












