Dasar-dasar AI
Apa itu Pembelajaran Penguatan?

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
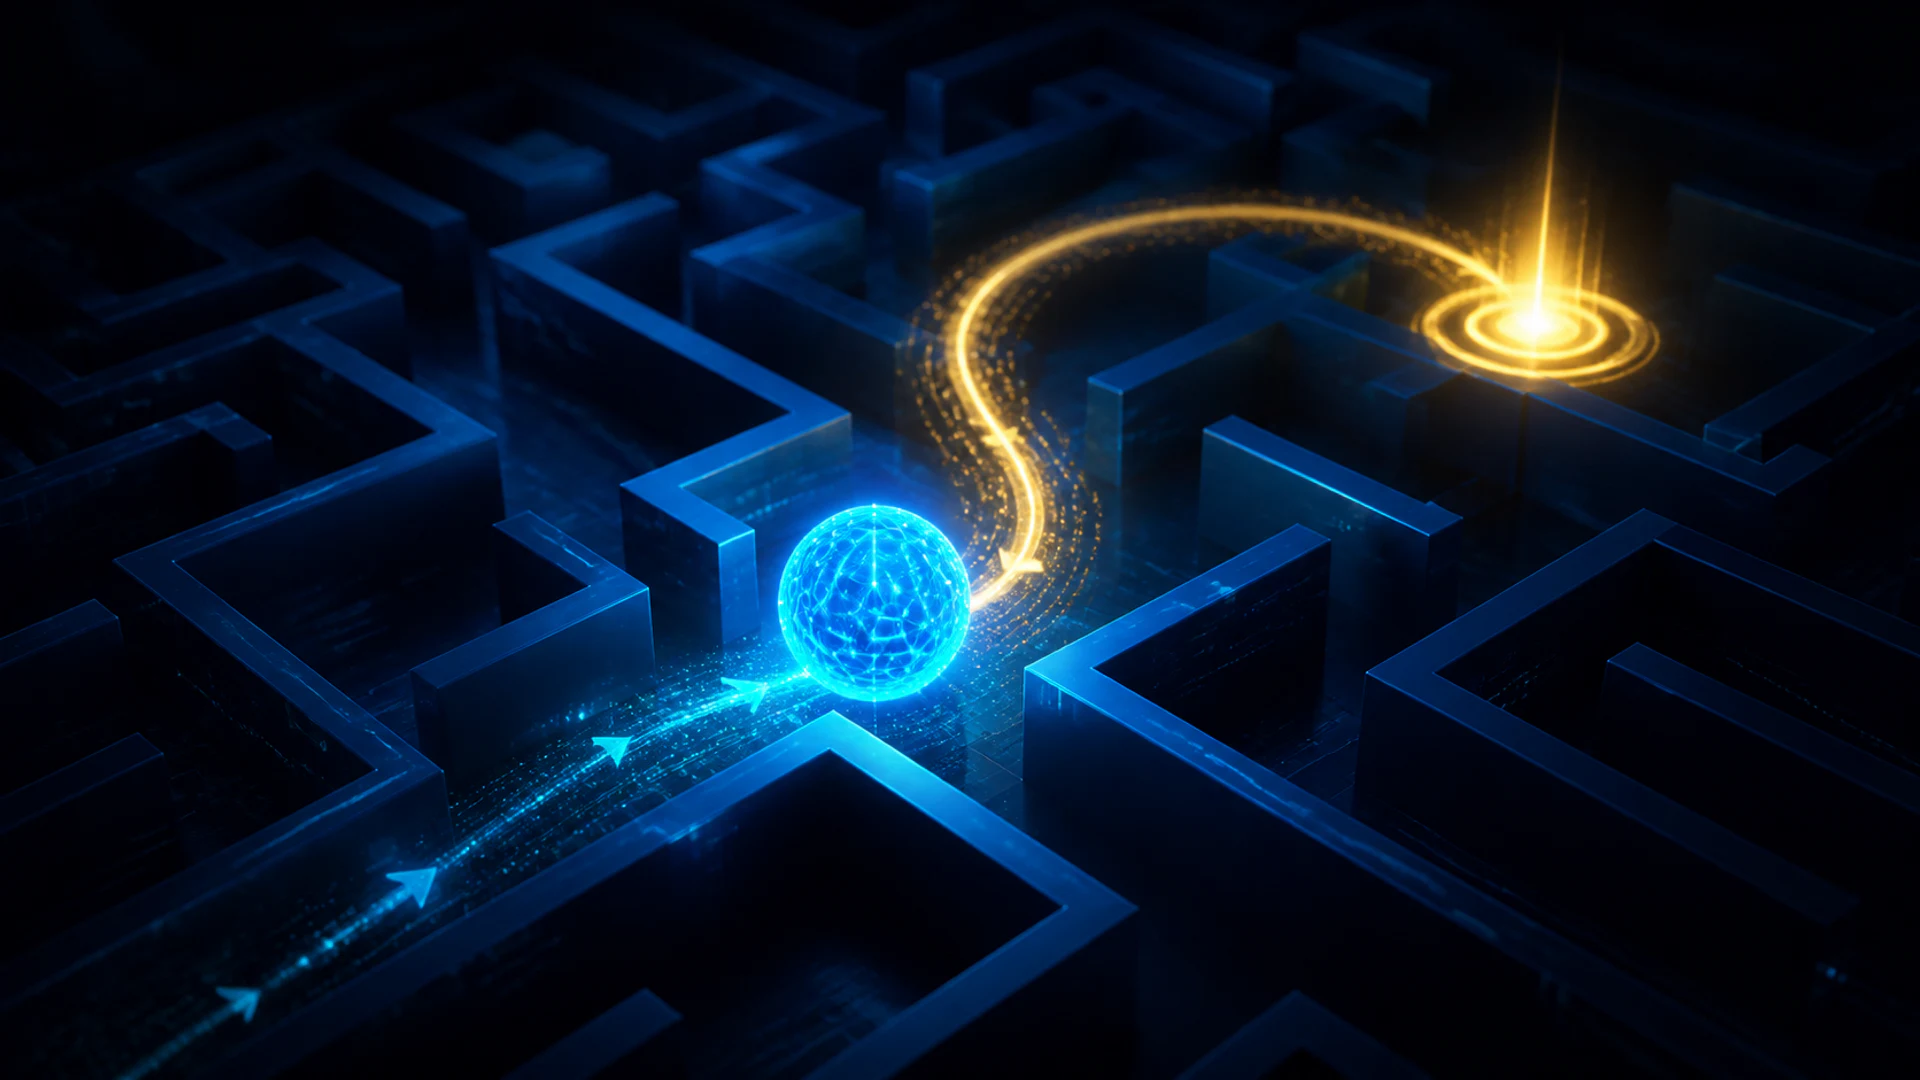
Pembelajaran Penguatan (RL) adalah kerangka kerja pembelajaran mesin di mana agen belajar cara bertindak dengan berinteraksi dengan lingkungan. Setelah setiap aksi, lingkungan berubah dan dapat memberikan hadiah. Tujuan agen adalah mempelajari kebijakan yang memaksimalkan hadiah kumulatif yang diharapkan, bukan sekadar hadiah dari langkah berikutnya.
RL digunakan ketika keputusan berkembang seiring waktu dan satu aksi memengaruhi apa yang terjadi selanjutnya. Secara konseptual berbeda dari pembelajaran terawasi, di mana dataset menyediakan jawaban target untuk setiap contoh pelatihan.
Poin-poin utama
- Sebuah masalah RL mencakup agen, lingkungan, status, aksi, hadiah, dan kebijakan.
- Penguatan positif dan negatif keduanya meningkatkan perilaku; hukuman mengurangi perilaku.
- Agen harus menyeimbangkan antara menjelajahi aksi yang tidak dikenal dengan memanfaatkan aksi yang sudah terbukti berhasil.
- Metode berbasis nilai, berbasis kebijakan, aktor‑kritik, berbasis model, dan offline menyelesaikan pengaturan RL yang berbeda.
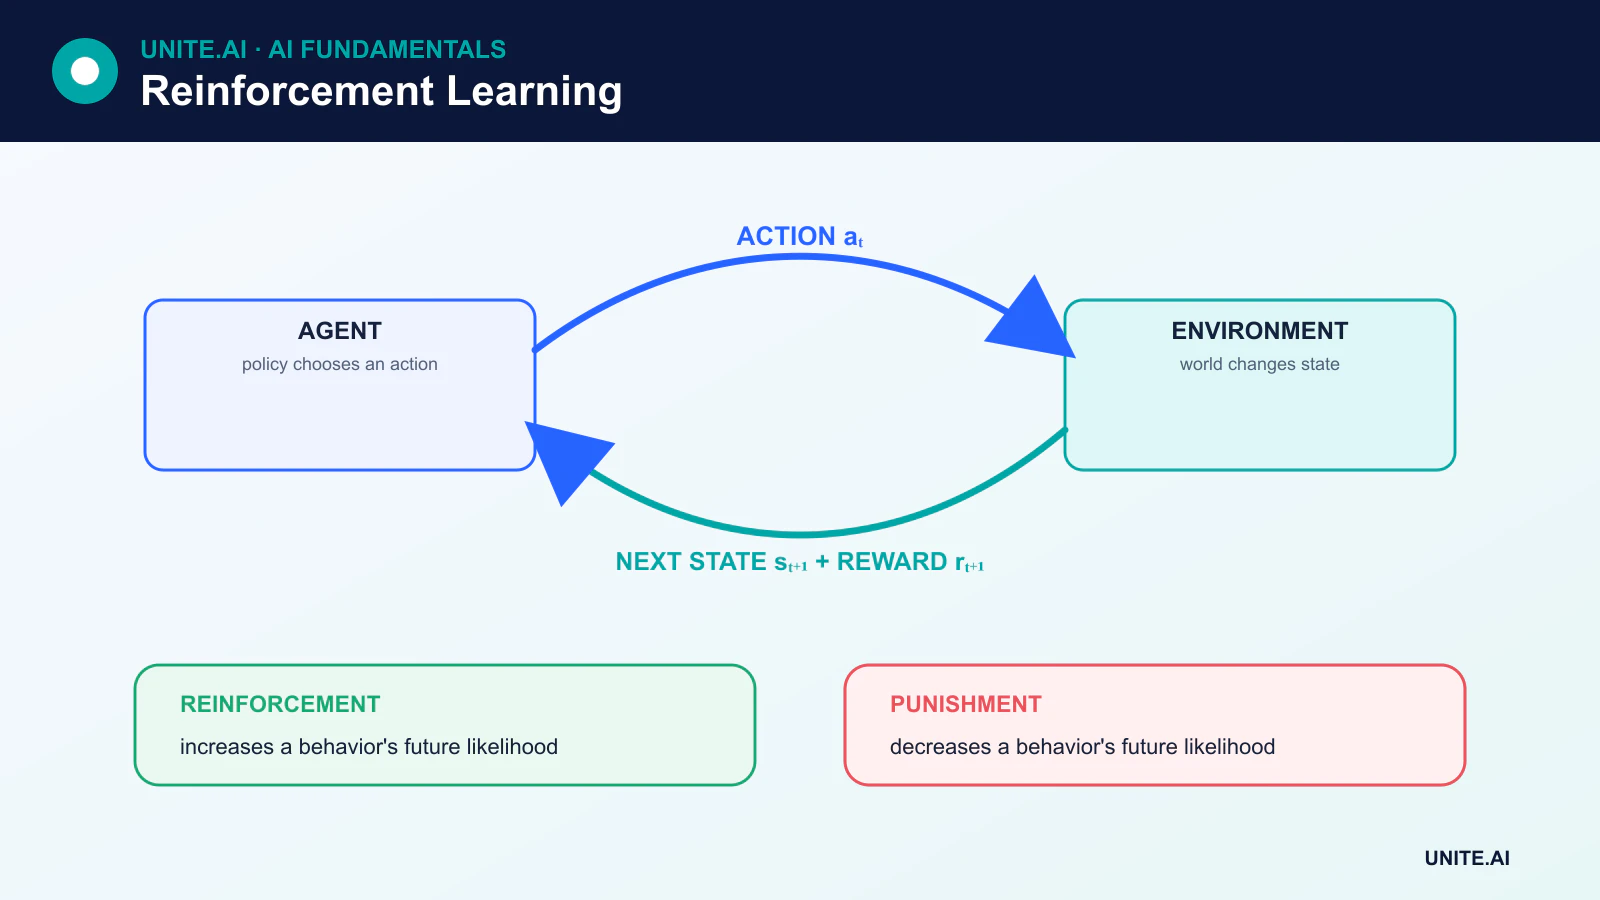
Komponen pembelajaran penguatan
Banyak masalah RL dimodelkan sebagai Proses Keputusan Markov (MDP). Sebuah MDP mencakup:
- Status: informasi yang menggambarkan situasi saat ini.
- Aksi: pilihan yang tersedia bagi agen.
- Transisi: bagaimana status berubah setelah sebuah aksi.
- Hadiah: umpan balik langsung yang dihasilkan oleh sebuah transisi.
- Kebijakan: strategi agen dalam memilih aksi.
- Faktor diskonto: seberapa kuat hadiah masa depan dihitung relatif terhadap hadiah langsung.
Sebuah status tidak harus mengungkapkan semua hal tentang dunia. Ketika informasi penting disembunyikan, masalah dapat menjadi sebagian dapat diamati dan agen mungkin memerlukan memori atau status kepercayaan.
Penguatan tidak sama dengan hukuman
Istilah ini berasal dari psikologi perilaku. Penguatan positif menambahkan konsekuensi yang membuat perilaku lebih mungkin terjadi. Penguatan negatif menghilangkan kondisi tidak menyenangkan dan juga membuat perilaku lebih mungkin terjadi. Sebuah hukuman yang dimaksudkan untuk membuat sebuah aksi kurang mungkin terjadi adalah hukuman, bukan penguatan negatif.
Dalam pembelajaran mesin, praktisi lebih sering berbicara secara langsung tentang hadiah positif, hadiah negatif, biaya, dan hukuman. Masalah utama adalah bagaimana sinyal-sinyal tersebut membentuk pengembalian yang coba dimaksimalkan agen.
Pengembalian, nilai, dan penetapan kredit
Sebuah hadiah menggambarkan satu transisi. Pengembalian menggabungkan hadiah sepanjang waktu, biasanya mendiskontokan hadiah yang tiba jauh di masa depan. Fungsi nilai status memperkirakan pengembalian yang diharapkan dari sebuah status, sementara fungsi nilai aksi memperkirakan pengembalian yang diharapkan setelah mengambil aksi tertentu pada status tersebut.
Ini menimbulkan masalah penetapan kredit: jika hasil yang berguna muncul jauh kemudian, aksi-aksi sebelumnya mana yang layak mendapat kredit? Algoritma RL berbeda dalam cara mereka memperkirakan hubungan ini.
Pembelajaran Monte Carlo dan perbedaan temporal
Metode Monte Carlo belajar dari pengembalian sampel lengkap, biasanya setelah sebuah episode berakhir. Metode perbedaan temporal (TD) memperbarui perkiraan sebelum hasil akhir dengan menggabungkan hadiah yang diamati dengan perkiraan tentang apa yang akan datang selanjutnya. Pembelajaran TD oleh karena itu memanfaatkan (bootstraps) perkiraan nilainya saat ini.
Tidak ada satu keluarga yang secara universal lebih baik. Target Monte Carlo tidak bias di bawah kebijakan yang disampel tetapi dapat memiliki varians tinggi dan memerlukan penyelesaian episode. Metode TD dapat belajar secara daring dan dari tugas yang berkelanjutan, namun target yang di‑bootstrapped memperkenalkan bias.
Eksplorasi versus eksploitasi
Eksplorasi mengumpulkan informasi dengan mencoba aksi-aksi yang nilainya tidak pasti. Eksploitasi memilih aksi yang saat ini diyakini memberikan pengembalian terbaik. Agen yang tidak pernah mengeksplorasi dapat berakhir dengan strategi yang buruk; agen yang tidak pernah mengeksploitasi gagal memanfaatkan apa yang telah dipelajarinya.
Strategi sederhana meliputi pemilihan aksi epsilon‑greedy, eksplorasi berbasis kepercayaan, bonus entropi, dan metode hadiah intrinsik. Pada pengaturan yang kritis terhadap keselamatan, eksplorasi tanpa batas mungkin tidak dapat diterima, sehingga simulasi, batasan, data offline, atau pengawasan manusia menjadi penting.
Pendekatan utama pembelajaran penguatan
Metode berbasis nilai
Q‑learning dan algoritma terkait mempelajari nilai aksi dan menghasilkan kebijakan dengan memilih aksi bernilai tinggi. Pembelajaran penguatan mendalam menggunakan jaringan saraf untuk memperkirakan fungsi nilai atau kebijakan ketika ruang status terlalu besar untuk tabel.
Metode gradien kebijakan
Metode gradien kebijakan secara langsung menyesuaikan kebijakan yang diparameterisasi untuk meningkatkan pengembalian yang diharapkan. Metode ini berguna untuk aksi kontinu dan kebijakan stokastik tetapi dapat memiliki estimasi gradien dengan varians tinggi.
Metode aktor‑kritik
Seorang aktor memilih aksi sementara seorang kritik memperkirakan nilai dan menyediakan sinyal pembelajaran. Ini menggabungkan optimasi kebijakan langsung dengan estimasi nilai.
RL berbasis model dan bebas model
Sistem berbasis model mempelajari atau menggunakan model transisi dan hadiah sehingga dapat merencanakan. Sistem bebas model mempelajari nilai atau kebijakan tanpa secara eksplisit memodelkan lingkungan. Metode berbasis model dapat menggunakan pengalaman secara efisien, namun kesalahan dalam model yang dipelajari dapat menyesatkan perencanaan.
Pembelajaran penguatan offline
RL offline belajar dari dataset tetap alih‑alih mengumpulkan interaksi baru selama pelatihan. Ini dapat mengurangi biaya atau risiko eksplorasi, namun agen harus menghindari perkiraan berlebih pada aksi yang kurang terwakili dalam data.
RLHF dan preferensi manusia
Pembelajaran penguatan dari umpan balik manusia (RLHF) menggunakan data preferensi untuk melatih sinyal hadiah atau secara langsung mengoptimalkan kebijakan. Metode ini telah digunakan untuk menyelaraskan perilaku model bahasa dengan penilaian manusia. Optimasi preferensi bukan jaminan kebenaran atau keamanan: hasil bergantung pada siapa yang memberikan umpan balik, apa yang diminta mereka nilai, dan bagaimana tujuan dirancang.
Keterbatasan
RL dapat memerlukan jumlah interaksi yang sangat besar, berperilaku tidak stabil selama pelatihan, dan memanfaatkan jalan pintas yang tidak diinginkan dalam fungsi hadiah. Evaluasi sulit karena hasil dapat bervariasi dengan seed acak dan detail lingkungan. Praktik yang baik mencakup banyak percobaan, baseline yang transparan, tujuan yang dibatasi, pengujian di luar distribusi, dan pemantauan terhadap peretasan hadiah.
Merancang masalah RL: status, aksi, hadiah, dan horizon
Pembelajaran penguatan memodelkan keputusan berurutan. Lingkungan menghasilkan sebuah observasi, agen memilih aksi berdasarkan kebijakan, dan sebuah transisi menghasilkan hadiah serta observasi berikutnya. Proses Keputusan Markov mengasumsikan status mengandung informasi yang diperlukan untuk memprediksi transisi dan hadiah di masa depan; observabilitas parsial memerlukan memori, status kepercayaan, atau representasi berulang. Diskonto mengendalikan bobot hasil yang tertunda, sementara tugas episodik dan berkelanjutan memerlukan definisi pengembalian yang berbeda. Desain status atau aksi yang buruk dapat membuat tujuan yang dapat diselesaikan menjadi tidak dapat dipelajari.
Desain hadiah menentukan perilaku secara tidak langsung dan merupakan sumber kegagalan utama. Sebuah proksi dapat dieksploitasi: agen yang diberi hadiah untuk kecepatan mungkin mengabaikan keselamatan, sementara agen yang hanya diberi hadiah pada penyelesaian tugas dapat menerima sinyal pembelajaran yang terlalu sedikit. Tambahkan batasan dan aturan terminasi berdasarkan kebutuhan nyata, uji sensitivitas hadiah, dan periksa lintasan untuk strategi yang tidak diinginkan. Metode eksplorasi menyeimbangkan pengumpulan informasi dengan memanfaatkan pengetahuan saat ini. Data off‑policy dapat meningkatkan efisiensi sampel, namun ketidaksesuaian antara kebijakan perilaku dan kebijakan target memerlukan algoritma yang dirancang untuk itu.
Evaluasi, simulasi, dan penerapan aman
Metode berbasis nilai memperkirakan pengembalian yang diharapkan untuk status atau aksi; metode gradien kebijakan mengoptimalkan kebijakan yang diparameterisasi; metode aktor‑kritik mempelajari keduanya. RL berbasis model mempelajari atau menggunakan dinamika transisi untuk merencanakan. Keluarga yang tepat tergantung pada tipe aksi, data, kesetiaan simulator, horizon, dan kebutuhan stabilitas. Bandingkan dengan baseline heuristik, terawasi, dan teori kontrol. Evaluasi pengembalian rata‑rata dan kasus terburuk, pelanggaran batasan, efisiensi sampel, ketahanan terhadap perubahan lingkungan, dan varians antar seed daripada memilih percobaan dengan kurva pembelajaran terbaik.
Eksplorasi daring dapat tidak dapat diterima dalam perawatan kesehatan, keuangan, robotika, dan infrastruktur. Latih dalam simulasi atau data tercatat bila memungkinkan, kuantifikasi kesenjangan simulator‑ke‑realitas, dan gunakan evaluasi off‑policy dengan hati‑hati karena aksi yang belum terlihat tidak memiliki dukungan. Penerapan harus membatasi aksi, laju, sumber daya, dan wilayah operasi; menyertakan persetujuan manusia untuk pilihan yang konsekuensial; serta menyediakan pengendali atau pemadaman yang aman. Pantau hadiah bersamaan dengan hasil aktual karena agen dapat meningkatkan skornya sambil merugikan tujuan yang dimaksud. Validasi kembali setelah perubahan lingkungan, kebijakan, atau hadiah.
Contoh kerja: kontrol energi dengan pembelajaran penguatan
Seorang operator gedung memodelkan suhu, okupansi, cuaca, status peralatan, dan harga listrik, dengan aksi terbatas pada penyesuaian setpoint yang aman. Hadiah menggabungkan kenyamanan, energi, biaya permintaan, dan batasan peralatan, namun pelanggaran kenyamanan yang sebenarnya dievaluasi secara terpisah sehingga optimasi hadiah tidak dapat menyembunyikan kerugian. Kontrol historis dan kontrol prediktif model menyediakan baseline. Pelatihan menggunakan simulator yang dikalibrasi dengan cuaca acak, kebisingan sensor, dan efisiensi peralatan.
Sebelum memengaruhi gedung, kebijakan dijalankan terhadap observasi langsung tanpa melakukan aksi. Insinyur memeriksa lintasan, margin batasan, dan perilaku selama liburan, gelombang panas, pemadaman, serta sensor yang hilang. Penerapan membatasi laju dan jangkauan aksi serta mempertahankan pengendali keselamatan yang ada. Manusia dapat mengintervensi kapan saja. Pemantauan membandingkan energi dan kenyamanan dengan periode yang cocok, mencatat intervensi, dan mengembalikan jika pelanggaran, siklus tak terduga, atau ketidaksesuaian model melebihi ambang yang ditetapkan.
Bukti implementasi dan kesiapan operasional
Keputusan produksi memerlukan lebih dari demonstrasi yang berhasil. Tentukan pengguna yang dimaksud, lingkungan operasi, masukan, keluaran, ketergantungan, pemilik, dan konsekuensi setiap kegagalan penting. Bangun baseline yang dapat direproduksi dan set evaluasi berversi sebelum penyetelan. Uji kasus biasa, kondisi batas, masukan yang rusak atau hilang, pergeseran distribusi, kegagalan ketergantungan, penyalahgunaan, serta kelompok atau lingkungan yang paling mungkin kurang terlayani. Ukur kualitas tugas bersama dengan kalibrasi atau ketidakpastian, latensi, throughput, biaya sumber daya, aksesibilitas, privasi, dan keamanan. Catat setiap transformasi dan ambang sehingga peninjau independen dapat mereproduksi hasil dan membedakan bukti dari prototipe yang menarik.
Sebelum peluncuran, tetapkan wewenang untuk rilis, pengecualian, perubahan, rollback, dan pensiun. Gunakan peluncuran bertahap, pertahankan fallback yang aman, dan verifikasi pemantauan dengan kegagalan yang sengaja disuntikkan. Telemetri operasional harus mengungkap kualitas masukan, perilaku keluaran, versi model atau aturan, kesehatan ketergantungan, intervensi manusia, dan hasil yang dikonfirmasi tanpa mengumpulkan data sensitif yang tidak diperlukan. Tentukan ambang peringatan dan pemilik respons, kemudian tinjau bukti dunia nyata setelah penerapan alih‑alih mengasumsikan kinerja offline akan bertahan. Evaluasi kembali setiap kali sumber data, pengguna, model, vendor, kebijakan, perangkat keras, atau tujuan berubah. Sistem yang dipelihara juga memerlukan dokumentasi pemulihan, pembelajaran insiden, prosedur penghapusan dan retensi, serta titik yang jelas di mana sistem harus dinonaktifkan atau diganti.
Referensi utama