Dasar-dasar AI
Apa Itu Pembelajaran Ensemble?

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
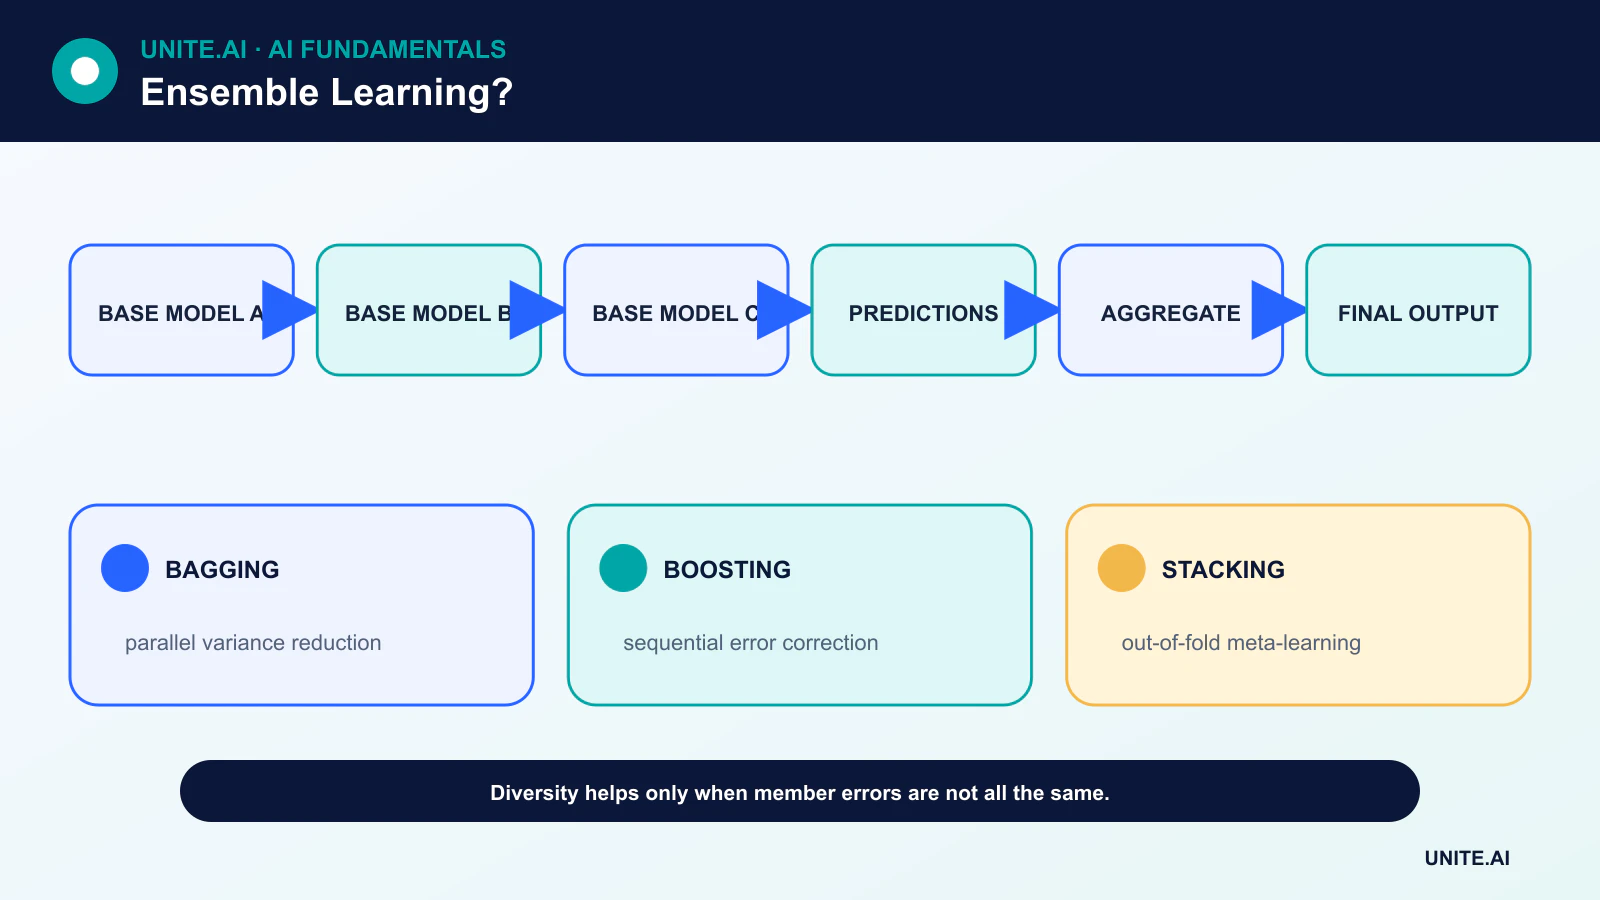
Pembelajaran ensemble menggabungkan prediksi dari beberapa model. Ide utama adalah bahwa model dengan kesalahan yang berbeda dapat menghasilkan hasil yang lebih akurat atau stabil ketika outputnya dirata‑rata, dipilih melalui voting, atau diteruskan ke meta‑learner.
Menambah model saja tidak cukup. Jika setiap anggota belajar cara yang sama, kesalahan mereka akan berkorelasi dan ensemble hanya akan menjadi lebih yakin pada kesalahan yang sama.
Poin penting
- Ensemble bekerja paling baik ketika model anggota masing‑masing berguna dan menghasilkan kesalahan yang secara signifikan berbeda.
- Bagging melatih anggota secara paralel pada data yang di‑resample; boosting melatih pembelajar secara berurutan untuk memperbaiki kesalahan.
- Stacking melatih meta‑model pada prediksi out‑of‑fold, bukan pada prediksi dalam sampel.
- Peningkatan akurasi harus dipertimbangkan terhadap latensi, kalibrasi, interpretabilitas, dan biaya pemeliharaan.
Voting dan rata‑rata
Voting keras memilih kelas dengan jumlah suara terbanyak. Voting lunak merata‑rata probabilitas kelas, biasanya setelah kalibrasi. Ensemble regresi sering merata‑rata prediksi numerik. Versi berbobot memberikan pengaruh lebih besar kepada anggota yang lebih kuat.
Rata‑rata dapat mengurangi varians ketika kesalahan tidak sepenuhnya berkorelasi. Namun tidak dapat memperbaiki cacat data bersama, kesalahan label, atau subkelompok yang hilang. Keberagaman harus diukur melalui ketidaksepakatan dan tumpang tindih kesalahan, bukan diasumsikan hanya dari nama model yang berbeda.
Bagging dan random forest
Bootstrap aggregating (bagging) melatih model pada dataset yang di‑resample dan merata‑rata hasilnya. pohon keputusan memiliki varians tinggi, sehingga menjadi kandidat alami untuk bagging.
Random forest menambahkan pemilihan fitur secara acak pada setiap split, mengurangi korelasi antar pohon. Contoh out‑of‑bag dapat memperkirakan kinerja, namun set tes akhir yang belum tersentuh tetap berharga untuk pemilihan model dan klaim penyebaran.
Boosting
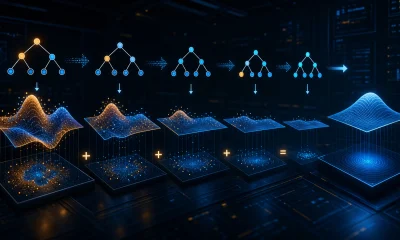
Boosting membangun model aditif secara bertahap. Pembelajar selanjutnya fokus pada contoh atau pola residual yang ditangani buruk oleh ensemble saat ini. AdaBoost mengubah bobot contoh; gradient boosting menyesuaikan pembelajar pada gradien negatif dari loss yang dipilih.
Pohon yang di‑boost dapat memodelkan hubungan tabel yang kompleks, tetapi pohon yang terlalu dalam, terlalu banyak iterasi, dan kebocoran masih dapat menyebabkan overfit. Laju pembelajaran, kedalaman pohon, subsampling, dan early stopping merupakan kontrol utama.
Stacking dan blending
Stacking membuat model tingkat kedua yang belajar cara menggabungkan prediksi dasar. Untuk menghindari kebocoran, setiap baris pelatihan untuk meta‑model harus berasal dari model dasar yang tidak dilatih pada baris tersebut. Cross‑validation menghasilkan prediksi out‑of‑fold ini.
Blending menggunakan set holdout terpisah untuk meta‑model, yang lebih sederhana namun mengurangi data yang tersedia untuk pelatihan. Kedua pendekatan memerlukan preprocessing dan kontrol versi yang sama pada inferensi.
Pertimbangan operasional
Ensemble dapat meningkatkan penggunaan memori, komputasi, dan mode kegagalan. Hal ini dapat membuatnya lebih sulit dijelaskan, dikalibrasi, dan diperbarui secara konsisten. Distilasi dapat mengompresi ensemble menjadi model yang lebih kecil, namun model siswa harus dievaluasi secara independen.
Pemilihan praktis membandingkan kinerja, latensi ekor, kalibrasi, penggunaan sumber daya, dan biaya kesalahan. Terkadang satu model yang teratur dengan baik lebih disukai daripada peningkatan akurasi kecil dari stack yang rapuh.
Mengapa ensemble bekerja
Pembelajaran ensemble menggabungkan beberapa model sehingga kesalahan mereka sebagian saling meniadakan atau kekuatan mereka mencakup wilayah yang berbeda. Bagging melatih model pada data yang di‑resample dan merata‑rata prediksi, mengurangi varians; random forest menambahkan pemilihan fitur acak untuk mendekorrelasi pohon. Boosting melatih pembelajar secara berurutan untuk fokus pada kesalahan residual, sering mengurangi bias namun meningkatkan sensitivitas terhadap noise dan penyetelan. Stacking melatih meta‑model pada prediksi model dasar. Keberagaman harus berguna: merata‑rata model yang identik menambah biaya tanpa banyak mengurangi kesalahan.
Korelasi antar kesalahan menentukan manfaatnya. Keberagaman dapat berasal dari sampel data, fitur, algoritma, hiperparameter, inisialisasi acak, atau jendela waktu. Voting keras mengabaikan kepercayaan; voting lunak merata‑rata probabilitas namun memerlukan kalibrasi yang kompatibel. Regresi dapat merata‑rata atau menggunakan agregasi yang kuat. Pada stacking, prediksi out‑of‑fold sangat penting—melatih meta‑model pada prediksi dasar dari data yang sama menyebabkan kebocoran. Pertahankan baseline rata‑rata sederhana sebelum mengadopsi penggabung yang kompleks.
Evaluasi, kalibrasi, dan ketidakpastian
Bandingkan setiap anggota dan ensemble pada set yang ditahan dengan preprocessing yang identik. Laporkan metrik tugas, kalibrasi, kesalahan subkelompok, varians antar lipatan atau seed, dan biaya sumber daya. Ensemble dapat meningkatkan kualitas rata‑rata sekaligus menyembunyikan titik buta bersama yang disebabkan oleh data atau label yang umum. Periksa ketidaksepakatan: hal ini dapat mengidentifikasi ketidakpastian, namun model yang secara percaya diri salah namun berkorelasi dapat setuju. Kalibrasi ensemble akhir, bukan hanya anggota, dan validasi ambang batas abstensi terhadap kapasitas tinjauan serta konsekuensinya.
Estimasi out‑of‑bag berguna untuk model yang di‑bag, namun tidak menggantikan tes akhir yang representatif untuk penyebaran. Untuk data temporal, hindari resampling yang memutus urutan. Untuk penggunaan terkait keamanan, uji kegagalan anggota, model usang, dan input adversarial. Ensemble berbobot dapat overfit pada data validasi ketika banyak kandidat dicoba. Catat pemilihan kandidat dan gunakan validasi bersarang bila penyetelan luas.
Penyajian dan pemeliharaan
Ensemble meningkatkan penggunaan memori, latensi, energi, dan ketergantungan operasional. Distilasi dapat mengompresi perilaku gabungan menjadi satu model, dengan persyaratan validasi baru. Versikan anggota, preprocessing, bobot, dan routing sebagai satu artefak; definisikan perilaku ketika anggota timeout atau menghasilkan hasil yang tidak valid. Pantau prediksi anggota dan ketidaksepakatan agar kegagalan diam dapat terlihat. Hapus anggota yang redundan dan latih kembali secara sengaja. Ensemble meningkatkan prediksi ketika keberagaman kesalahan memang ada, namun tidak mengubah data pelatihan yang bias atau target yang tidak valid menjadi bukti yang dapat diandalkan.
Contoh kerja: ensemble untuk peringatan cuaca ekstrem
Tim peramalan menggabungkan set fitur model fisik, gradient‑boosted tree, model urutan neural, dan baseline statistik yang terkalibrasi. Prediksi out‑of‑fold melatih meta‑model sederhana, dan evaluasi menggunakan badai masa depan yang sepenuhnya dikecualikan dari pelatihan anggota. Metrik meliputi recall peristiwa, alarm palsu, waktu tenggang, kalibrasi, kinerja geografis, dan keandalan selama kondisi ekstrem yang jarang. Korelasi kesalahan anggota diperiksa karena data input bersama dapat menciptakan titik buta bersama.
Penyajian menyimpan setiap prediksi dan hasil gabungan. Jika seorang anggota tidak tersedia, sistem menggunakan konfigurasi terdegradasi yang telah dipra‑validasi alih‑alih melakukan renormalisasi diam‑diam. Ketidaksepakatan memicu tinjauan tambahan namun tidak diperlakukan sebagai ketidakpastian dalam semua kasus. Pemantauan melacak drift anggota, latensi, dan hasil badai, dengan bobot diperbarui hanya melalui validasi terkontrol. Peringatan publik tetap berada di bawah proses keputusan meteorologi yang berwenang; ensemble meningkatkan bukti namun tidak secara otomatis mengubah kebijakan peringatan.
Bukti implementasi dan kesiapan operasional
Keputusan produksi memerlukan lebih dari sekadar demonstrasi yang berhasil. Definisikan pengguna yang dituju, lingkungan operasional, input, output, ketergantungan, pemilik, dan konsekuensi dari setiap kegagalan penting. Bangun baseline yang dapat direproduksi dan set evaluasi berversi sebelum penyetelan. Uji kasus biasa, kondisi batas, input yang rusak atau hilang, pergeseran distribusi, kegagalan ketergantungan, penyalahgunaan, serta kelompok atau lingkungan yang paling mungkin kurang terlayani. Ukur kualitas tugas bersama dengan kalibrasi atau ketidakpastian, latensi, throughput, biaya sumber daya, aksesibilitas, privasi, dan keamanan. Catat setiap transformasi dan ambang batas agar peninjau independen dapat mereproduksi hasil dan membedakan bukti dari prototipe yang menarik.
Sebelum peluncuran, tetapkan otoritas untuk rilis, pengecualian, perubahan, rollback, dan pensiun. Gunakan peluncuran bertahap, pertahankan fallback yang aman, dan verifikasi pemantauan dengan kegagalan yang disuntikkan secara sengaja. Telemetri operasional harus mengungkap kualitas input, perilaku output, versi model atau aturan, kesehatan ketergantungan, intervensi manusia, dan hasil yang dikonfirmasi tanpa mengumpulkan data sensitif yang tidak diperlukan. Definisikan ambang batas peringatan dan pemilik respons, kemudian tinjau bukti dunia nyata setelah penyebaran alih‑alih mengasumsikan kinerja offline akan bertahan. Evaluasi kembali setiap kali sumber data, pengguna, model, vendor, kebijakan, perangkat keras, atau tujuan berubah. Sistem yang dipelihara juga memerlukan prosedur pemulihan, pembelajaran insiden, penghapusan dan retensi yang terdokumentasi, serta titik yang jelas di mana sistem harus dinonaktifkan atau diganti.
Pertanyaan yang sering diajukan
Apakah random forest merupakan ensemble?
Ya. Ia menggabungkan banyak pohon keputusan yang diacak, biasanya melalui voting atau rata‑rata.
Dapatkah model identik membentuk ensemble yang berguna?
Mereka dapat jika data pelatihan, inisialisasi, atau sampling menghasilkan kesalahan yang cukup berbeda, namun duplikasi semata tidak menambah manfaat.
Referensi utama