Dasar-dasar AI
Apa Itu Pembelajaran Penguatan Mendalam?

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
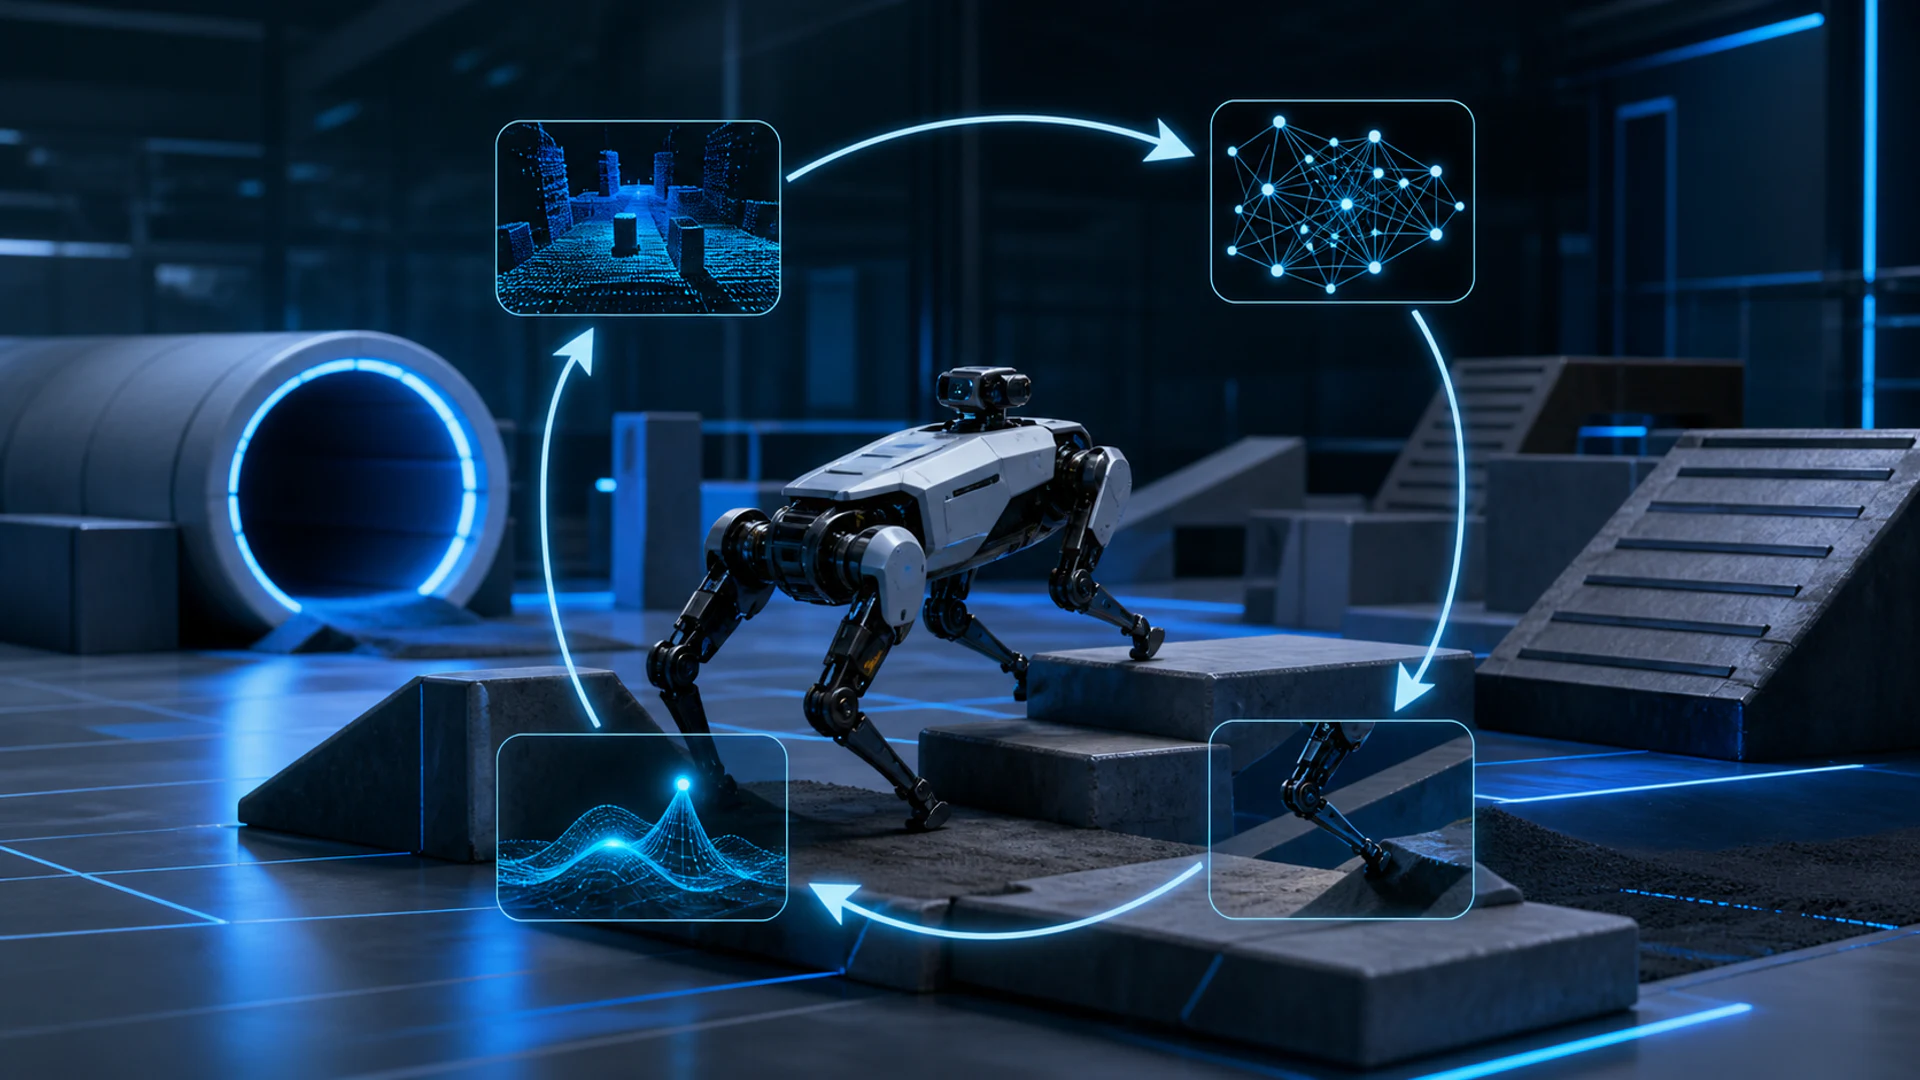
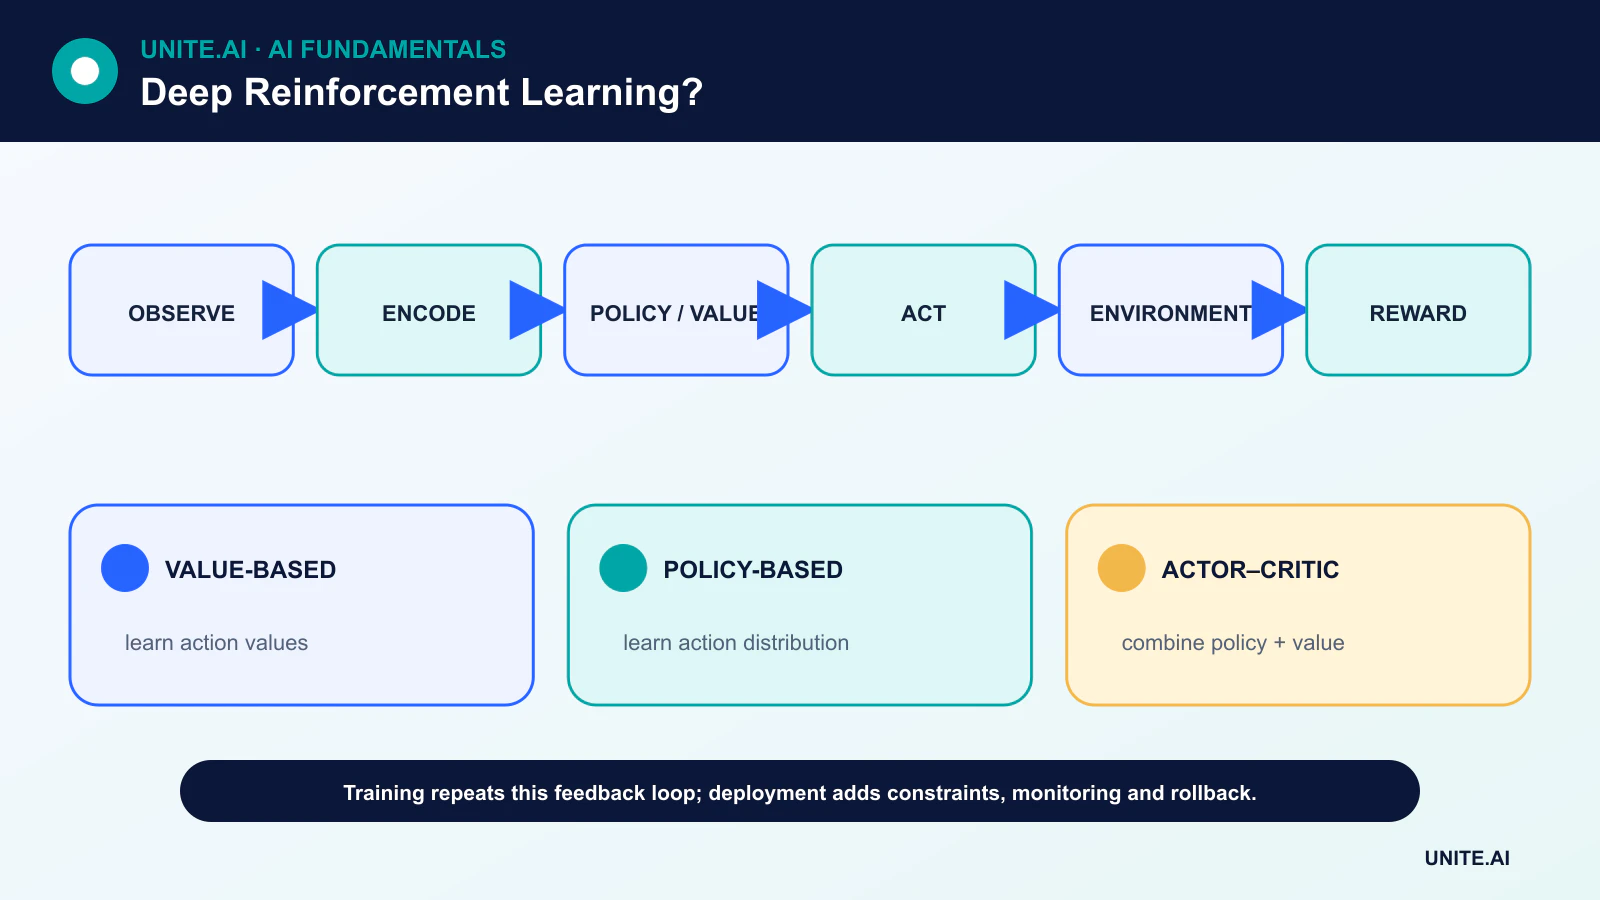
Deep reinforcement learning (deep RL) menggabungkan pembelajaran penguatan dengan jaringan saraf dalam. Agen mengamati sebuah keadaan, memilih sebuah aksi, menerima hadiah dan observasi baru, kemudian menyesuaikan kebijakan atau fungsi nilai untuk memperbaiki keputusan di masa depan.
Jaringan dalam tidak menghilangkan bagian‑bagian sulit dari pembelajaran penguatan. Ia menyediakan cara fleksibel untuk merepresentasikan gambar, aliran sensor, ruang aksi yang besar, atau fungsi nilai yang kompleks. Penjelajahan, kredit yang tertunda, pelatihan yang tidak stabil, dan evaluasi dunia nyata yang aman tetap menjadi masalah teknik utama.
Poin penting
- Deep RL mempelajari keputusan berurutan dari interaksi, bukan dari tabel tetap contoh berlabel.
- Metode berbasis nilai memperkirakan seberapa baik aksi; metode kebijakan belajar distribusi aksi secara langsung; metode aktor‑kritik menggabungkan keduanya.
- Buffer replay, jaringan target, dan perancangan hadiah yang hati‑hati dapat meningkatkan pelatihan, namun tidak ada yang menjamin perilaku yang dapat diandalkan.
- Skor simulator yang tinggi bukan bukti ketahanan, keamanan, atau keberhasilan transfer ke dunia fisik.
Masalah keputusan: keadaan, aksi, dan hadiah
Banyak tugas deep‑RL dimodelkan sebagai proses keputusan Markov. Pada waktu t, agen menerima keadaan atau observasi st, memilih aksi at, kemudian menerima hadiah rt+1 dan keadaan berikutnya. Tujuannya adalah pengembalian terdiskonto yang diharapkan, bukan hanya hadiah selanjutnya saja.
Faktor diskonto mengontrol seberapa kuat hadiah yang jauh dipertimbangkan. Fungsi hadiah menentukan apa yang akan dikejar proses optimisasi, sehingga proksi yang tidak lengkap dapat menghasilkan perilaku yang secara teknis berhasil namun tidak diinginkan secara operasional. Ini salah satu alasan mengapa perancangan hadiah dan pengujian batasan memerlukan perhatian yang sama seperti arsitektur model.
Metode berbasis nilai, berbasis kebijakan, dan aktor‑kritik
Algoritma berbasis nilai memperkirakan nilai keadaan atau nilai aksi. Deep Q‑network menggunakan jaringan saraf untuk mendekati nilai Q dan biasanya memilih aksi dengan perkiraan tertinggi sambil mempertahankan sebagian penjelajahan. Algoritma kebijakan‑gradien sebaliknya mengoptimalkan kebijakan berparameter yang menghasilkan distribusi aksi.
Sistem aktor‑kritik mempertahankan baik aktor, yang mengusulkan aksi, maupun kritikus, yang memperkirakan nilai aksi tersebut. Desain ini mendukung kontrol kontinu namun memperkenalkan sumber kesalahan estimasi yang saling berinteraksi. Oleh karena itu, Deep RL bergantung pada dasar yang sama dengan deep learning, gradient descent, dan backpropagation.
Mengapa buffer replay dan jaringan target membantu
Sampel pengalaman berurutan saling berkorelasi, sementara pembaruan jaringan mengubah target yang digunakan oleh pembaruan selanjutnya. Replay pengalaman memutus sebagian korelasi temporal tersebut dengan mengambil sampel transisi lama. Jaringan target berubah lebih lambat dibandingkan jaringan daring, menjadikan target bootstrapped kurang volatil.
Mekanisme ini meningkatkan stabilitas pelatihan, namun penyetelan tetap penting. Laju belajar, jadwal penjelajahan, skala hadiah, komposisi replay, dan kapasitas jaringan semuanya dapat mengubah hasil. Beberapa seed acak harus dilaporkan karena satu percobaan dapat menyesatkan.
RL offline, RL berbasis model, dan simulasi‑ke‑nyata
RL offline belajar dari dataset tercatat yang tetap tanpa mengumpulkan interaksi baru. Ini dapat berguna ketika penjelajahan mahal atau tidak aman, namun kebijakan harus menghindari aksi yang kurang terwakili dalam log. RL berbasis model belajar atau menggunakan model transisi untuk merencanakan, menukar asumsi tambahan demi efisiensi sampel.
Robotika sering melatih dalam simulasi, mengacak parameter fisik, lalu menyempurnakan atau memvalidasi pada perangkat keras. Celah realitas masih dapat mengungkap kesalahan dalam persepsi, penjadwalan, dinamika kontak, dan kasus tepi yang tidak dimodelkan. Sistem reinforcement‑learning harus dievaluasi di bawah gangguan, pergeseran distribusi, dan batasan keamanan eksplisit.
Evaluasi dan penerapan
Evaluasi yang berguna memisahkan lingkungan pelatihan dan pengujian, melaporkan distribusi pengembalian alih‑alih hanya skor terbaik, serta memeriksa pelanggaran batasan, frekuensi intervensi, dan perilaku terburuk. Untuk sistem nyata, tim juga memerlukan pemantauan, prosedur pemulihan, ruang aksi terbatas, dan intervensi manusia.
Deep RL paling menarik ketika keputusan bersifat berurutan, umpan balik tersedia, dan aturan kontrol yang ditulis tangan tidak memadai. Ini menjadi pilihan yang kurang tepat ketika label terawasi melimpah, optimizer konvensional menyelesaikan masalah, atau penjelajahan dapat menempatkan orang atau aset pada risiko.
Arsitektur Deep RL dan sinyal pelatihan
Pembelajaran penguatan mendalam menggunakan jaringan saraf untuk merepresentasikan fungsi nilai, kebijakan, model lingkungan, atau kombinasi di antaranya. Deep Q‑network memprediksi nilai aksi dan belajar dari target perbedaan temporal; replay pengalaman mengurangi korelasi antar pembaruan, sementara jaringan target menstabilkan tujuan yang berubah‑ubah. Metode kebijakan‑gradien mengoptimalkan pengembalian yang diharapkan secara langsung, dan metode aktor‑kritik menggunakan kritikus yang dipelajari untuk mengurangi variansi gradien. Aksi kontinu sering memerlukan varian aktor‑kritik deterministik atau stokastik, sementara aksi diskrit berdimensi tinggi membutuhkan penjelajahan hati‑hati dan desain keluaran.
Pelatihan bersifat non‑stasioner karena kebijakan mengubah data yang dikumpulkannya. Data replay menjadi off‑policy, target bootstrapped bergantung pada perkiraan saat ini, dan aproksimasi fungsi dapat memperkuat kesalahan—kombinasi yang kadang disebut trilogi mematikan. Estimator ganda mengurangi overestimation nilai; fungsi advantage meningkatkan penetapan kredit; bonus entropi mendorong penjelajahan; tujuan yang terpotong membatasi pembaruan kebijakan yang merusak. Normalisasi observasi dan hadiah hanya dengan keadaan yang aman dari kebocoran, serta catat lingkungan, pembungkus, pengulangan aksi, terminasi, dan pra‑pemrosesan hadiah karena masing‑masing mengubah masalah.
Evaluasi, simulator, dan keamanan penerapan
Laporkan distribusi pengembalian across seed independen dan instance lingkungan, bukan run terbaik. Evaluasi efisiensi sampel, pelanggaran batasan, hasil katastrofik, sensitivitas terhadap skala hadiah, dan ketahanan terhadap noise observasi, penundaan, kesalahan aktuator, serta dinamika yang berubah. Bandingkan dengan kontrol skrip, kontrol klasik, imitasi terawasi, dan RL yang lebih sederhana. Sisihkan variasi lingkungan dan uji metrik hasil tanpa hadiah, karena agen dapat mengeksploitasi hadiah terprogram sambil gagal pada tugas yang dimaksud. Pemeriksaan video dan lintasan sering mengungkap perilaku yang tersembunyi oleh pengembalian agregat.
Simulasi memungkinkan penjelajahan namun memperkenalkan celah realitas. Acak fisika dan persepsi yang relevan, kalibrasi terhadap pengukuran nyata, dan gunakan transfer yang konservatif. Data tercatat atau RL offline menghindari penjelajahan daring tetapi tidak dapat mengevaluasi aksi yang tidak didukung kebijakan perilaku secara dapat diandalkan. Sistem produksi harus membatasi set aksi, laju, sumber daya, dan envelope operasi; memerlukan persetujuan untuk aksi berdampak tinggi; serta menyertakan pengendali aman yang terverifikasi atau penghentian. Pantau masukan kebijakan, distribusi aksi, hadiah, hasil nyata, dan intervensi, dengan rollback ke versi kebijakan yang telah diuji.
Contoh kontrol konkret
Untuk perutean robot gudang, definisikan keadaan dari lokasi, beban, baterai, lalu lintas terdekat, dan antrean tugas; aksi dari pergerakan yang diizinkan dan keputusan pengisian; serta hadiah dari pekerjaan yang selesai, energi, kemacetan, dan batasan keselamatan. Latih pertama di simulator terkalibrasi dengan permintaan acak dan gangguan sensor, lalu bayangkan keputusan nyata. Jangan biarkan kebijakan yang dipelajari melewati penghindaran tabrakan. Evaluasi throughput bersama hampir terjadi tabrakan, deadlock, keadaan darurat baterai, dan keterlambatan terburuk. Proyek berhasil hanya jika sistem berlapis meningkatkan operasi tanpa mentransfer risiko penjelajahan yang tidak dapat diterima kepada orang atau peralatan.
Contoh kerja: DRL untuk pendinginan pusat data
Sebuah pusat data membatasi agen RL pada setpoint pendinginan yang disetujui dan melatihnya dalam simulator yang dikalibrasi dari data cuaca historis, beban kerja, suhu, dan respons peralatan. Hadiah mencakup energi tetapi batasan keras secara terpisah melindungi suhu, kelembapan, dan siklus peralatan. Kontrol prediktif model dan aturan yang ada menjadi baseline. Evaluasi mencakup musim, noise sensor, penundaan aktuator, kehilangan peralatan, beban tidak biasa, dan beberapa seed, melaporkan energi, pelanggaran, variansi, dan pemulihan.
Kebijakan yang dipelajari berjalan dalam mode bayangan sebelum percobaan zona terbatas. Pengendali keselamatan eksternal memotong aksi dan operator dapat mengintervensi. Laju aksi, cakupan keadaan, ketidakpastian model, dan hasil fasilitas nyata dipantau; ketidaksesuaian simulator atau intervensi berulang memicu rollback. Peralatan atau logika kontrol yang diperbarui menciptakan versi lingkungan baru dan validasi. Penghematan energi hanya diterima ketika keandalan, margin termal, pemeliharaan, dan respons terhadap kesalahan tetap setidaknya sekuat baseline.
Bukti implementasi dan kesiapan operasional
Keputusan produksi memerlukan lebih dari sekadar demonstrasi yang berhasil. Tentukan pengguna yang dimaksud, lingkungan operasi, masukan, keluaran, dependensi, pemilik, dan konsekuensi setiap kegagalan penting. Bangun baseline yang dapat direproduksi dan set evaluasi berversi sebelum penyetelan. Uji kasus biasa, kondisi batas, masukan yang rusak atau hilang, pergeseran distribusi, kegagalan dependensi, penyalahgunaan, serta kelompok atau lingkungan yang paling mungkin kurang terlayani. Ukur kualitas tugas bersama kalibrasi atau ketidakpastian, latensi, throughput, biaya sumber daya, aksesibilitas, privasi, dan keamanan. Catat setiap transformasi dan ambang batas sehingga peninjau independen dapat mereproduksi hasil dan membedakan bukti dari prototipe yang menarik.
Sebelum peluncuran, tetapkan otoritas untuk rilis, pengecualian, perubahan, rollback, dan pensiun. Gunakan rollout bertahap, pertahankan fallback yang aman, dan verifikasi pemantauan dengan kegagalan yang disuntikkan secara sengaja. Telemetri operasional harus mengungkap kualitas masukan, perilaku keluaran, versi model atau aturan, kesehatan dependensi, intervensi manusia, dan hasil yang terkonfirmasi tanpa mengumpulkan data sensitif yang tidak diperlukan. Tentukan ambang batas peringatan dan pemilik respons, lalu tinjau bukti dunia nyata setelah penerapan alih‑alih mengasumsikan kinerja offline akan bertahan. Evaluasi kembali setiap kali sumber data, pengguna, model, vendor, kebijakan, perangkat keras, atau tujuan berubah. Sistem yang dipelihara juga memerlukan prosedur pemulihan, pembelajaran insiden, penghapusan dan retensi yang terdokumentasi, serta titik yang jelas di mana sistem harus dinonaktifkan atau diganti.
Pertanyaan yang sering diajukan
Apakah deep reinforcement learning sama dengan deep learning?
Tidak. Deep learning menyediakan aproksimasi fungsi; reinforcement learning menyediakan interaksi, hadiah, dan tujuan keputusan berurutan.
Apakah hadiah yang tinggi berarti agen telah mempelajari perilaku yang dimaksud?
Tidak selalu. Itu berarti kebijakan menemukan perilaku yang memperoleh skor baik berdasarkan hadiah dan lingkungan yang diimplementasikan. Pengujian keamanan independen dan kesesuaian tujuan tetap diperlukan.
Referensi utama