
Dasar-dasar AI
Apa itu Gradient Descent?

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
Gradient descent adalah metode optimasi yang menyesuaikan parameter model untuk mengurangi fungsi objektif. Dalam pelatihan jaringan saraf, objektif tersebut biasanya berupa loss yang dihitung dari contoh-contoh. Gradien menunjukkan arah peningkatan lokal tercuram, sehingga gradient descent mengambil langkah ke arah berlawanan.
Gradien menggambarkan sensitivitas lokal; besarnya tidak secara langsung mengukur seberapa cepat model “belajar.” Kemajuan sebenarnya juga bergantung pada learning rate, kelengkungan, noise, parametrisasi, keadaan optimizer, dan data.
Poin utama
- Backpropagation menghitung gradien, sementara gradient descent menggunakannya untuk memperbarui parameter.
- Optimasi mini-batch adalah pendekatan praktis standar untuk deep learning.
- Learning rate mengontrol skala pembaruan dan dapat mengikuti jadwal alih-alih mengecil setelah setiap langkah.
- Momentum, AdamW, clipping, dan normalisasi menangani berbagai masalah optimasi.
Aturan pembaruan dasar
Untuk vektor parameter θ, learning rate η, dan loss L:
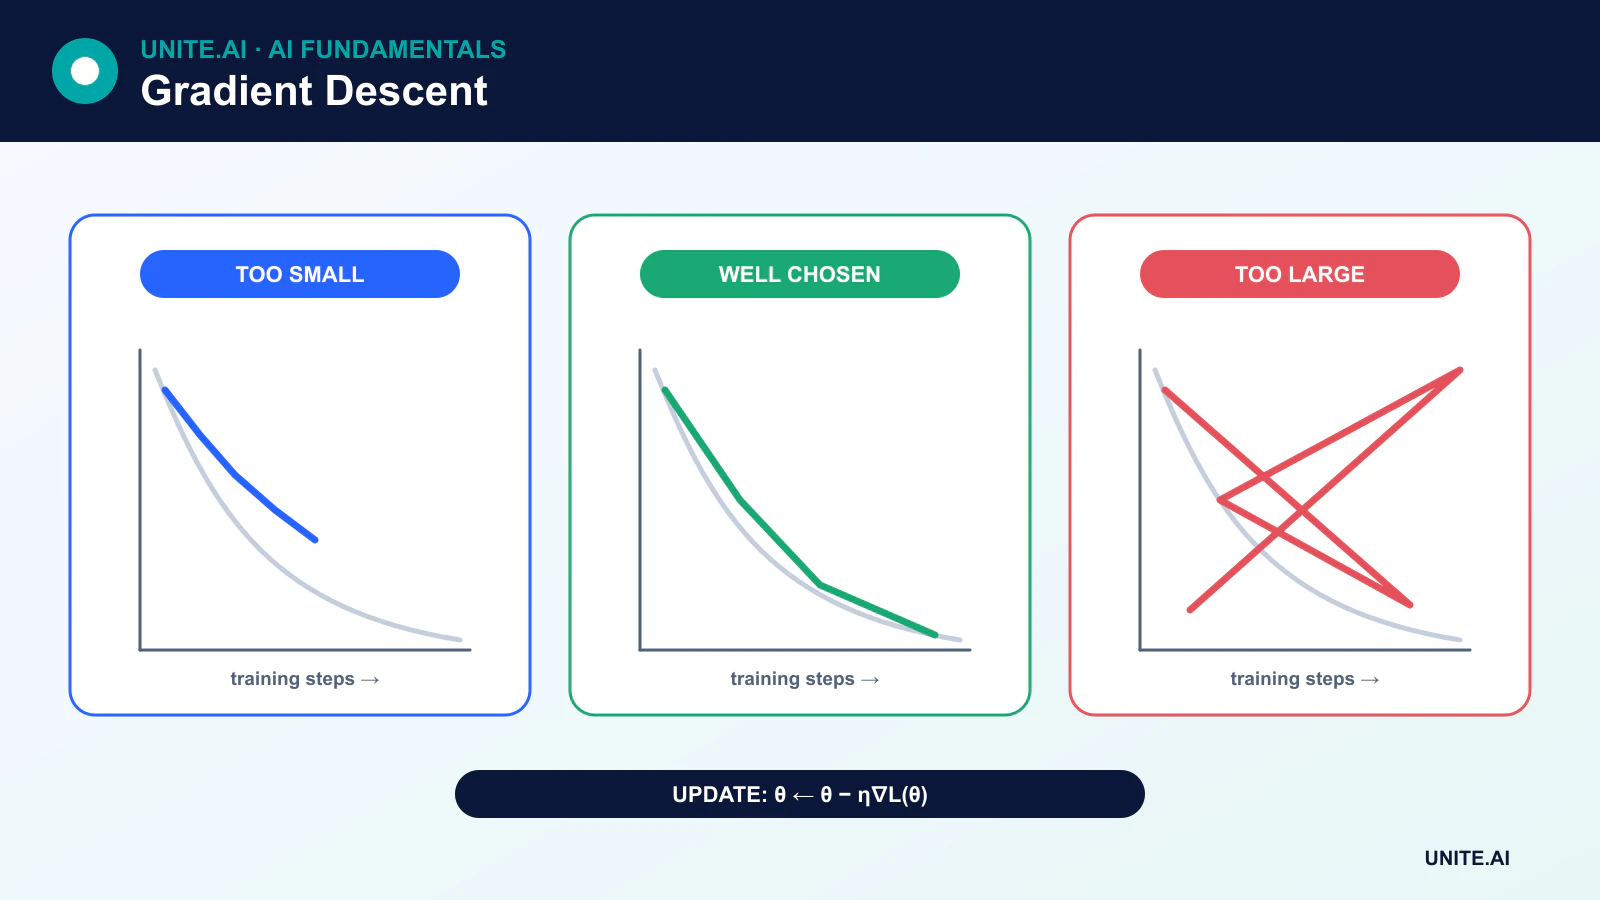
θ ← θ - η∇L(θ)
Gradien ∇L(θ) berisi satu turunan parsial per parameter. Mengurangkannya menggerakkan turun secara lokal. Titik stasioner memiliki gradien nol, namun dapat berupa minimum, maksimum, titik sadel, atau daerah datar. Permukaan loss deep learning bersifat nonkonveks, sehingga pelatihan tidak dijamin menemukan minimum global unik atau loss nol.
Metode batch, stochastic, dan mini-batch
Batch gradient descent
Batch gradient descent menghitung gradien dengan menggunakan seluruh set pelatihan untuk setiap pembaruan. Perkiraannya stabil namun dapat mahal dalam waktu dan memori, serta satu pembaruan mungkin tidak memanfaatkan akselerator modern secara optimal.
Stochastic gradient descent
Stochastic gradient descent yang ketat menggunakan satu contoh yang dipilih secara acak per pembaruan. Gradiennya berisik, yang dapat membantu eksplorasi permukaan loss, namun operasi satu contoh dapat tidak efisien pada perangkat keras paralel.
Mini-batch gradient descent
Pelatihan mini-batch memperkirakan gradien dari subset contoh. Ia menyeimbangkan noise statistik dengan operasi matriks yang efisien dan merupakan pendekatan umum dalam deep learning. Ukuran batch memengaruhi memori, throughput, noise gradien, normalisasi, dan kadang-kadang generalisasi.
Memilih learning rate
Learning rate yang terlalu besar dapat melampaui wilayah yang berguna atau menyebabkan divergensi. Learning rate yang terlalu kecil dapat membuat pelatihan sangat lambat atau terhenti di daerah datar. Skala terbaik bergantung pada optimizer, ukuran batch, model, inisialisasi, dan objektif.
Jadwal dapat melakukan warm-up secara bertahap, menurun pada tonggak tertentu, mengikuti kurva kosinus, atau merespons kemajuan validasi. Learning rate tidak harus selalu mengecil secara monoton setelah setiap pembaruan. Warm restart dan jadwal siklik secara sengaja meningkatkan learning rate pada bagian tertentu pelatihan.
Momentum
Momentum mempertahankan rata‑rata bergerak eksponensial dari gradien masa lalu. Ia dapat mempercepat kemajuan sepanjang arah yang konsisten dan mengurangi osilasi pada arah yang curam dan sempit. Momentum gaya Nesterov mengevaluasi atau memperkirakan gradien setelah melihat ke depan sepanjang arah momentum.
Optimizer adaptif
RMSProp menskalakan pembaruan menggunakan rata‑rata bergerak dari gradien kuadrat. Adam menggabungkan momen pertama mirip momentum dengan skala momen kedua. AdamW memisahkan weight decay dari pembaruan gradien adaptif dan banyak digunakan untuk transformer.
Optimizer adaptif sering mempermudah pelatihan awal, namun tidak secara otomatis lebih unggul untuk setiap model atau target generalisasi akhir. Perbandingan optimizer memerlukan jadwal yang cocok dan penyesuaian yang cermat.
Clipping dan akumulasi gradien
Gradient clipping membatasi norm atau nilai gradien untuk mengurangi dampak gradien yang meledak, terutama pada pelatihan berulang atau tidak stabil. Gradient accumulation menambahkan gradien dari beberapa batch kecil sebelum pembaruan, memperkirakan batch efektif yang lebih besar ketika memori terbatas.
Memantau optimasi
Lacak loss pelatihan dan validasi, metrik tugas, learning rate, norm gradien, norm parameter, dan kesalahan numerik. Penurunan loss pelatihan bersamaan dengan penurunan kinerja validasi menunjukkan overfitting, bukan keberhasilan optimasi yang harus otomatis dilanjutkan.
Optimasi meminimalkan objektif yang diberikan. Loss rendah tidak membuktikan bahwa data, metrik, atau perilaku dunia nyata sesuai. Kebocoran, label yang buruk, dan objektif yang tidak selaras dapat menghasilkan model yang teroptimasi baik namun berbahaya.
Geometri optimasi dan aturan pembaruan
Gradient descent memperbarui parameter berlawanan dengan gradien loss. Full-batch descent menggunakan setiap contoh pelatihan per langkah; stochastic descent menggunakan satu; metode mini-batch memperkirakan gradien dari subset dan mendominasi deep learning. Learning rate menentukan skala langkah. Terlalu kecil membuang komputasi atau terhenti; terlalu besar menyebabkan osilasi atau divergensi. Momentum mengakumulasi arah bergerak, sementara metode adaptif seperti Adam menskalakan koordinat menggunakan momen gradien. Bias implisit yang berbeda dapat menghasilkan model dengan loss pelatihan serupa namun generalisasi yang berbeda.
Permukaan loss pada jaringan saraf mengandung daerah datar dan tajam, titik sadel, simetri, serta arah yang buruk kondisinya. Skala fitur, normalisasi, inisialisasi, residual connection, dan preconditioning mengubah geometri yang dilihat optimizer. Jadwal dapat melakukan warm-up, penurunan, siklus, atau bereaksi terhadap plateau. Weight decay berbeda dari sekadar menambahkan penalti L2 pada beberapa optimizer adaptif. Ukuran batch memengaruhi noise, memori, paralelisme, dan regime learning rate, sehingga perbandingan optimizer memerlukan anggaran pelatihan yang cocok dan penyesuaian yang cermat.
Diagnosa, reproduktifitas, dan penghentian
Lacak loss pelatihan dan validasi, metrik tugas, norm gradien dan parameter, learning rate, throughput, serta peringatan numerik. Divergensi dapat disebabkan oleh batch yang rusak, label tidak valid, presisi campuran yang tidak stabil, atau reduksi loss yang salah. Plateau dapat menandakan kapasitas kurang, aktivasi jenuh, fitur buruk, regularisasi berlebihan, atau masalah jadwal. Overfitting memerlukan data, augmentasi, regularisasi, atau early stopping—bukan klaim bahwa optimizer gagal. Periksa kesalahan representatif dan bandingkan baseline sederhana sebelum meningkatkan kompleksitas pelatihan.
Reproduktifitas memerlukan seed, urutan data, kode, konfigurasi, versi perangkat keras dan perpustakaan, meskipun beberapa kernel akselerator tetap nondeterministik. Simpan checkpoint beserta keadaan optimizer dan scheduler sehingga pelatihan dapat dilanjutkan secara konsisten. Pilih checkpoint berdasarkan kriteria validasi yang ditetapkan sebelumnya dan sisakan set tes yang belum tersentuh. Pada pelatihan terdistribusi, pastikan ukuran batch efektif, rata‑rata gradien, dan penanganan pekerja yang gagal. Optimasi meminimalkan objektif yang dipilih pada data yang tersedia; ia tidak menjamin probabilitas terkalibrasi, penalaran kausal, keadilan, keamanan, atau kegunaan dunia nyata.
Contoh kerja: menyetel optimizer untuk model bahasa
Sebuah tim menetapkan tokenizer, urutan data, model, batch efektif, dan anggaran token pelatihan, kemudian membandingkan SGD dengan momentum dan AdamW pada jadwal learning rate yang dapat dipertanggungjawabkan. Warm-up, decay, weight decay, clipping, dan presisi dicatat. Setiap kandidat dijalankan dengan beberapa seed, dan validasi menggunakan potongan waktu yang disisihkan serta evaluasi tugas. Throughput dan energi dilaporkan bersama loss sehingga optimizer yang sedikit lebih baik tidak dipilih dengan biaya yang tidak proporsional.
Diagnostik mengungkap apakah ketidakstabilan berasal dari satu bagian data, ukuran langkah yang berlebihan, underflow, atau arsitektur model. Checkpoint menyimpan keadaan optimizer dan scheduler dan dilanjutkan pada tes. Pilihan akhir didasarkan pada kualitas dan ketahanan validasi, bukan loss pelatihan terendah. Set tes tertutup dijalankan sekali setelah pemilihan. Inferensi produksi dikalibrasi dan dipantau secara terpisah karena keberhasilan optimizer selama pretraining tidak menjamin perilaku yang aman atau benar.
Bukti implementasi dan kesiapan operasional
Keputusan produksi memerlukan lebih dari sekadar demonstrasi yang berhasil. Tentukan pengguna yang dituju, lingkungan operasional, masukan, keluaran, ketergantungan, pemilik, dan konsekuensi dari setiap kegagalan penting. Bangun baseline yang dapat direproduksi dan set evaluasi berversi sebelum penyetelan. Uji kasus biasa, kondisi batas, masukan yang rusak atau hilang, pergeseran distribusi, kegagalan ketergantungan, penyalahgunaan, serta kelompok atau lingkungan yang paling mungkin kurang terlayani. Ukur kualitas tugas bersama dengan kalibrasi atau ketidakpastian, latensi, throughput, biaya sumber daya, aksesibilitas, privasi, dan keamanan. Catat setiap transformasi dan ambang batas sehingga peninjau independen dapat mereproduksi hasil dan membedakan bukti dari prototipe menarik.
Sebelum peluncuran, tetapkan otoritas untuk rilis, pengecualian, perubahan, rollback, dan pensiun. Gunakan peluncuran bertahap, pertahankan fallback yang aman, dan verifikasi pemantauan dengan kegagalan yang sengaja disuntikkan. Telemetri operasional harus mengungkap kualitas masukan, perilaku keluaran, versi model atau aturan, kesehatan ketergantungan, intervensi manusia, dan hasil yang dikonfirmasi tanpa mengumpulkan data sensitif yang tidak perlu. Tentukan ambang batas peringatan dan pemilik respons, kemudian tinjau bukti dunia nyata setelah penerapan alih-alih mengasumsikan kinerja offline akan bertahan. Evaluasi kembali setiap kali sumber data, pengguna, model, vendor, kebijakan, perangkat keras, atau tujuan berubah. Sistem yang dipelihara juga memerlukan dokumentasi pemulihan, pembelajaran insiden, prosedur penghapusan dan retensi, serta titik yang jelas kapan harus dinonaktifkan atau diganti.
Pertanyaan yang sering diajukan
Apakah gradient descent selalu mencapai minimum global?
Tidak. Untuk objektif konveks, kondisi yang tepat memberikan jaminan kuat. Objektif jaringan dalam bersifat nonkonveks, dan optimizer praktis biasanya mencari solusi yang berguna daripada membuktikan bahwa mereka menemukan minimum global yang unik.
Mengapa gradien nol dapat menyesatkan?
Gradien nol atau sangat kecil dapat menunjukkan minimum, maksimum, titik sadel, saturasi, atau plateau datar. Diagnostik pelatihan harus mempertimbangkan riwayat loss, kelengkungan, skala parameter, dan kinerja validasi.
Referensi utama












