
Dasar-dasar AI
Apa itu Backpropagation?

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
Backpropagation adalah algoritma yang digunakan untuk menghitung bagaimana loss neural network berubah terhadap parameter yang dapat dilatih. Algoritma ini menerapkan aturan rantai kalkulus secara terbalik melalui operasi yang dicatat selama proses forward pass.
Backpropagation menghitung gradien; ia tidak, sendiri, menentukan pembaruan. Optimizer seperti stochastic gradient descent atau AdamW menggunakan gradien tersebut untuk mengubah bobot, bias, dan parameter lain yang dapat dilatih.
Poin penting
- Forward pass membangun nilai perantara dan menghasilkan prediksi.
- Fungsi loss mengubah prediksi dan target menjadi tujuan pelatihan skalar.
- Backpropagation menggunakan turunan lokal dan aturan rantai untuk menghitung gradien parameter secara efisien.
- Kerangka kerja modern mengimplementasikan diferensiasi otomatis mode terbalik pada grafik komputasi.
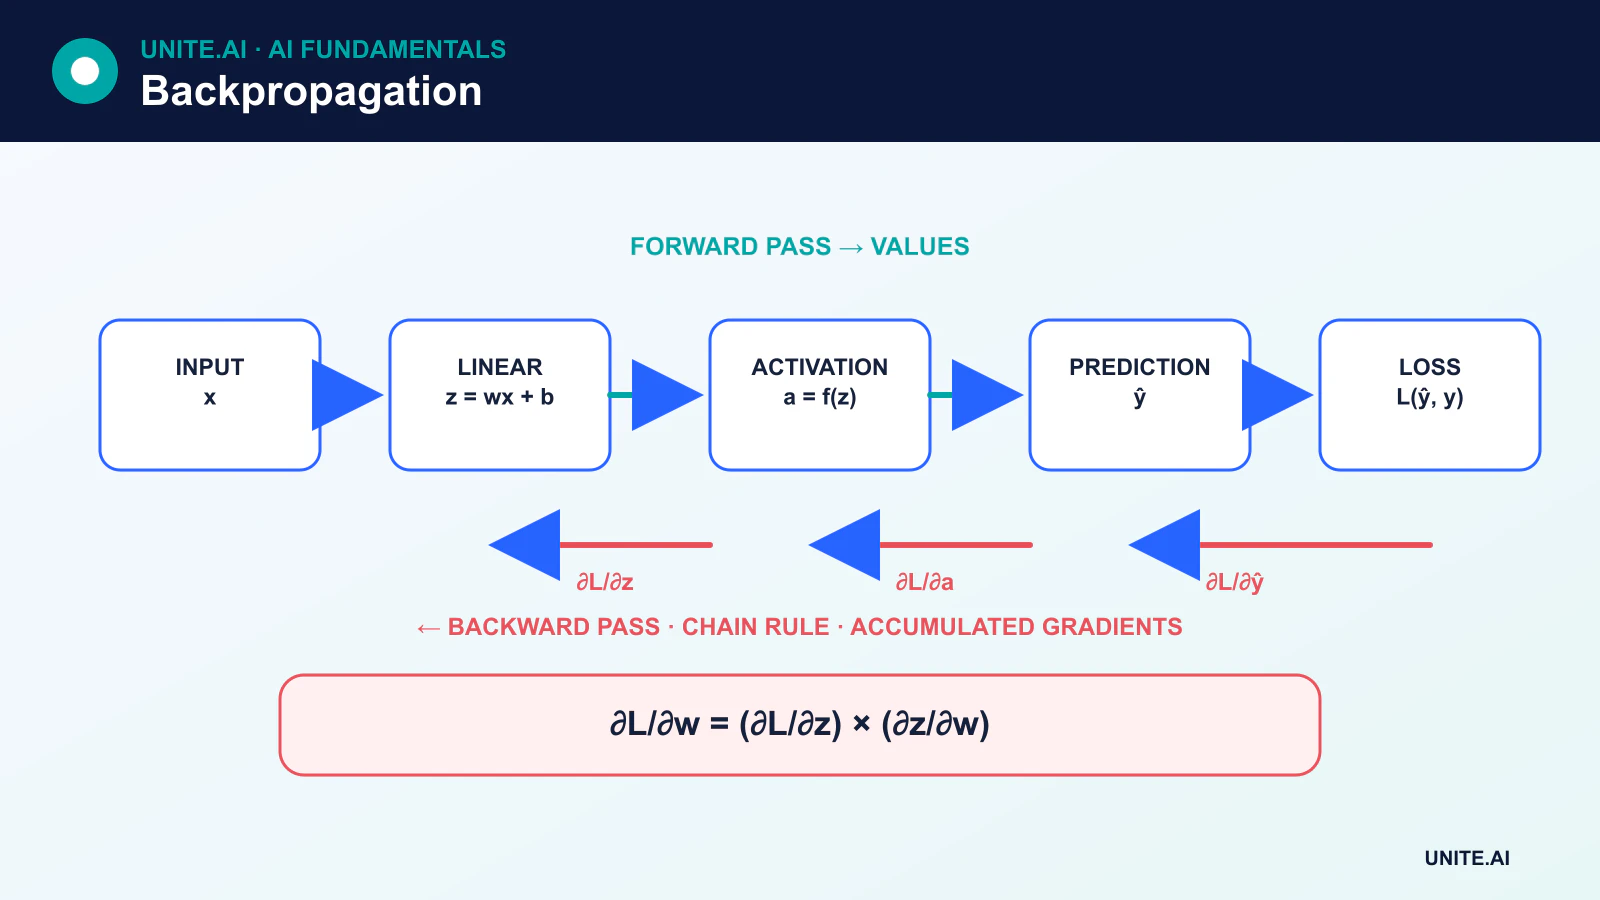
Pass maju
Pertimbangkan unit sederhana:
z = wx + bŷ = activation(z)
Inputnya adalah x, sementara w dan b adalah parameter bobot dan bias yang dapat dilatih. Bias biasanya berubah selama pelatihan sebagaimana bobot. Sebuah jaringan menggabungkan banyak operasi semacam itu, serta normalisasi, attention, konvolusi, koneksi residual, atau blok diferensial lainnya.
Pass maju mengevaluasi operasi tersebut dan menghasilkan prediksi. Loss seperti cross-entropy atau mean squared error mengukur objektif. Loss yang paling tepat bergantung pada tugas dan interpretasi output.
Aturan rantai
Jika loss L bergantung pada nilai perantara z, dan z bergantung pada parameter w, aturan rantai memberikan:
∂L/∂w = (∂L/∂z) × (∂z/∂w)
Jaringan dalam memiliki banyak jalur. Backpropagation menelusuri grafik komputasi secara terbalik, mengakumulasi kontribusi ketika suatu nilai memengaruhi loss melalui lebih dari satu jalur. Hasilnya adalah gradien untuk setiap parameter yang dapat dilatih yang berpartisipasi dalam perhitungan forward.
Contoh numerik kecil
Misalkan ŷ = wx + b, dengan x = 2, w = 3, dan b = 1. Prediksi adalah 7. Jika targetnya 5 dan lossnya L = ½(ŷ - y)², maka:
∂L/∂ŷ = ŷ - y = 2∂ŷ/∂w = x = 2∂L/∂w = 2 × 2 = 4∂L/∂b = 2 × 1 = 2
Optimizer kemudian dapat memindahkan w dan b ke arah gradien negatif. Rumus ini khusus untuk unit linear yang dipilih dan loss squared-error; aturan backpropagation universal adalah aturan rantai pada grafik aktual, bukan satu persamaan “error” tetap.
Backpropagation vs Gradient Descent
Gradient descent adalah metode optimisasi. Backpropagation menyediakan gradien yang dibutuhkan. Langkah pelatihan biasanya berurutan:
- Bersihkan atau reset gradien yang tersimpan.
- Jalankan forward pass.
- Hitung loss.
- Jalankan backward pass.
- Terapkan pembaruan optimizer.
Memisahkan konsep-konsep ini memudahkan pemahaman momentum, AdamW, akumulasi gradien, dan pelatihan mixed-precision.
Diferensiasi otomatis
Kerangka kerja seperti PyTorch mencatat operasi dan membangun grafik selama forward pass. Diferensiasi otomatis mode terbalik kemudian menghitung produk vektor-Jacobian secara efisien dari output kembali ke parameter. Ini lebih umum daripada menulis kode turunan secara manual untuk jaringan tetap dan menjadi dasar bagi kerangka kerja deep learning modern.
Beberapa operasi tidak dapat didiferensiasikan atau memiliki turunan yang tidak stabil. Kerangka kerja mendefinisikan subgradien atau konvensi terdokumentasi dalam kasus tertentu, namun praktisi tetap harus memahami tensor yang terlepas, operasi in-place, dan presisi numerik.
Gradien menghilang dan meledak
Perkalian berulang melalui banyak lapisan atau langkah waktu dapat membuat gradien sangat kecil atau sangat besar. Gradien yang menghilang memperlambat pembelajaran pada lapisan awal; gradien yang meledak mengacaukan pembaruan. Aktivasi keluarga ReLU, inisialisasi hati-hati, koneksi residual, normalisasi, rekuren ber‑gate, dan pemotongan gradien membantu, namun tidak ada yang menjadi solusi universal.
Memeriksa gradien
Pemeriksaan gradien dengan perbedaan hingga membandingkan gradien analitis atau otomatis dengan pendekatan numerik. Metode ini lambat namun berguna untuk debugging operasi khusus. Memantau norma gradien dan mendeteksi nilai NaN atau tak terhingga dapat mengungkap ketidakstabilan selama pelatihan.
Aturan rantai melalui grafik komputasi
Backpropagation secara efisien menghitung gradien loss skalar terhadap setiap parameter yang dapat didiferensiasikan. Forward pass mencatat nilai perantara dalam grafik komputasi. Dimulai dari loss, diferensiasi otomatis mode terbalik menerapkan aturan rantai, mengalikan turunan lokal dan mengakumulasi kontribusi di titik pertemuan jalur. Untuk lapisan y=f(x,w), sensitivitas hulu ke y dikombinasikan dengan turunan parsial untuk menghasilkan sensitivitas terhadap x dan w. Backpropagation menghitung gradien; optimizer yang memutuskan bagaimana parameter berubah.
Sebuah lapisan afine sederhana menghasilkan y=Wx+b. Gradien untuk W adalah produk luar antara gradien hulu dan input, gradien untuk b menjumlahkan nilai hulu, dan gradien input dikalikan dengan matriks bobot yang ditransposisi. Aktivasi menambahkan turunan elemen per elemen. Konvolusi, normalisasi, attention, dan penggunaan kembali pada jaringan berulang mengikuti prinsip grafik yang sama namun memerlukan bentuk tensor yang tepat, broadcasting, masking, dan berbagi parameter. Kerangka kerja membebaskan aktivasi yang disimpan setelah backward kecuali disimpan, sehingga memori sering meningkat seiring batch, kedalaman, dan panjang urutan.
Kegagalan gradien, verifikasi, dan praktik rekayasa
Produk dari banyak turunan dapat menghilang atau meledak. Aktivasi mirip ReLU, inisialisasi hati-hati, normalisasi, koneksi residual, gating, dan pemotongan gradien menangani mekanisme yang berbeda. Aktivasi yang jenuh dan operasi yang tidak dapat didiferensiasikan dapat memblokir sinyal berguna; backpropagation terpotong membatasi sejarah urutan; mixed precision dapat mengalami underflow tanpa skala loss. Gradien yang meledak adalah gejala, sehingga pemotongan harus disertai penyelidikan learning rate, data, arsitektur, dan kesalahan numerik alih-alih menyembunyikannya.
Verifikasi operasi khusus dengan pemeriksaan gradien perbedaan hingga pada input presisi ganda kecil, menghindari titik yang tidak dapat didiferensiasikan. Periksa norma gradien, NaN, parameter tidak aktif, dan apakah gradien mencapai modul yang diharapkan. Bersihkan gradien terakumulasi secara sengaja dan bedakan perilaku pelatihan dari evaluasi untuk dropout dan normalisasi. Checkpointing menghitung ulang aktivasi untuk menghemat memori; pelatihan terdistribusi harus mengakumulasi gradien secara konsisten. Penurunan loss pelatihan menunjukkan bahwa jalur optimisasi ada, bukan bahwa gradien secara konseptual benar, data bebas kebocoran, atau model dapat menggeneralisasi.
Contoh praktis: memverifikasi lapisan neural kustom
Seorang insinyur mengimplementasikan lapisan spektral yang dapat didiferensiasikan untuk jaringan audio. Tes presisi ganda kecil membandingkan gradien otomatis dengan perbedaan hingga pusat pada input dan parameter, mengecualikan titik di mana operasi secara sengaja tidak dapat didiferensiasikan. Bentuk, broadcasting, padding, dan konversi kompleks‑ke‑real mendapat kasus terpisah. Tes memverifikasi akumulasi gradien ketika sebuah parameter digunakan kembali dan memastikan bahwa frame audio yang dimask tidak menghasilkan gradien.
Selama pelatihan, dasbor melacak norma gradien dan aktivasi, NaN, parameter tidak aktif, serta skala loss. Batch yang sengaja rusak mengonfirmasi bahwa validasi menangkap output non‑finite sebelum pembaruan optimizer. Implementasi mixed‑precision dan yang diekspor dibandingkan dengan referensi. Tes resume checkpoint mencakup keadaan optimizer dan urutan acak. Lapisan tidak diterima hanya karena total loss menurun; gradien unit, stabilitas numerik, dan generalisasi hilir harus semua memberikan bukti yang konsisten.
Bukti implementasi dan kesiapan operasional
Keputusan produksi memerlukan lebih dari demonstrasi yang berhasil. Tentukan pengguna yang dimaksud, lingkungan operasi, input, output, dependensi, pemilik, dan konsekuensi tiap kegagalan penting. Bangun baseline yang dapat direproduksi dan set evaluasi ber‑versi sebelum penyetelan. Uji kasus biasa, kondisi batas, input yang rusak atau hilang, pergeseran distribusi, kegagalan dependensi, penyalahgunaan, serta grup atau lingkungan yang paling mungkin terabaikan. Ukur kualitas tugas bersamaan dengan kalibrasi atau ketidakpastian, latensi, throughput, biaya sumber daya, aksesibilitas, privasi, dan keamanan. Catat setiap transformasi dan ambang sehingga peninjau independen dapat mereproduksi hasil dan membedakan bukti dari prototipe menarik.
Sebelum peluncuran, tetapkan otoritas untuk rilis, pengecualian, perubahan, rollback, dan pensiun. Gunakan rollout bertahap, pertahankan fallback aman, dan verifikasi pemantauan dengan kegagalan yang disuntikkan secara sengaja. Telemetri operasional harus mengungkap kualitas input, perilaku output, versi model atau aturan, kesehatan dependensi, intervensi manusia, dan hasil yang terkonfirmasi tanpa mengumpulkan data sensitif yang tidak diperlukan. Tentukan ambang peringatan dan pemilik respons, lalu tinjau bukti dunia nyata setelah penyebaran alih-alih mengasumsikan kinerja offline akan bertahan. Evaluasi kembali setiap kali sumber data, pengguna, model, vendor, kebijakan, perangkat keras, atau tujuan berubah. Sistem yang dipelihara juga memerlukan dokumentasi pemulihan, pembelajaran insiden, prosedur penghapusan dan retensi, serta titik jelas kapan harus dinonaktifkan atau diganti.
Pertanyaan yang sering diajukan
Apakah backpropagation memperbarui bobot?
Backpropagation menghitung gradien. Optimizer menerapkan pembaruan menggunakan gradien tersebut, learning rate‑nya, dan mungkin status seperti momentum atau momen adaptif.
Apakah backpropagation realistis secara biologis?
Backpropagation standar adalah algoritma rekayasa dan tidak diterima sebagai model detail belajar pada otak biologis. Analogi neural historis tidak boleh diperlakukan sebagai kesetaraan biologis.
Referensi utama












