Dasar-dasar AI
Apa Itu Jaringan Saraf?

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
Sebuah jaringan saraf buatan adalah model matematis terparameter yang dibuat dari lapisan operasi yang terhubung. Selama pelatihan, jaringan menyesuaikan parameternya sehingga masukan dipetakan ke keluaran yang berguna. Jaringan saraf dapat memperkirakan hubungan nonlinier yang kompleks dan mempelajari representasi secara langsung dari teks, gambar, audio, deret waktu, dan data lainnya.
Nama ini secara historis terinspirasi oleh neuron biologis, namun jaringan modern adalah sistem rekayasa bukan simulasi realistis otak. Istilah seperti “neuron” dan “pembelajaran” merupakan singkatan yang berguna dan tidak boleh disamakan dengan bukti kognisi menyerupai manusia.
Poin-poin utama
- Neuron menghitung jumlah berbobot, menambahkan bias yang dapat dilatih, dan menerapkan fungsi aktivasi.
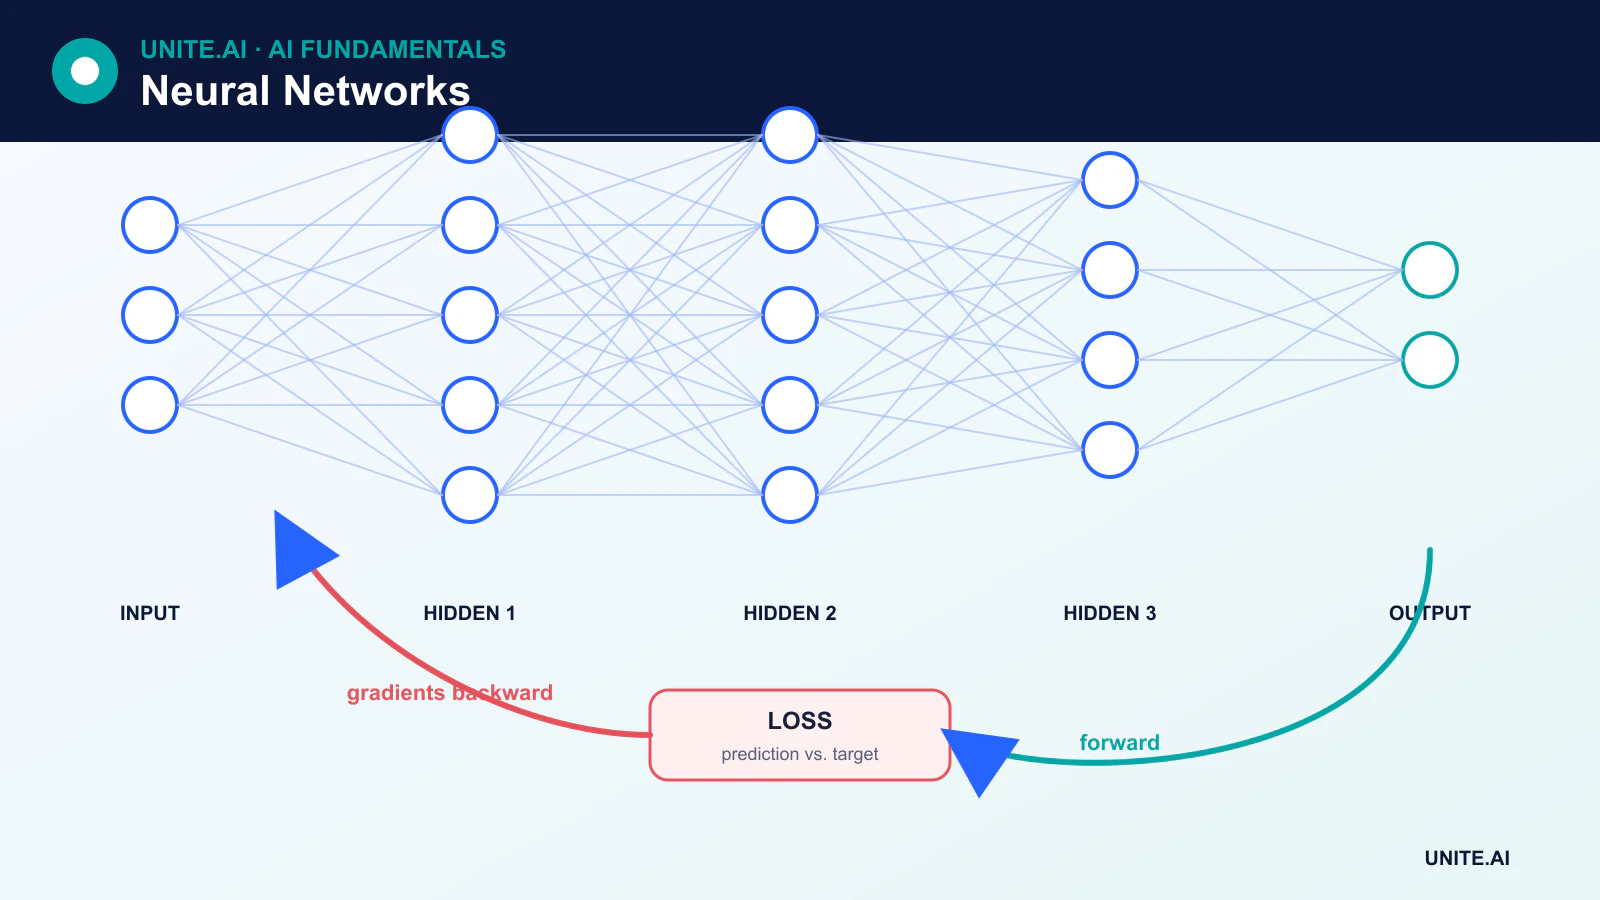
- Pass maju menghasilkan prediksi; fungsi loss mengukur kesalahan; backpropagation menghitung gradien; optimizer memperbarui parameter.
- MLP, CNN, RNN, dan transformer mengatur koneksi secara berbeda.
- Lebih banyak lapisan atau parameter tidak serta merta menghasilkan model yang lebih baik atau lebih dapat dipercaya.
Dari Satu Neuron Buatan ke Jaringan
Untuk vektor masukan x, unit dasar menghitung:
z = Wx + boutput = activation(z)
W berisi bobot yang dapat dilatih dan b adalah bias yang dapat dilatih. Fungsi aktivasi memperkenalkan nonlinieritas. Bobot tidak “melewati” aktivasi secara langsung; aktivasi diterapkan pada jumlah berbobot dan bias.
Sebuah multilayer perceptron (MLP) menumpuk lapisan padat. Lapisan masukan mewakili fitur, lapisan tersembunyi mentransformasikannya, dan lapisan keluaran dirancang untuk tugas—misalnya logit kelas atau nilai regresi.
Bagaimana Jaringan Saraf Belajar
- Model menginisialisasi parameter yang dapat dilatih.
- Pass maju memproses batch dan menghasilkan prediksi.
- Fungsi loss membandingkan prediksi dengan tujuan pelatihan.
- Backpropagation menggunakan aturan rantai untuk menghitung gradien.
- Optimizer seperti stochastic gradient descent atau AdamW memperbarui bobot dan bias.
Backpropagation menjadi pusat pelatihan jaringan saraf melalui pekerjaan yang dikembangkan dan dipopulerkan selama beberapa dekade; itu tidak pertama kali diciptakan pada era deep learning terbaru. Kerangka kerja modern mengimplementasikan diferensiasi otomatis mode terbalik sehingga praktisi tidak perlu menurunkan setiap gradien secara manual.
Mengapa Fungsi Aktivasi Penting
Tanpa aktivasi nonlinier, beberapa lapisan linear biasa akan menyatu menjadi satu transformasi linear. ReLU banyak digunakan karena sederhana dan efisien. GELU dan SiLU umum dalam arsitektur modern. Sigmoid dan softmax tetap berguna untuk interpretasi keluaran tertentu, tetapi sigmoid dapat jenuh pada lapisan tersembunyi dan berkontribusi pada gradien yang menghilang.
Arsitektur Jaringan Saraf Utama
Jaringan Saraf Konvolusional
CNNs menerapkan filter yang dipelajari pada lingkungan lokal dan berbagi parameter di seluruh posisi. Properti ini membuatnya efisien untuk gambar dan sinyal berbentuk grid lainnya.
Jaringan Rekuren
RNNs, LSTMs, dan GRUs memperbarui keadaan tersembunyi sepanjang urutan. Mereka tetap berguna untuk streaming dan tugas deret waktu, meskipun rekursi membatasi pemrosesan paralel dan dapat kesulitan dengan ketergantungan panjang.
Transformers
Transformers menggunakan attention untuk membuat representasi yang bergantung pada konteks. Koneksi residual, normalisasi, informasi posisi, dan blok feed-forward adalah bagian inti arsitektur. Transformers kini menjadi dasar banyak model bahasa besar dan multimodal.
Autoencoder dan Jaringan Generatif
Autoencoders mempelajari representasi melalui rekonstruksi. GANs, model difusi, dan jaringan autoregresif menghasilkan sampel baru menggunakan tujuan dan prosedur pelatihan yang berbeda.
Komponen yang Membuat Jaringan Dalam Dapat Dilatih
Sistem modern menggunakan lebih dari sekadar lapisan dan aktivasi. Koneksi residual memungkinkan informasi dan gradien melewati blok. Normalisasi menstabilkan aktivasi. Regularisasi, augmentasi data, dropout, dan peluruhan bobot dapat mengurangi overfitting. Lapisan embedding memetakan item diskrit seperti token ke vektor. Attention memungkinkan representasi bergantung secara dinamis pada elemen lain.
Kekuatan dan Keterbatasan
Jaringan saraf dapat mempelajari fitur dari data mentah berdimensi tinggi dan skala dengan data serta komputasi. Mereka juga dapat memerlukan dataset besar, perangkat keras khusus, dan penyetelan yang hati-hati. Prediksi mereka mungkin kurang terkalibrasi, rapuh terhadap pergeseran distribusi, rentan terhadap manipulasi adversarial, atau sulit dijelaskan.
Arsitektur harus mengikuti tugas dan batasan penyebaran. Untuk banyak masalah tabular, ensemble pohon atau model linear dapat lebih cepat dan lebih mudah divalidasi. Untuk aplikasi dengan risiko tinggi, kinerja model harus dievaluasi per subgrup dan mode kegagalan, bukan hanya berdasarkan benchmark agregat.
Lapisan, Aktivasi, dan Aliran Informasi
Sebuah jaringan saraf menyusun fungsi-fungsi terparameter. Setiap unit membentuk kombinasi berbobot dari masukan, menambahkan bias, dan melewatkan hasil melalui aktivasi seperti ReLU, sigmoid, tanh, atau GELU. Menumpuk lapisan memungkinkan fitur hierarkis dan batas keputusan nonlinier. Lebar mengontrol unit per lapisan; kedalaman mengontrol transformasi berurutan; konektivitas dan berbagi bobot mengkodekan arsitektur. Output jaringan bergantung pada pra-pemrosesan, parameter, normalisasi, dan mode inferensi secara bersamaan. Neuron adalah operasi matematis, bukan neuron biologis literal atau konsep yang bermakna secara independen.
Propagasi maju menghitung prediksi; loss mengkuantifikasi kesalahan; backpropagation menerapkan aturan rantai pada gradien; optimizer memperbarui parameter. Inisialisasi, laju belajar, statistik batch, jalur residual, dan normalisasi memengaruhi apakah gradien menghilang, meledak, atau tetap berguna. Regularisasi mencakup peluruhan bobot, dropout, augmentasi, early stopping, dan batasan arsitektural. Plot perilaku pelatihan dan validasi, inspeksi statistik gradien dan aktivasi, serta bandingkan percobaan berulang. Jaringan besar dapat menghafal data pelatihan, sementara yang kecil dapat underfit atau melewatkan struktur yang diperlukan.
Pemilihan Arsitektur, Evaluasi, dan Penyebaran
Multilayer perceptron memproses vektor tetap; jaringan konvolusional memanfaatkan struktur lokal; model rekuren dan state-space memproses urutan; transformer menggunakan attention; jaringan graf menukar informasi sepanjang tepi. Hibrida umum. Pilih berdasarkan bias induktif, data, ukuran urutan atau gambar, latensi, memori, interpretabilitas, dan perangkat keras yang tersedia. Evaluasi terhadap baseline linear atau pohon dan lakukan ablasi untuk mengetahui kompleksitas mana yang penting. Jumlah parameter saja tidak memprediksi kualitas, biaya inferensi, atau kebutuhan data.
Penyajian memerlukan pra-pemrosesan beku, grafik yang diekspor atau dikompilasi, validasi numerik, dan pengujian sumber daya pada beban realistis. Kuantisasi dan pemangkasan dapat mengurangi ukuran tetapi mungkin mengubah perilaku kelas langka. Pantau masukan, keluaran, kalibrasi, latensi, dan hasil yang terkonfirmasi; uji data adversarial dan yang bergeser. Lindungi model, dependensi, dan data melalui artefak yang ditandatangani, kontrol akses, dan tinjauan rantai pasokan. Penjelasan dari aktivasi individu atau saliency memerlukan verifikasi kausal dan perilaku. Jaringan saraf adalah aproksimator fungsi yang fleksibel, bukan jaminan pemahaman, kebenaran, atau ketahanan.
Contoh Praktis: Peramal Permintaan Berbasis Jaringan Saraf
Seorang retailer memprediksi permintaan mingguan barang dari penjualan, promosi, harga, libur, ketersediaan, dan cuaca. Jaringan dibandingkan dengan baseline seasonal‑naive, linear, dan pohon menggunakan pembagian waktu bergulir. Promosi masa depan hanya dimasukkan ketika benar‑benar diketahui pada waktu peramalan, sementara stockout dimodelkan karena penjualan yang teramati dapat meremehkan permintaan. Evaluasi menggunakan weighted absolute error, bias, cakupan interval, dan hasil berdasarkan kecepatan barang serta toko.
Pipeline penyajian versi fitur ketersediaan, model, dan horizon dan menolak perkiraan ketika masukan yang diperlukan sudah usang. Perencana melihat interval dan dapat mengganti dengan alasan tercatat. Pemantauan mendeteksi feed yang hilang, perubahan error, bias, dan perkiraan tidak biasa; hasil bisnis dipisahkan dari akurasi perkiraan karena kebijakan pemesanan juga memengaruhi inventaris. Pembaruan model di‑shadow selama beberapa siklus, dan peramal sebelumnya tetap tersedia untuk rollback selama gangguan musiman atau pemasok.
Bukti Implementasi dan Kesiapan Operasional
Keputusan produksi memerlukan lebih dari demonstrasi yang berhasil. Definisikan pengguna yang dimaksud, lingkungan operasi, masukan, keluaran, dependensi, pemilik, dan konsekuensi dari setiap kegagalan penting. Bangun baseline yang dapat direproduksi dan set evaluasi berversi sebelum penyetelan. Uji kasus biasa, kondisi batas, masukan yang rusak atau hilang, pergeseran distribusi, kegagalan dependensi, penyalahgunaan, serta kelompok atau lingkungan yang paling mungkin kurang terlayani. Ukur kualitas tugas bersama kalibrasi atau ketidakpastian, latensi, throughput, biaya sumber daya, aksesibilitas, privasi, dan keamanan. Catat setiap transformasi dan ambang sehingga peninjau independen dapat mereproduksi hasil dan membedakan bukti dari prototipe menarik.
Sebelum peluncuran, tugaskan otoritas untuk rilis, pengecualian, perubahan, rollback, dan pensiun. Gunakan peluncuran bertahap, pertahankan fallback aman, dan verifikasi pemantauan dengan kegagalan yang disuntikkan secara sengaja. Telemetri operasional harus mengungkap kualitas masukan, perilaku keluaran, versi model atau aturan, kesehatan dependensi, intervensi manusia, dan hasil yang terkonfirmasi tanpa mengumpulkan data sensitif yang tidak diperlukan. Tentukan ambang peringatan dan pemilik respons, kemudian tinjau bukti dunia nyata setelah penyebaran alih-alih mengasumsikan kinerja offline akan bertahan. Evaluasi kembali setiap kali sumber data, pengguna, model, vendor, kebijakan, perangkat keras, atau tujuan berubah. Sistem yang dipelihara juga memerlukan dokumentasi pemulihan, pembelajaran insiden, prosedur penghapusan dan retensi, serta titik jelas kapan harus dinonaktifkan atau diganti.
Pertanyaan yang Sering Diajukan
Apakah setiap jaringan saraf termasuk deep learning?
Tidak. Jaringan kecil dengan satu lapisan tersembunyi adalah jaringan saraf, sementara deep learning umumnya merujuk pada arsitektur dengan banyak tahapan pemrosesan yang dipelajari. Batasannya konvensional, bukan ambang ilmiah yang ketat.
Apakah jaringan saraf menyimpan data pelatihannya?
Mereka menyimpan parameter yang dipelajari, bukan salinan dataset yang dapat dicari secara biasa. Namun, model besar dapat menghafal dan menghasilkan contoh pelatihan individu, yang menimbulkan risiko privasi dan hak cipta yang harus diuji.
Referensi Utama